

深入解析Node.js非阻塞IO与事件循环机制
本文解析Node.js轻量高效的核心机制,重点阐述非阻塞IO模型如何避免线程资源浪费,以及事件循环如何通过调用栈、消息队列和回调函数协同工作。结合代码示例与架构图,说明Node.js利用底层线程池处理高并发请求的优势与原理。
Node.js非阻塞IO与事件循环概述
学习并使用Node.js开发已有两个月,期间利用Express结合Mongoose构建了一个Web应用及一套RESTful API。回顾Node.js官网首页的描述:Node.js采用事件驱动、非阻塞IO模型,使其具备轻量且高效的特性。这里的“非阻塞IO模型”具体指代什么含义?
非阻塞IO模型原理
非阻塞IO模型解析
IO操作通常耗时较长。当服务器处理大量请求时,若为每个请求创建独立的进程或线程,将显著增加内存开销并消耗大量时间资源。
鉴于Node.js的事件驱动特性,它通过事件循环机制来解决IO操作带来的性能瓶颈。在Node.js中,IO操作通常关联一个回调函数;当IO操作完成并返回结果时,系统会调用该回调函数,而主线程无需等待,可继续执行后续代码。以下通过一个具体示例说明这一机制:
request('http://www.google.com', function(error, response, body) {
   console.log(body);
});

console.log('Done!');
这段代码向'http://www.google.com'发起请求,并在请求返回时调用回调函数以输出响应信息。基于Node.js的运行机制,代码执行后会立即在控制台打印'Done!',随后在一段时间后才输出响应数据。
事件循环机制详解
事件循环机制
接下来探讨事件循环的具体工作原理。首先需理解调用栈的概念,参考以下代码片段:
function A(arg, func){
  var a = arg;

  func();
  console.log('A');
}

function B(){
  console.log('B');
}

A(0, B);
代码执行后,函数A首先被压入调用栈成为栈顶元素并开始执行。在A的执行过程中,函数B被压入调用栈成为新的栈顶元素。B执行完毕后,从调用栈弹出,A重新成为栈顶元素。A执行结束后,从调用栈弹出,此时调用栈处于空闲状态。
JavaScript运行时环境包含一个消息队列,每条消息与特定的回调函数相关联。当某个事件被触发且存在对应的回调函数时,该事件消息会被加入消息队列。
回到事件循环的核心:代码执行后,函数不断被压入调用栈。以前面的请求为例,request函数被压入调用栈,该函数发起HTTP请求(由Node.js底层模块实现),并将请求完成事件与回调函数关联。随后request从调用栈弹出,console.log被压入调用栈并执行。当请求完成时,触发完成事件,一条消息被加入消息队列。消息队列会检查调用栈是否空闲;若调用栈不空闲,则持续等待直至其空闲,然后将消息队列头部的消息弹出,执行与该消息关联的回调函数。
Node.js高并发优势分析
总结
上述内容从概念层面总结了非阻塞模型和事件循环。值得注意的是,事件循环机制并非Node.js独有,且Node.js采用单线程执行代码。在面对大量并发请求时,它具备哪些优势?
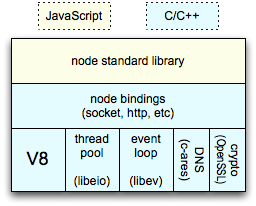
上图展示了Node.js的架构图。Node.js底层包含一个负责维护线程池的模块。当发出IO请求时,底层模块会新建线程处理该请求,完成后将结果交还给上层。面对多个请求,底层模块利用尽可能少的线程完成最多任务;若有空闲线程,则继续处理其他事务。相较于为每个请求开启新进程或线程的方式,这种机制显然更为“智能”且高效。
本文是对Node.js学习过程的总结,文中如有疏漏或错误,欢迎批评指正。
在 NestJS 中使用管道验证数据与守卫控制访问权限
2026-11-05 12:43:41
Node.js后端生成高强度随机字符串的方法
2026-11-04 16:29:54
Node.js环境中怎么使用axios或http模块发送GET请求
2026-11-03 21:57:15
Node.js环境下怎么实现JS反混淆自动化?常用库与CLI工具推荐
2026-11-03 21:15:54
解决JS逆向常见报错:缺少DOM环境导致代码运行失败
2026-11-03 20:41:59