

JavaScript 转义字符与 JSON.parse 解析差异分析
本文深入探讨 JavaScript 中 JSON.parse 与原生字符串解析在转义字符处理上的差异。通过实验不同数量的反斜杠,揭示 JSON 对非法转义严格报错而 JS 忽略转义的特性。结合 V8 引擎源码分析 ScanString 函数,解释为何 \h 等非法转义在 JS 中有效却在 JSON 中报错,帮助开发者避免此类隐蔽 Bug。
JSON 字符串转换为 JavaScript 对象
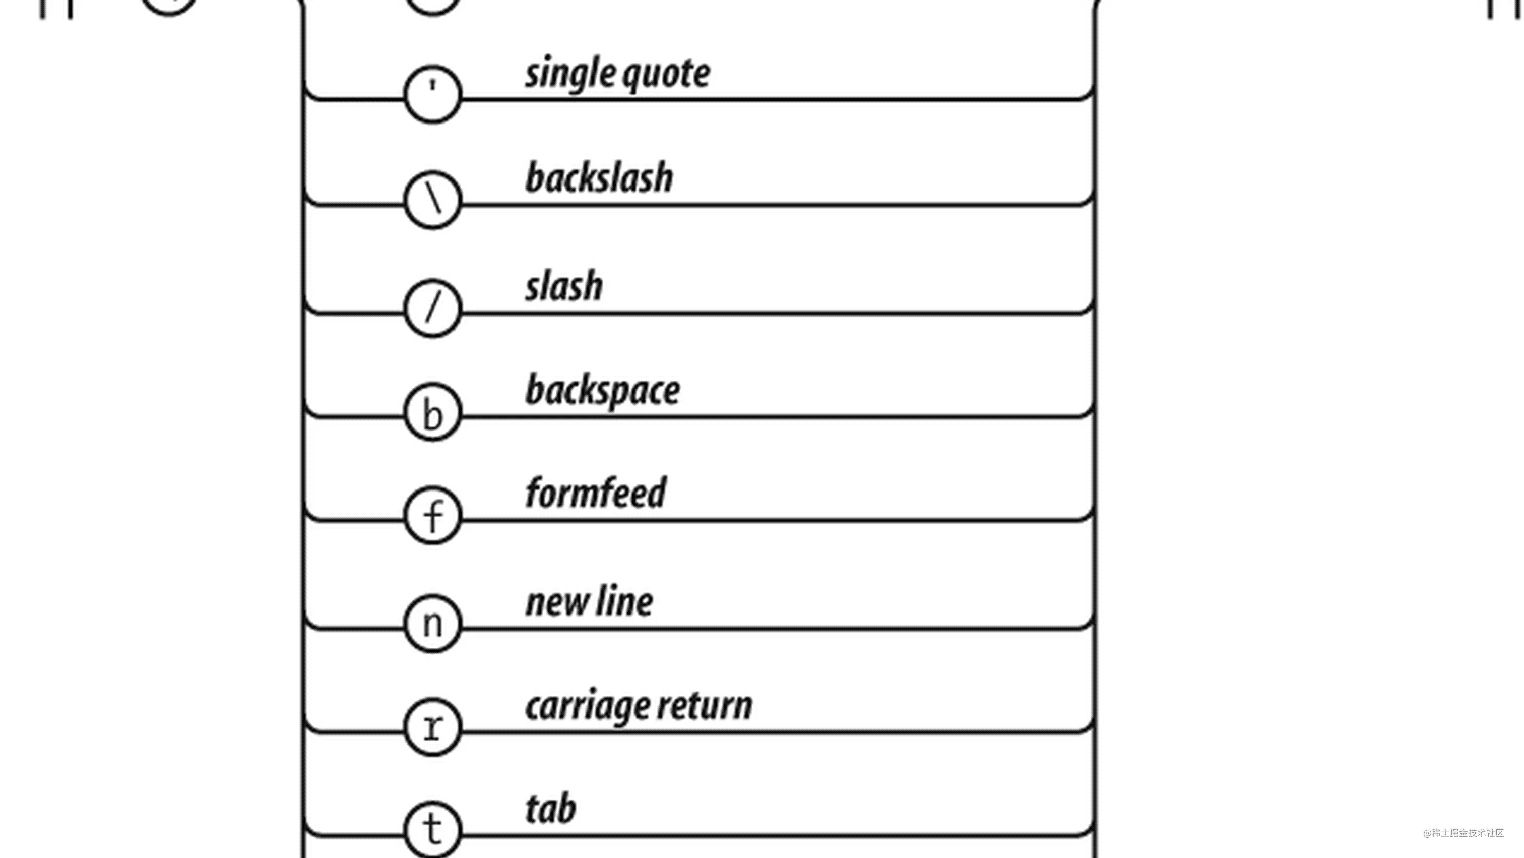
JSON.parse 函数的作用是将符合 JSON 格式的字符串解析并转换为对应的 JavaScript 对象。
JSON.parse('{"hello":"\world"}')
上述代码执行后的输出结果如下:
{ hello: "world" }
这确实是一个合法的 JavaScript 对象。但仔细观察可以发现,字符串中的 "\world" 在转换后变成了 "world",反斜杠被自动移除。
接下来我们尝试运行以下代码进行验证:
JSON.parse('{"hello":"\\world"}')
此时程序会抛出异常:
VM376:1 Uncaught SyntaxError: Unexpected token w in JSON at position 11 at JSON.parse (<anonymous>) at <anonymous>:1:6
错误信息提示为 Unexpected token w(意外的令牌 w)。
出于好奇,我们继续测试增加反斜杠的情况,尝试使用 3 个反斜杠:
JSON.parse('{"hello":"\\\world"}')
运行结果如下:
VM16590:1 Uncaught SyntaxError: Unexpected token w in JSON at position 11 at JSON.parse (<anonymous>) at <anonymous>:1:6
继续测试,尝试使用 4 个反斜杠:
JSON.parse('{"hello":"\\\\world"}')
此时结果正常输出:
{ hello: "\world" }
- 1个,"world"
- 2个,Error
- 3个,Error
- 4个,"\world"
- 5个,"\world"
- 6个,Error
- 7个,Error
- 8个,"\\world"
- 。。。
为了进一步排查问题,我们换一种思路,去掉 JSON.parse 调用,直接输出 JavaScript 字符串本身:
> 'hello'
"hello"
> '\hello'
"hello"
> '\\hello'
"\hello"
> '\\\hello'
"\hello"
> '\\\\hello'
"\\hello"
问题原因大致已经找到。
将上述发现的规则应用到之前的 JSON.parse 代码中,即可解决该问题。
我们需要了解 JSON 字符串的具体解析规则:
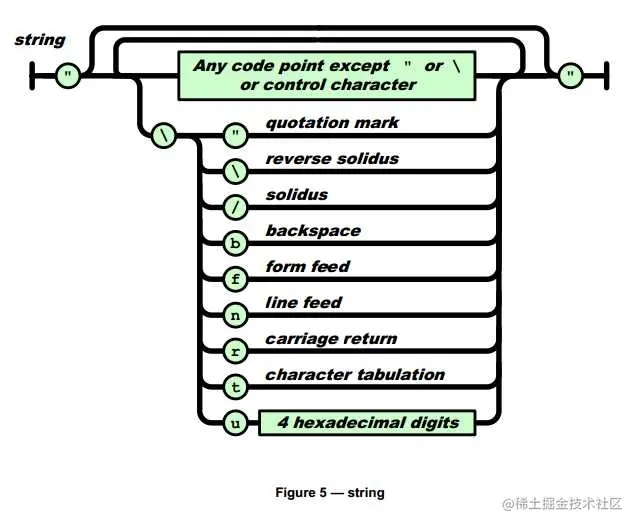
根据该规则,我们来解析字符串 "\hello"。第 1 个字符是反斜杠(\),因此需要进入引号后的最下方分支(图中红线标注部分):
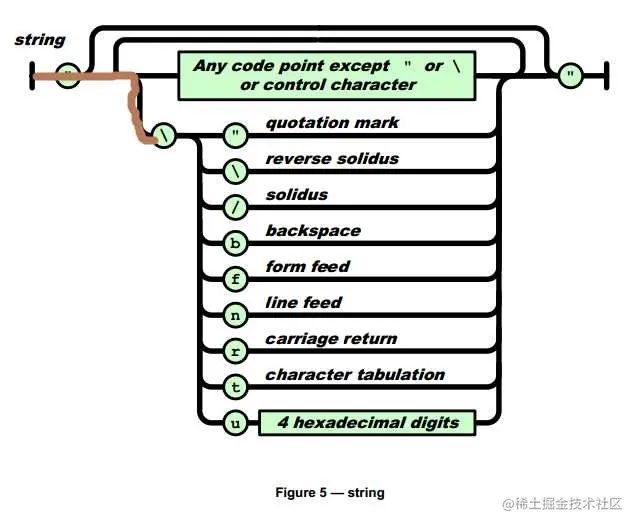
第 2 个字符是 h,但反斜杠后仅定义了 9 种合法的转义路径,h 不属于其中任何一条,因此被视为非法字符。
不仅在 JSON 中,在许多其他编程语言中也会抛出类似 Error:(7, 27) Illegal escape: '\h' 的错误。
然而,JavaScript 却允许解析这种非法转义字符,其解决方式相当直接:直接忽略转义符号,将其视为普通字符。
在 ECMAScript 规范中未找到具体章节说明,因此我们查看 V8 引擎的具体实现。
引擎在读取 JavaScript 源码后首先进行词法分析,文件 /src/parsing/scanner.cc 负责读取源码并解析(当前最新版 6.4.286)。
找到 Scanner::Scan() 函数的关键代码:
case '"':
case '\'':
  token = ScanString();
break;
这是一个很长的 switch 语句:如果遇到双引号(")、单引号(')则调用 ScanString() 函数。
简单解释下:以上代码是 C++ 代码,在 C++ 中单引号是字符,双引号是字符串。所以表示字符时,双引号不需要转义,但是单引号需要转义;而表示字符串时,正好相反。此处的 C++ 转义并不是我们今天要研究的转义。
ScanString() 函数
在 ScanString() 函数中我们也只看重点代码:
while (c0_ != quote && c0_ != kEndOfInput && !IsLineTerminator(c0_)) {
  uc32 c = c0_;
  Advance();
  if (c == '\\') {
    if (c0_ == kEndOfInput || !ScanEscape<false, false>()) {
      return Token::ILLEGAL;
    }
  } else {
    AddLiteralChar(c);
  }
}
if (c0_ != quote) return Token::ILLEGAL;
literal.Complete();
如果已经到了末尾,或者下 1 个字符是不能转义的字符,则返回 Token::ILLEGAL。那么我们看看 ScanEscape 是不是返回了 false 呢?
template <bool capture_raw, bool in_template_literal>
bool Scanner::ScanEscape() {
  uc32 c = c0_;
  Advance<capture_raw>();
  // Skip escaped newlines.
  if (!in_template_literal && c0_ != kEndOfInput && IsLineTerminator(c)) {
    // Allow escaped CR+LF newlines in multiline string literals.
    if (IsCarriageReturn(c) && IsLineFeed(c0_)) Advance<capture_raw>();
    return true;
  }
  switch (c) {
    case '\'':  // fall through
    case '"' :  // fall through
    case '\\': break;
    case 'b' : c = '\b'; break;
    case 'f' : c = '\f'; break;
    case 'n' : c = '\n'; break;
    case 'r' : c = '\r'; break;
    case 't' : c = '\t'; break;
    case 'u' : {
      c = ScanUnicodeEscape<capture_raw>();
      if (c < 0) return false;
      break;
    }
    case 'v':
      c = '\v';
      break;
    case 'x': {
      c = ScanHexNumber<capture_raw>(2);
      if (c < 0) return false;
      break;
    }
    case '0':  // Fall through.
    case '1':  // fall through
    case '2':  // fall through
    case '3':  // fall through
    case '4':  // fall through
    case '5':  // fall through
    case '6':  // fall through
    case '7':
      c = ScanOctalEscape<capture_raw>(c, 2);
      break;
  }
  // Other escaped characters are interpreted as their non-escaped version.
  AddLiteralChar(c);
  return true;
}
这个函数只有 2 处返回了 false。
1、如果转义字符后面是 u,u 后面不是 Unicode 字符时,返回 false
2、如果转义字符后面是 x,x 后面不是十六进制数字时,返回 false
也就是说:'\u'、'\uhello'、'\u1'、'\x'、'\xx' 都抛出异常。
Uncaught SyntaxError: Invalid Unicode escape sequence
或
Uncaught SyntaxError: Invalid hexadecimal escape sequence
而其它非转义字符,都直接执行了后面的代码:
AddLiteralChar(c);
return true;
前面的注释也说明了这一点:
Other escaped characters are interpreted as their non-escaped version.
其他转义字符被解释为对应的非转义版本。
综上,问题的根源就是 JavaScript 和 JSON 对转义字符的处理方式不同,导致了难以发现的 bug。JSON 遇到不能转义的字符直接抛出异常,而 JavaScript 遇到不能转义的字符直接解释为对应的非转义版本。
以上就是JavaScript 转义字符JSON parse错误研究的详细内容,更多关于JavaScript JSON parse错误的资料请关注本站其它相关文章!
JavaScript入门书籍避坑:这些书不适合初学者
2026-11-05 16:31:15
JS使用Math.round实现保留两位小数的原理与代码
2026-11-05 15:35:55
JavaScript 原生 Date 对象怎么实现日期加减
2026-11-05 14:30:00
JavaScript函数定义的三种方式:声明、表达式与箭头函数
2026-11-05 13:50:55
JavaScript中escape、encodeURI和encodeURIComponent对空格的处理差异
2026-11-05 12:47:23
相关标签: