

JS字符串转GBK编码超精简实现详解
本文详解如何在JavaScript中将字符串转换为GBK编码。针对TextEncoder无法指定字集的问题,提出通过遍历GBK字符范围构建映射表的方法。该方案仅需几十行代码和几百字节体积,无需引入iconv等重型第三方库,即可在浏览器端高效完成GBK编码转换,并处理了ASCII字符及特殊符号如欧元符号的情况。
前言
在 JavaScript 中将 GBK 编码的字节流还原为字符串十分便捷,直接调用 TextDecoder 即可完成解码操作。
const gbkBuf = new Uint8Array([196, 227,   186, 195,   49, 50, 51])
new TextDecoder('gbk').decode(gbkBuf)   // "你好123"
然而,逆向过程即字符串转 GBK 编码则较为复杂,因为 TextEncoder 默认仅支持将字符串转换为 UTF-8 编码的二进制数据,无法直接指定 GBK 字集。
目前业界主流方案多依赖第三方编码库(如 iconv)。这类库通常包含庞大的字集数据,即便精简版如 iconv-lite 体积也达数百 kB,在浏览器环境中显得过于臃肿。我们的目标是仅用几百字节即可实现该功能。
遍历
经查阅,GBK 字符集仅包含两万余个字符,最直观的方法是「暴力穷举」。利用 TextDecoder 可遍历生成每个 GBK 编码对应的 JavaScript 字符,后续编码过程即转化为简单的查表操作。
实际上,GBK 的编码范围具有明确的规律性:
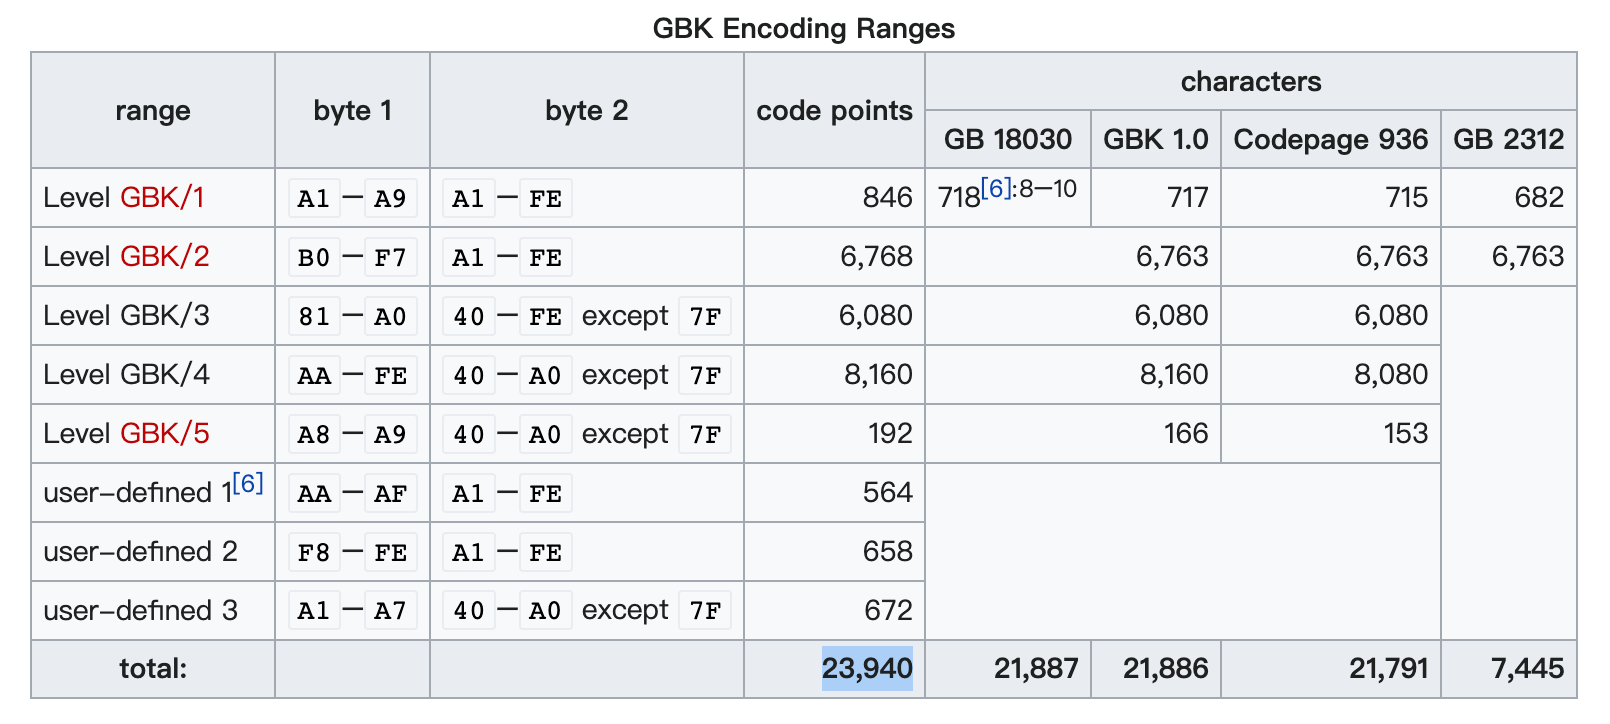
https://en.wikipedia.org/wiki/GBK_(character_encoding)#Encoding
因此,只需在预定义的范围内进行遍历,即便增加十几行代码以提升性能,也是值得投入的。
const ranges = [
  [0xA1, 0xA9,  0xA1, 0xFE],
  [0xB0, 0xF7,  0xA1, 0xFE],
  [0x81, 0xA0,  0x40, 0xFE],
  [0xAA, 0xFE,  0x40, 0xA0],
  [0xA8, 0xA9,  0x40, 0xA0],
  [0xAA, 0xAF,  0xA1, 0xFE],
  [0xF8, 0xFE,  0xA1, 0xFE],
  [0xA1, 0xA7,  0x40, 0xA0],
]
const codes = new Uint16Array(23940)
let i = 0

for (const [b1Begin, b1End, b2Begin, b2End] of ranges) {
  for (let b2 = b2Begin; b2 <= b2End; b2++) {
    if (b2 !== 0x7F) {
      for (let b1 = b1Begin; b1 <= b1End; b1++) {
        codes[i++] = b2 << 8 | b1
      }
    }
  }
}
const str = new TextDecoder('gbk').decode(codes)

// 编码表
const table = new Uint16Array(65536)
for (let i = 0; i < str.length; i++) {
  table[str.charCodeAt(i)] = codes[i]
}
若每处理一个 GBK 编码就调用一次 TextDecoder,效率将极低。为此,我们将所有 GBK 编码值集中存入 codes 数组,最后仅调用一次 TextDecoder 进行批量转换。
该初始化过程耗时仅 1ms 至 2ms,开销极低。
查表
建立映射表后,编码时直接查表即可:
function stringToGbk(str) {
  const buf = new Uint16Array(str.length)
  for (let i = 0; i < str.length; i++) {
    const code = str.charCodeAt(i)
    buf[i] = table[code]
  }
  return new Uint8Array(buf.buffer)
}

stringToGbk('你好')   // [196, 227,   186, 195]
输出结果与文章开头演示一致。
上述逻辑未涵盖 ASCII 字符范围,若传入包含数字的字符串(如「你好123」)则会出现问题。由于 GBK 中 ASCII 部分采用单字节存储,编码逻辑需相应调整:
function stringToGbk(str) {
  const buf = new Uint8Array(str.length * 2)
  let n = 0

  for (let i = 0; i < str.length; i++) {
    const code = str.charCodeAt(i)
    if (code < 0x80) {
      buf[n++] = code
    } else {
      const gbk = table[code]
      buf[n++] = gbk & 0xFF
      buf[n++] = gbk >> 8
    }
  }
  return buf.subarray(0, n)
}

stringToGbk('你好123')    // [196, 227,   186, 195,   49, 50, 51]
输出结果与文章开头演示一致。
出于性能考量,此处使用 Uint8Array 替代 Array。鉴于 Uint8Array 长度固定且申请后不可变,我们假设输入字符串仅含非 ASCII 字符以确保缓冲区充足,返回时再截取有效部分(使用 subarray 引用,无需额外复制)。
完善
若编码时传入 GBK 不支持的字符,按上述逻辑将转换为 0 字符,因为 table 空缺位置默认为 0。而 0 本身属于 GBK 编码的一部分,故该实现尚不完善。
因此,可将 table 填充为其他特定值,查表时若出现该值,即可作为异常处理依据。
此外,根据百科资料,微软基于 GBK 实现的 Code page 936 额外包含一个 0x80 字码,对应字符为欧元符号 €。
经测试,即使非 Windows 系统的浏览器也支持该字符:
const gbkBuf = new Uint8Array([0x80])
new TextDecoder('gbk').decode(gbkBuf)   // "€"
演示:https://jsbin.com/vuxawul/edit?html,output
最终实现:https://github.com/EtherDream/str2gbk
采用此方案,仅需几十行代码和几百字节体积即可实现 GBK 编码,且性能表现优异。
以上就是JS字符串转GBK编码超精简实现详解的详细内容,更多关于JS字符串转GBK编码的资料请关注本站其它相关文章!
JavaScript怎么遍历对象的Symbol键和不可枚举属性
2026-11-05 13:13:39
封装一个健壮的JS字符串判空工具函数
2026-11-05 12:16:14
JavaScript合并数组的三种常用方法:concat、扩展运算符与push
2026-11-05 11:22:29
JavaScript立即执行函数(IIFE)是什么及基本语法
2026-11-05 10:51:19
JS对象数组转字符串为什么推荐用JSON.stringify()
2026-11-05 09:40:31