

前端为什么需要监控系统:从异常捕获到自研实践
本文深入探讨前端监控系统的必要性,指出其不仅用于捕获JS异常和接口错误,还能通过行为埋点辅助产品运营。针对第三方平台灵活性不足的问题,文章详细解析了基于React、Node.js及MongoDB的自研方案,重点解决高频写入与复杂聚合查询的技术难点。
前端监控系统
提及监控系统,多数开发者首先联想到的是后端监控,例如服务器性能、数据库状态、API流量及服务运行状况等。相比之下,前端常被视为仅负责UI展示,关注页面排版与设计,似乎无需监测,因此长期缺乏监控概念。
因此,业界曾普遍认为只要后端稳定,应用即稳定。然而,实际情况是否如此?
近年来,随着JavaScript的持续演进和浏览器功能的增强,前端应用能实现的功能日益丰富,复杂度也随之攀升。过去未曾遇到的问题,如今频繁出现。
例如,前端开发人员小明接到用户反馈,称某页面按钮点击无反应。小明亲自测试该按钮,发现功能正常;随后使用多个不同账号测试,结果依然正常。这使得小明陷入困惑。
面对此类情况,前端开发者的常见应对策略一致。小明告知用户可能是浏览器缓存导致,建议强制刷新或退出登录重试。用户按建议操作后问题消失,并向小明致谢。小明谦逊回应。
两天后,又有用户反馈相同问题。小明再次使用上述方法解决,问题看似消除,但根本原因并未查明。由于小明多次尝试均无法复现异常,可能原因包括:
- 数据问题,例如无法获取特定属性
- 前端代码执行异常
- 接口问题,如接口无响应或未返回预期值
在正常测试中一切正常,说明该问题仅在特定场景下触发,且难以判断和捕捉。
此类Bug潜伏于系统中,如同地雷,随时可能爆发。最棘手的是,即使爆发也难以发现,导致排查工作困难重重。
某日,小明在思考中灵光一闪:“若在用户触发异常时,系统能自动捕获并保存异常数据,并在后台展示,我岂不能立即定位错误原因?”
小明恍然大悟:若能自动捕获异常数据,线上报错无需依赖用户反馈,前端即可自主发现并定位原因,实现一举两得。
许多前端前辈曾受此类问题困扰,逐渐形成“保存报错时异常数据供后续排查”的思路。经过不断实践,这一思路演变为今日的前端监控系统。
当前前端监控不仅限于异常数据,还包括任何有利于产品分析的数据。前端监控即采集用户使用系统过程中的关键数据,存储至数据库,供后续查找与分析的整套实现。
前端监控具体能解决什么问题?
前文通过示例阐述了前端监控的背景及其追踪线上报错的作用,初步展示了其意义。现在聚焦项目,深入探讨其具体解决的问题。
异常报错问题
首先是异常报错。如前例所示,线上异常难以复现,若无用户反馈,开发者甚至不知问题存在,给用户传递产品不稳定的印象。因此,前端监控是保障线上产品稳定和及时反馈异常的关键。
此外,前端监控还可捕获接口异常。前端开发者常自嘲为“背锅侠”,遇到问题首先被归咎于前端,无论责任归属,前端需先承担责任并耗时排查。有时领导未查明原因便严厉批评,若最终确认为接口问题,前端会感到委屈。
拥有前端监控后,可立即获取异常发生时的错误信息、页面、地址及参数等,快速明确责任方。面对线上事故,前端可客观指出问题归属;若遇推诿,前端也能凭证据据理力争。
性能检测问题
追踪异常是前端监控最实用的功能,但性能监控同样关键。
当前前端工程体量庞大,若代码质量不高或架构设计不合理,易引发性能问题。如首屏加载时间、页面卡顿、白屏、资源重复请求等,可通过采集渲染时间、接口请求数量及资源总量等数据,对页面进行监控,及时发现性能瓶颈。
除“解决问题”外,前端监控还有哪些价值?
运营反馈工具
前端监控不仅帮助程序员优化应用,对产品和运营同样不可或缺。通过“埋点监控”收集用户行为数据,可对线上产品使用情况进行统计分析,如整体PV/UV、功能访问量、访问时段、点击率等。这些数据帮助产品和运营了解实际情况,进而改进产品功能。
行为数据的收集能精准描绘功能或用户的实际使用情况。相比仅异常时收集的异常数据,行为数据采集量更大,只要用户与产品交互,理论上均需收集。
监控内容多样,数据采集视情况而定。总之,通过设计采集规则即可收集任何想了解的产品情况,灵活性极高,不限于已知指标。
为什么要选择自研?
前端监控发展至今,已有成熟的第三方平台。国内常用平台包括:
- sentry
- webfunny
- fundebug
sentry和fundebug为付费平台,费用随数据量增加,属于数据托管模式。webfunny支持私有化部署,但功能固定,无法修改代码,缺乏灵活性且无法定制。
尽管市场有成熟监控系统,许多团队仍选择自研。原因一:数据保存在自有服务器,无需额外付费;原因二:灵活性高,可自定义功能,如在触发异常时接入钉钉或企业微信消息推送,这需要监控系统具备高灵活性。
此外,自定义采集规则至关重要。不同规则采集的数据不同,第三方标准规则可能不符合公司需求。例如,有的公司需设备标识作为唯一ID,有的需用户标识,这由业务决定,各公司需求各异。
我司前端组自研前端监控平台,优势在于可自定义采集规则,设计数据库存储字段,数据存于自有平台,灵活性和可靠性高,能满足多样化需求。
自研前端监控的技术栈
结论:我司前端监控系统由前端组自研,技术栈为React + Node.js + MongoDB。
此为常规技术方案,前端自研以JS为主,也是前端较易掌握的标准方案。
Node.js部分使用 express 框架编写接口,接口主要分为写入和查询统计两类。前端采集数据后通过调用接口存储,监控面板也通过接口查询并展示数据。
接口背后是 MongoDB 数据库,用于存储采集数据。选择MongoDB的主要原因是其写入性能极高,写入速度快。由于监控系统在采集行为数据时写入频繁,对写入性能要求高,而查询要求相对较低。
难点在于采集大量数据后的多维度统计分析,例如:
- 某时间段用户的访问次数和访问时长排行
- 某时间段页面的访问频率和停留时间排行
- 某时间段接口报错的次数以及占比统计
此类复杂查询主要依赖MongoDB的聚合查询。前端编写基本分组统计尚可,但面对复杂查询则力不从心。为此,我们花费大量时间研读MongoDB聚合查询文档,按需求逐一查找实现函数,几乎遍历所有聚合函数。
接口完成后,使用React实现管理后台,以图表和表格形式展示数据,即可实时查看线上产品使用情况。
此外,还需编写对接钉钉或企业微信的通知接口,在触发异常时发起通知,以便及时知晓异常情况。我们的通知示例如下:
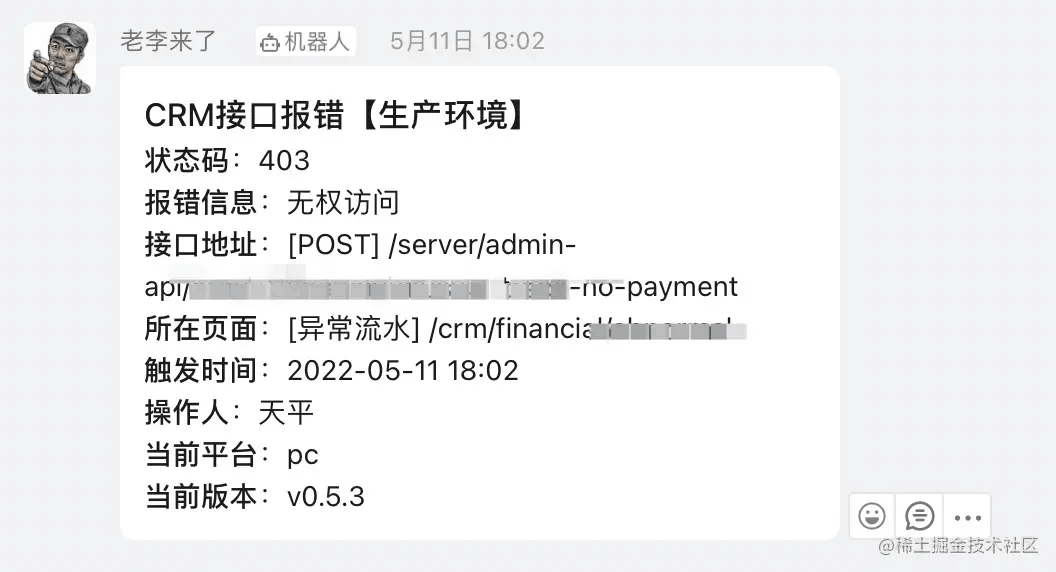
此信息能全面反映问题所在,若需查看更详细的错误,可前往异常面板查找:
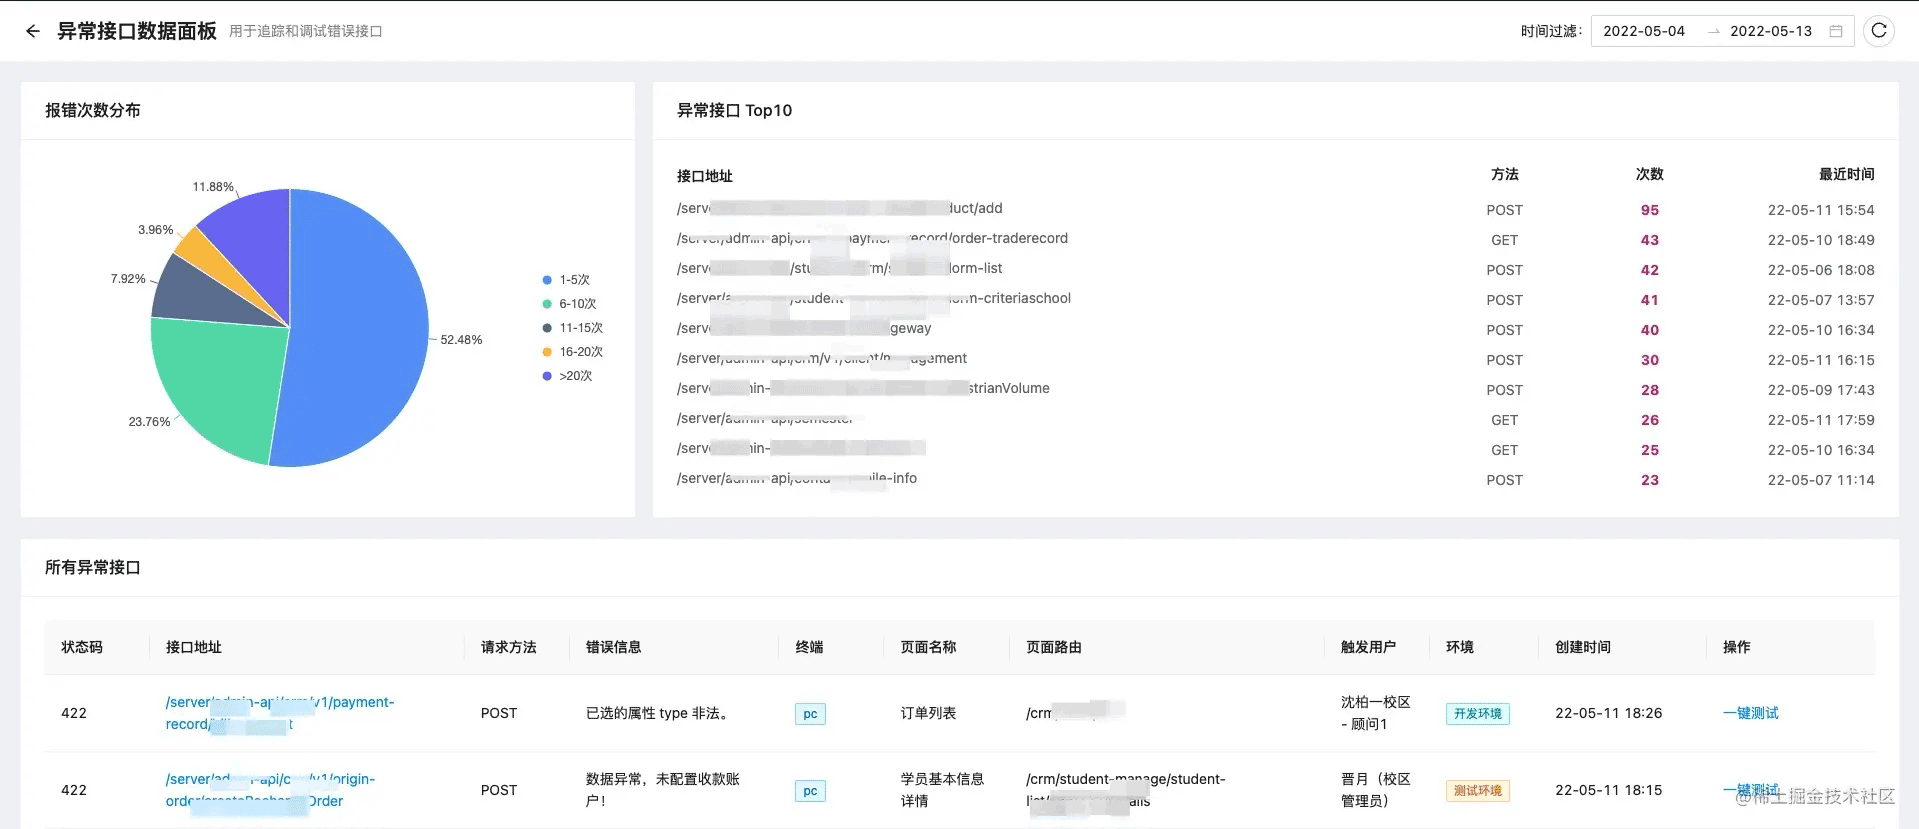
总之,首先对接口异常进行全面监控,确认数据无误后再由前端排查,效率提升,责任明确,实现双赢。
最终,我们自研的小系统在产品上线后发挥巨大作用,获得老板表扬,这鼓舞我们继续完善系统。
更多关于前端监控系统的资料请关注本站其它相关文章!
前端JS防止SQL注入的两种实现方式
2026-10-30 05:23:31
jQuery实现元素拖动排序及数据库更新示例
2026-10-28 07:22:28
JS实现无需数据库的县级以上联动行政区域下拉控件
2026-10-27 13:41:08
JavaScript 读写本地 SQLite 数据库:封装类与浏览器 Demo 实践
2026-10-26 11:06:32
Node.js 项目中操作 MySQL 数据库的完整指南
2026-10-24 21:54:48