

JavaScript 实现 Ajax 并发请求控制的两种方案
本文深入解析如何在 JavaScript 中控制 Ajax 并发请求,解决一次性发送大量请求导致的内存溢出问题。通过对比串行与并行执行模式,重点介绍了基于 Promise 递归的多工作区方案以及基于 Class 的单工作区方案。文章提供了完整的代码实现与逻辑注释,帮助开发者掌握限制并发数量、确保请求有序执行的技术细节,适用于需要批量处理接口的前端场景。
前言
近期遇到一道面试题,主题正是本文探讨的核心:Ajax 并发请求的控制。这道题据传源自字节跳动的面试,社区中多位技术专家已对此进行了总结与分析。在参考了相关讨论后,我决定整理一份详细的解答。完整的代码示例将附在文章末尾,若内容存在疏漏,欢迎指正。
Ajax 的串行与并行
- 串行执行:在常规业务场景中,若后续接口依赖前一个接口的返回数据,前端通常使用 Axios 等请求库。由于 Axios 基于 Promise 构建,我们可以直接利用链式调用或 Async/Await 语法来实现串行请求,此处不再赘述具体演示。
- 并行执行:指多个请求同时发起,通常用于在获取所有数据后进行页面渲染或其他后续操作。这主要基于 Promise.all 方法实现,具体方式如下:
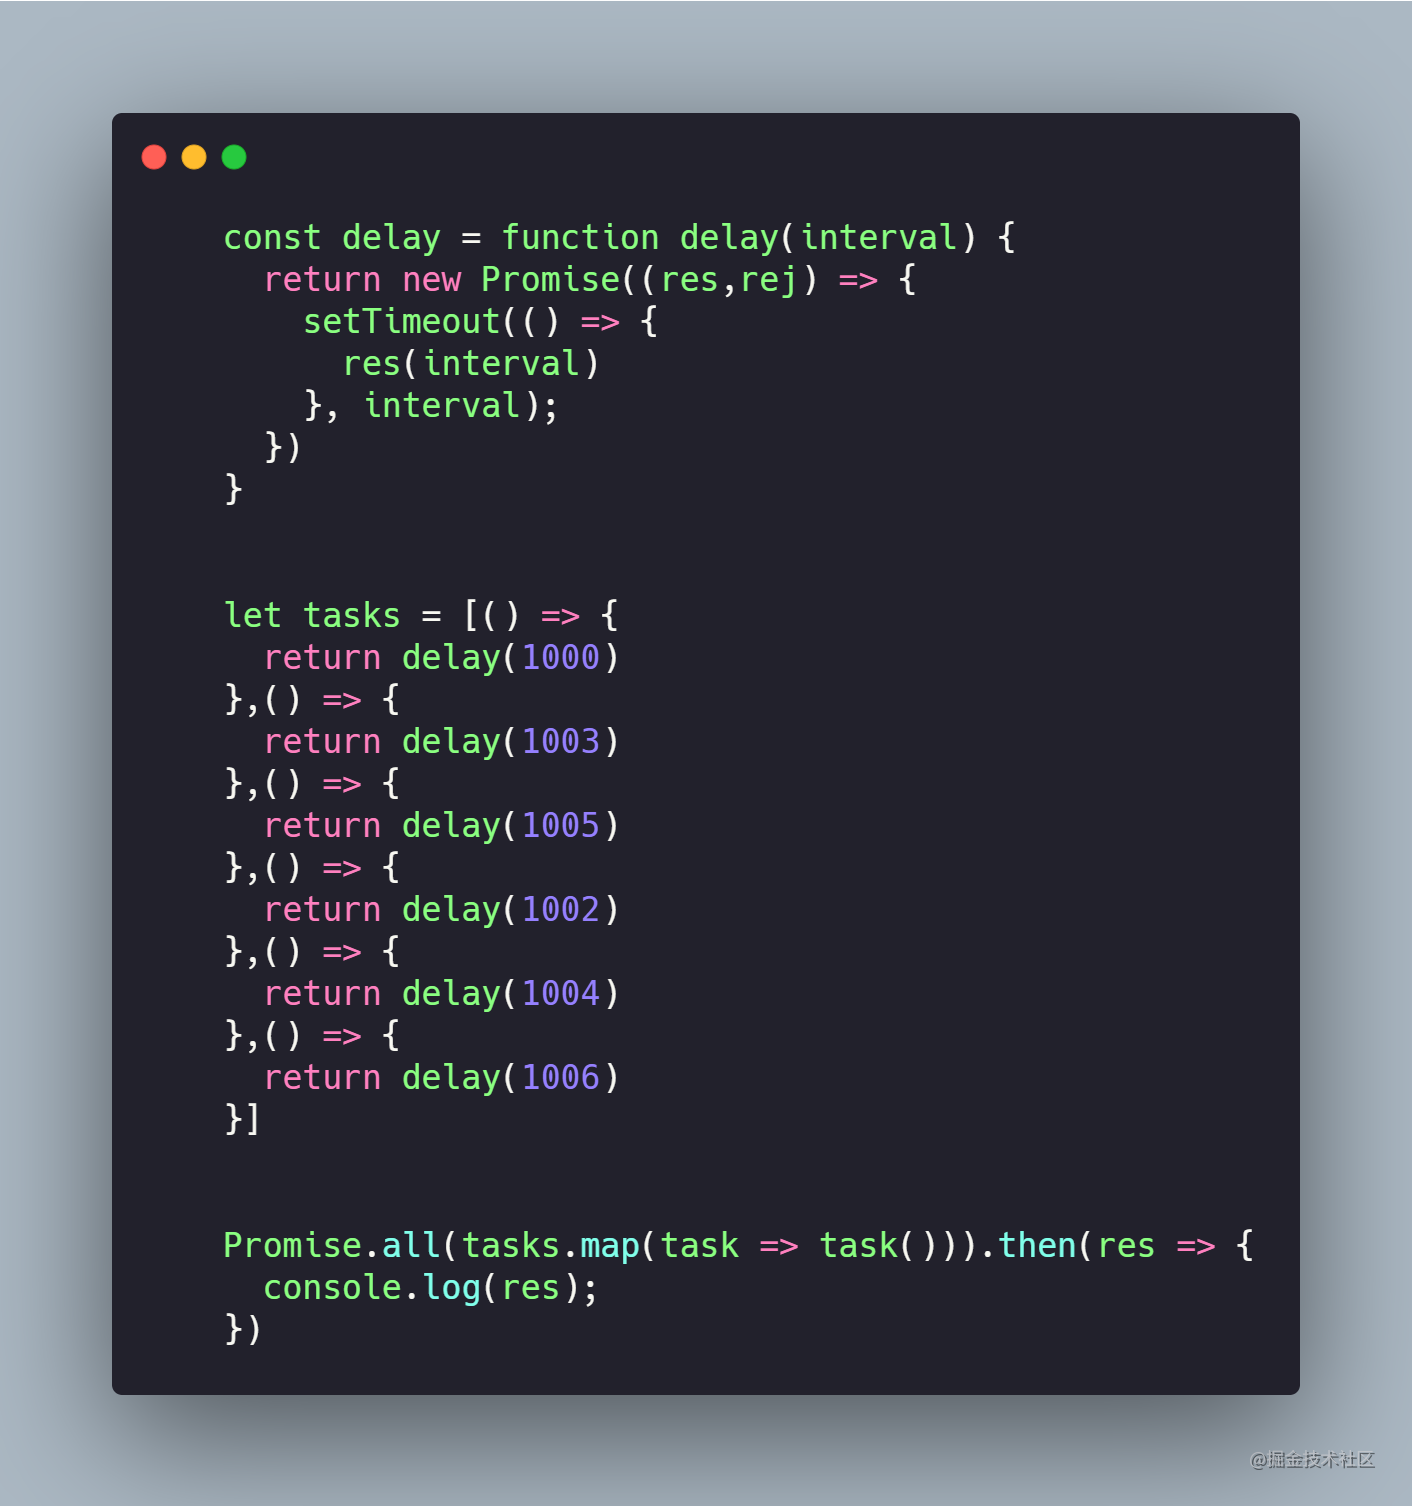
上述代码模拟了基于 Promise.all 的并行操作,打印结果如下:
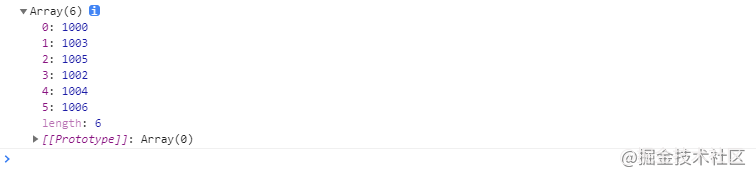
如果认为这就结束了,那便大错特错。接下来才是重点。试想一种场景:一个页面需要同时发送上万个请求,并在全部成功后执行后续操作。这会导致什么后果?代码无法执行,甚至引发内存溢出。此时便回到了文章的主题:如何控制 Ajax 的并发请求?我们需要限制每次只输出一定数量的请求,直到所有请求成功完成。接下来,我将介绍两种实现方法,望读者不吝赐教。
Ajax 并发请求控制的两大解决方案
基于 Promise 递归实现
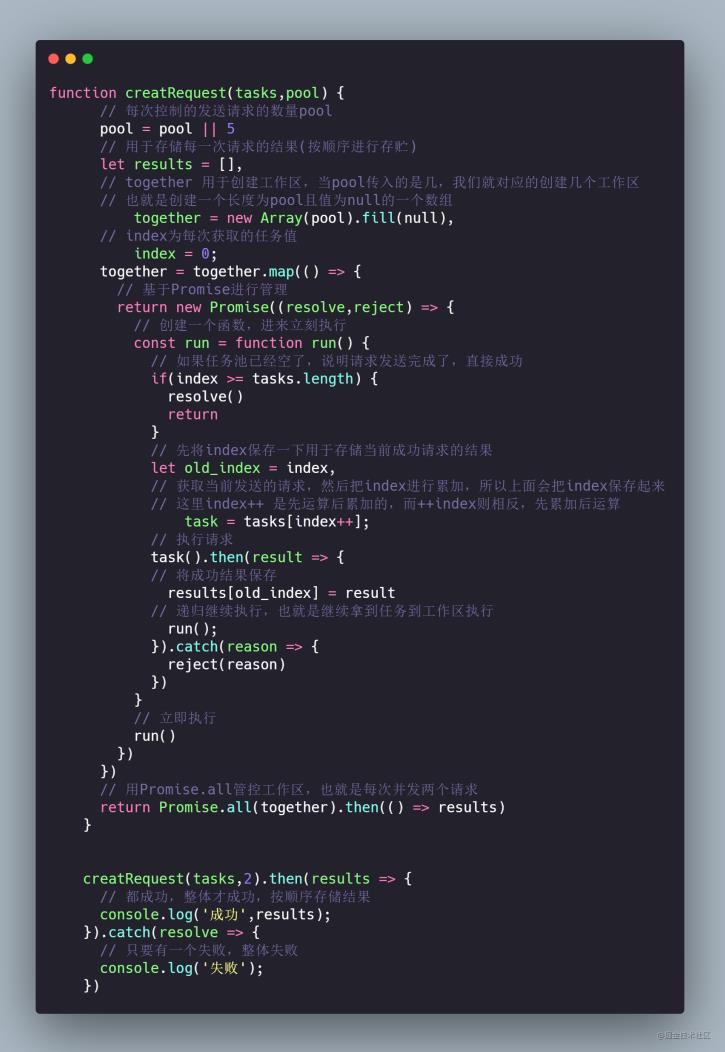
以下两种方法均依赖上文中的 Tasks 数组,请务必记住它。第一种方法基于 Promise,大致思路是:当传入一个并发量 pool 时,系统会创建 pool 个工作区。每个工作区负责获取对应的任务(请求)并执行,成功后保存结果,然后继续获取新任务,直到工作区无任务可取。若任务失败,则直接终止。大致思路如此,下面我对每一行代码进行了详细注释,请查阅。
基于 Class 实现
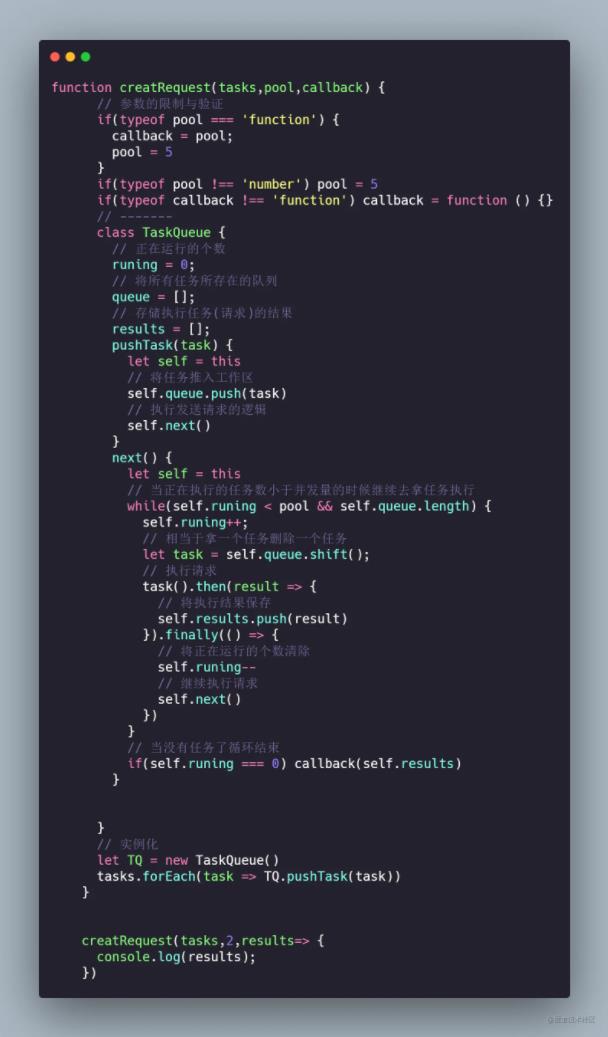
第二种方法基于 Class 实现,与第一种的区别在于它只创建一个工作区。大致思路是:创建一个工作区用于执行任务(请求),将所有任务推入队列,但每次仅执行指定的并发数量。当剩余任务小于并发数时,继续获取并执行任务,直到所有任务(请求)处理完毕。具体实现如下:
代码展示
这里将上述两种方法的实现代码完整列出:
    const delay = function delay(interval) {
      return new Promise((res,rej) => {
        setTimeout(() => {
          res(interval)
        }, interval);
      })
    }


    let tasks = [() => {
      return delay(1000)
    },() => {
      return delay(1003)
    },() => {
      return delay(1005)
    },() => {
      return delay(1002)
    },() => {
      return delay(1004)
    },() => {
      return delay(1006)
    }]

    // 通过Promise.all实现并行
    Promise.all(tasks.map(task => task())).then(res => {
      console.log(res);
    })

    // 基于Promise实现

    function creatRequest(tasks,pool) {
      // 每次控制的发送请求的数量pool
      pool = pool || 5
      // 用于存储每一次请求的结果(按顺序进行存贮)
      let results = [],
      // together 用于创建工作区,当pool传入的是几,我们就对应的创建几个工作区
      // 也就是创建一个长度为pool且值为null的一个数组
          together = new Array(pool).fill(null),
      // index为每次获取的任务值
          index = 0;
      together = together.map(() => {
        // 基于Promise进行管理
        return new Promise((resolve,reject) => {
          // 创建一个函数,进来立刻执行
          const run = function run() {
            // 如果任务池已经空了,说明请求发送完成了,直接成功
            if(index >= tasks.length) {
              resolve()
              return
            }
            // 先将index保存一下用于存储当前成功请求的结果
            let old_index = index,
            // 获取当前发送的请求,然后把index进行累加,所以上面会把index保存起来
            // 这里index++ 是先运算后累加的,而++index则相反,先累加后运算
                task = tasks[index++];
            // 执行请求
            task().then(result => {
            // 将成功结果保存
              results[old_index] = result
            // 递归继续执行,也就是继续拿到任务到工作区执行
              run();
            }).catch(reason => {
              reject(reason)
            })
          }
          // 立即执行
          run()
        })
      })
      // 用Promise.all管控工作区,也就是每次并发两个请求
      return Promise.all(together).then(() => results)
    }


    creatRequest(tasks,2).then(results => {
      // 都成功,整体才成功,按顺序存储结果
      console.log('成功',results);
    }).catch(resolve => {
      // 只要有一个失败,整体失败
      console.log('失败');
    })


    // 基于Class实现
    function creatRequest(tasks,pool,callback) {
      // 参数的限制与验证
      if(typeof pool === 'function') {
        callback = pool;
        pool = 5
      }
      if(typeof pool !== 'number') pool = 5
      if(typeof callback !== 'function') callback = function () {}
      // -------
      class TaskQueue {
        // 正在运行的个数
        runing = 0;
        // 将所有任务所存在的队列
        queue = [];
        // 存储执行任务(请求)的结果
        results = [];
        pushTask(task) {
          let self = this
          // 将任务推入工作区
          self.queue.push(task)
          // 执行发送请求的逻辑
          self.next()
        }
        next() {
          let self = this
          // 当正在执行的任务数小于并发量的时候继续去拿任务执行
          while(self.runing < pool && self.queue.length) {
            self.runing++;
            // 相当于拿一个任务删除一个任务
            let task = self.queue.shift();
            // 执行请求
            task().then(result => {
              // 将执行结果保存
              self.results.push(result)
            }).finally(() => {
              // 将正在运行的个数清除
              self.runing--
              // 继续执行请求
              self.next()
            })
          }
          // 当没有任务了循环结束
          if(self.runing === 0) callback(self.results)
        }


      }
      // 实例化
      let TQ = new TaskQueue()
      tasks.forEach(task => TQ.pushTask(task))
    }


    creatRequest(tasks,2,results=> {
      console.log(results);
    })
总结
以上是对该面试题的完整总结,同时也作为个人的学习记录。后续我将持续更新前端相关文章,希望各位前端开发者能坚持学习,不断提升技术水平,加油!
到此这篇关于如何基于 JS 实现 Ajax 并发请求控制的文章就介绍到这了,更多相关 JS 实现 Ajax 并发请求控制内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
JavaScript怎么准确判断数据类型:typeof、instanceof与Object.prototype.toString
2026-11-05 17:09:21
JS中将数组和对象混合组装为JSON字符串
2026-11-05 16:41:42
JS运算符优先级与结合性的区别是什么?
2026-11-05 13:22:02
JS Map怎么只遍历Key或Value
2026-11-05 13:00:36
D3.js 与 ECharts 选型对比:灵活性 vs 开发效率
2026-11-05 09:45:01