Kimi K3发布后,为何机构判断算力需求还会继续增加
围绕Kimi K3发布后的市场争议,文章按新手易理解的方式梳理其模型能力、成本定位及华尔街机构判断,重点说明为何不少机构认为它不会压低高端算力需求,反而可能继续抬升推理、存储、网络和数据中心侧的基础设施压力。
Kimi K3会像DeepSeek那样冲击市场吗?机构更关注算力需求继续放大
月之暗面推出 Kimi K3 之后,市场很快把焦点放在一个老问题上:它会不会再次触发类似 DeepSeek 时刻的连锁反应。此前确实有一部分资金担心,美股 AI 相关板块可能再度承压。但随后多家华尔街机构给出的判断非常接近,而且结论并不符合很多人的第一直觉:Kimi K3 的进展没有削弱高端算力的重要性,反而可能把这条需求线继续往上推。
把逻辑拆开看,其实并不难理解。大型模型想提升能力,前期仍离不开大规模 GPU 集群训练;而当模型推理效果更好、可用场景更多之后,真正的变化往往出现在落地端。部署范围扩大、调用次数上升,背后的 GPU、存储、网络和数据中心资源就会被更频繁地消耗。所以现在市场讨论 AI 产业链时,重点已经不只是“能不能降本”,而是“降本之后会不会换来更大的总需求”。
也正因为如此,虽然市场一度把 Kimi K3 看作可能出现的“DeepSeek 时刻 2.0”,但主流机构的判断与这种担忧并不一致。
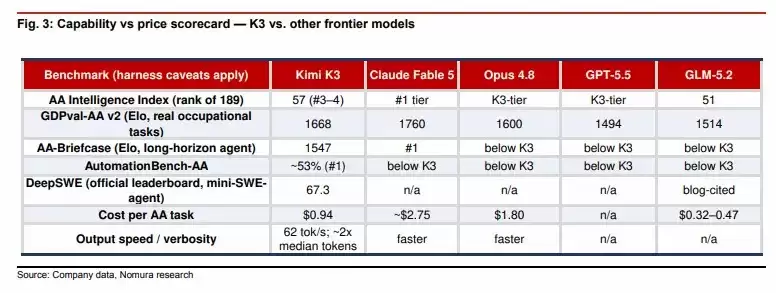
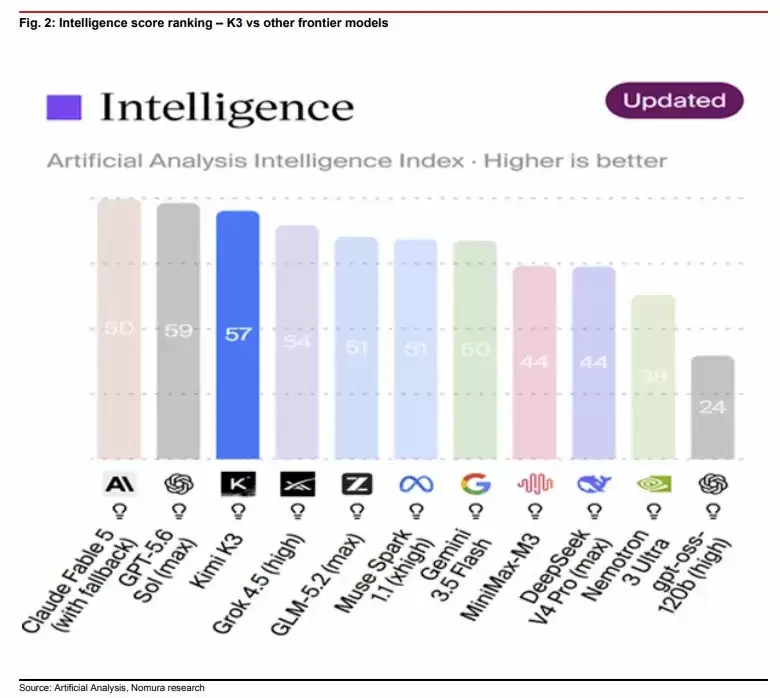
7 月 16 日深夜,月之暗面在上海正式发布 Kimi K3。这是一款拥有 2.8 万亿参数的开源模型,在 Artificial Analysis 智能指数中拿到 57 分,处于全球第三至第四的位置,与 Anthropic 的 Claude Opus 4.8 和 OpenAI 的 GPT-5.5 被放在同一梯队。更受关注的是,在加州大学伯克利分校创建的 Frontend Code Arena 编程榜单中,K3 以 1679 分排在第一,超过 Claude Fable 5 和 GPT-5.6 Sol,成为首个在这一权威编程榜单中压过全部海外闭源模型的开源模型。
7 月 17 日,美股半导体板块出现了比较明显的回调。这个反应不算意外,因为 2025 年初 DeepSeek R1 发布后,算力相关股票就经历过一轮快速下跌。当时市场担心的核心问题是:如果中国模型继续逼近全球最前沿水平,美国 AI 公司是否还有必要维持如此高强度的算力投入?如果低成本模型越来越多,英伟达、HBM、服务器和网络设备的需求预期,是否需要重新下修?
不过,据追风交易台消息,瑞银、野村、美银美林和花旗等多家机构最新给出的观点都偏向同一个方向:Kimi K3 不是算力需求见顶的信号,更像是新一轮需求外溢的催化因素。
从市场影响的角度看,Kimi K3 和 DeepSeek R1 带来的冲击并不完全一样。R1 更容易被理解为“效率提升”,而 K3 更突出的是“规模拉高”。2.8 万亿参数、1M token 上下文、常开推理、原生多模态以及 MoE 架构,决定了它并不是一个轻量化故事。相反,它对推理、内存、网络和存储都会提出更高要求,基础设施侧承受的压力可能同步上升。
Kimi K3 深度解析:能力、定位与成本
Kimi K3 由月之暗面在 2026 年 7 月 16 日发布,完整模型权重计划于 7 月 27 日开放。作为一款 2.8 万亿参数的开源权重大模型,它被不少机构视作当前体量最大的开源 LLM 之一。
如果你是第一次接触这类模型,可以先抓住 K3 最值得注意的三点:
- 1M token 上下文窗口:可以理解为一次性能读入和处理更多信息,适合超长文本阅读、复杂代码仓库分析,以及企业内部大体量资料处理这类任务。
- 常开推理能力:说明它不只是做简单问答,更偏向能处理多步骤、链路更长的问题,这类能力通常更适合 Agent 相关任务。
- 原生视觉能力:覆盖图像、视频、游戏开发、前端设计、CAD 等多模态使用场景。
在架构层面,K3 使用了 Kimi Delta Attention、Attention Residuals 和 Stable LatentMoE。MoE 部分由 896 个专家组成,每个 token 会激活其中 16 个专家。月之暗面表示,和 Kimi K2 相比,整体 scaling efficiency 提升约 2.5 倍。
这也是为什么市场不会把 K3 简单看成“更便宜的 K2”。根据 Nomura 整理的数据,K3 输入价格为每百万 token 3 美元,缓存命中输入为 0.30 美元,输出价格为每百万 token 15 美元;按 Artificial Analysis 的口径,K3 单项任务成本约为 0.94 美元,低于 Claude Fable 5 的约 2.75 美元和 Claude Opus 4.8 的约 1.80 美元,接近 GPT-5.6 Sol 的 1.04 美元。不过,它的成本仍明显高于 GLM-5.2 的 0.32—0.47 美元,也显著高于 DeepSeek V4 Pro 的 0.04 美元。这里要注意,涉及成本、价格和排名等信息,实际变化仍应以对应平台或实时页面口径为准。
因此,如果从币圈、Web3 和 AI 产业观察的角度看,Kimi K3 的位置并不是去争“最便宜模型”,而是在相对有竞争力的价格带上,尽量把能力做得更接近前沿闭源模型。
Kimi K3 会削弱算力需求吗?四家投行观点
围绕“Kimi K3 会不会再次带来 DeepSeek 式冲击”这个问题,几家主要投行的判断大体一致:这更像是一轮需求重新定价,而不是需求被削弱。
野村证券:AI竞争越激烈,基础设施链条越可能受益
野村证券亚太科技团队分析师段冰在报告中提到,全球大模型市场的竞争和创新不会停下。随着行业继续朝通用人工智能推进,生成式 AI 在消费端和企业端的应用范围都可能继续扩大。前沿 AI 实验室和超大规模云平台公司,大概率仍会保持较高投入,原因很简单:谁都不愿意在竞争中掉队。在这样的框架下,野村把竞争升级视为 AI 基础设施价值链的偏正面信号。
花旗集团:这更接近“杰文斯悖论”再出现一次
花旗半导体分析师 Peter Lee 在 7 月 19 日的报告中,直接把这一主题概括为“又一次杰文斯悖论”。简单说,就是技术效率提升、使用门槛降低之后,不一定会让总需求下降,反而可能因为更多人开始使用,带来更大的整体消耗。
放到 AI 行业里看,如果高质量模型变得更便宜、部署更容易,开发者和企业很可能会上线更多应用、处理更多 token,最终把整体算力消耗推高。
Peter Lee 还特别指出,即使 K3 获得更广泛应用,服务器 DDR5 和 eSSD 这类通用内存与存储需求仍然有扩张空间。原因在于,K3 的推理效率虽然接近其他前沿模型,但上下文越长,KV 缓存占用就会越大,内存压力不会因为效率改善而自动消失。
美银美林:美国前沿实验室的选择可能是“继续加算力”
美银证券半导体分析师 Vivek Arya 在 7 月 17 日的报告中说得更直接:面对中国开源模型逼近,美国前沿 AI 实验室不太可能选择“更少算力”,更可能选择“更多算力”。如果 OpenAI、Anthropic 和 Google 想继续保持差异化,它们可能需要更大规模训练、更重的推理投入,以及更快的产品更新节奏。
Arya 还提到,有媒体报道称 Google 的 Gemini 3.5 Pro 比原计划推迟了数月,而且编程能力也没有达到内部目标。这从侧面说明,前沿模型想要长期领先,难度其实在提高。
瑞银:K3更偏向“规模型”路线,长上下文会继续抬高内存需求
瑞银分析师 Timo Arcuri 团队在 7 月 20 日的报告中指出,K3 虽然可以和 DeepSeek R1 放在一起比较,但它的核心侧重点更偏“规模”。它拥有 2.8 万亿参数和 100 万 token 上下文窗口。报告强调,开源模型通常比闭源前沿模型更依赖内存资源,尤其在更长上下文场景下,即便做了量化,KV 缓存的绝对需求仍会增加,这意味着开源模型部署对 HBM 和存储的依赖度可能更高。
Kimi K3 可能影响哪些方向?算力、存储、网络与云平台解析
从这些机构的观点看,Kimi K3 对产业链的影响不是平均铺开的,而是更集中在几个关键环节。对于不熟悉 AI 基建的新手,可以把它理解成一句话:模型越强、应用越多,背后承载它的底层硬件和服务就越关键。这里也要注意,相关方向属于产业观察,不等同于投资建议,实际市场表现仍可能受技术进展和企业落地节奏影响。
1. 存储与内存:HBM、DDR5、eSSD 的关注度更高
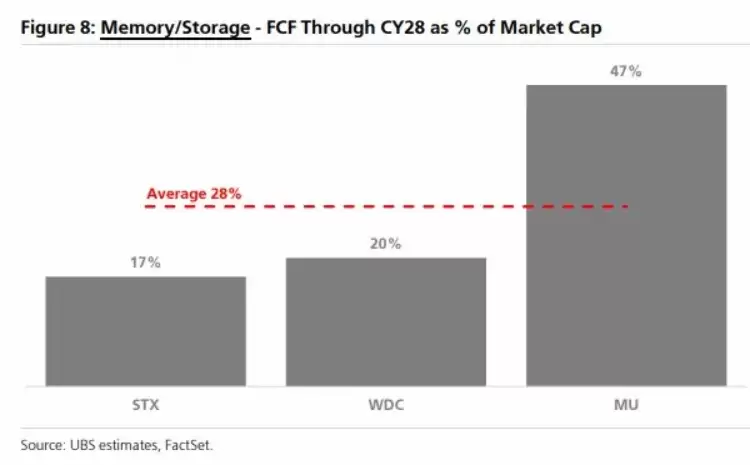
存储与内存是多家机构都提到的直接受影响板块。瑞银测算显示,到 2028 年,存储与内存板块累计自由现金流预计可达到市值的约 30%,在各子板块中占比最高,其中美光(MU)约为 47%。花旗和野村也维持对三星电子的买入评级,理由之一是全球内存市场仍处于供给偏紧状态。涉及自由现金流、评级和市场数据时,实际情况仍应以机构最新报告和实时公开信息为准。
花旗指出,Kimi K3 在推理侧的内存需求并不比其他前沿模型弱,KV 缓存规模提升会直接带动服务器 DDR5 与企业级固态硬盘的需求。其还特别提到,K3 若进行大规模部署,可能需要超过 64 块 GPU 的“超节点”集群配置。
2. 算力基础设施:英伟达、台积电仍是核心变量
算力基础设施方面,英伟达和台积电依旧被视为关键受益方向。无论是训练端继续遵循规模定律,还是推理端 token 使用量不断增加,最后都会对应更多先进制程芯片需求。野村重申对台积电、ASE、联发科等公司的买入评级。
英伟达此前公开表示,现代 MoE 模型在 GB300 NVL72 上的推理性能功耗比,相较上一代 Hopper 架构最高可提升 25 倍。像 K3 这类模型,也被认为天然更容易受益于英伟达的新一代硬件平台。这里同样要提醒,硬件性能、产品节奏和市场影响会随厂商更新而变化,解读时应以官方资料为准。
3. 网络侧:超节点架构会继续抬升光模块和光芯片需求
网络侧也被不少机构看作结构性机会所在。原因是 Kimi K3 需要超节点集群,而中国本土算力又受到高端芯片出口限制影响,超节点架构被视为弥补单卡性能差距的重要方案之一。这会进一步带动光模块、光芯片等网络层供应链需求。野村看好中际旭创和苏州旭创。
4. 云平台与数据中心:模型分发与企业部署的重要性提高
云平台与数据中心同样被机构反复提及。能同时托管多种前沿开源模型的云平台,通常会拥有更强的议价能力,也不必过度依赖单一闭源模型供应商。野村看好阿里巴巴(BABA)在中国 AI 云生态中的核心位置,同时关注 GDS、万国数据(VNET)等数据中心运营商。
中国 AI 模型全球渗透率变化:开发者流量是关键信号
这轮讨论里还有一个容易被忽略、但实际很重要的变量,就是中国 AI 模型在全球开发者生态中的渗透速度。
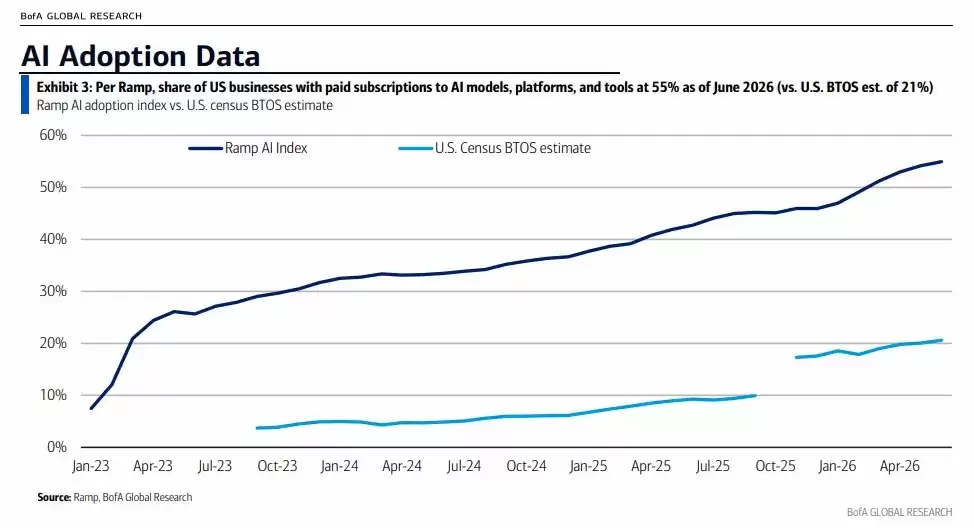
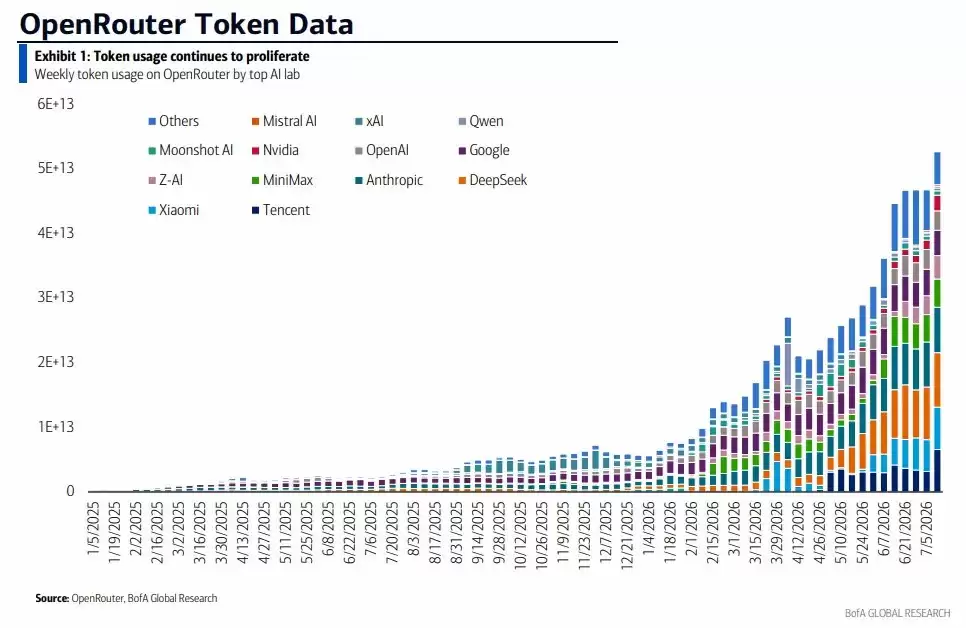
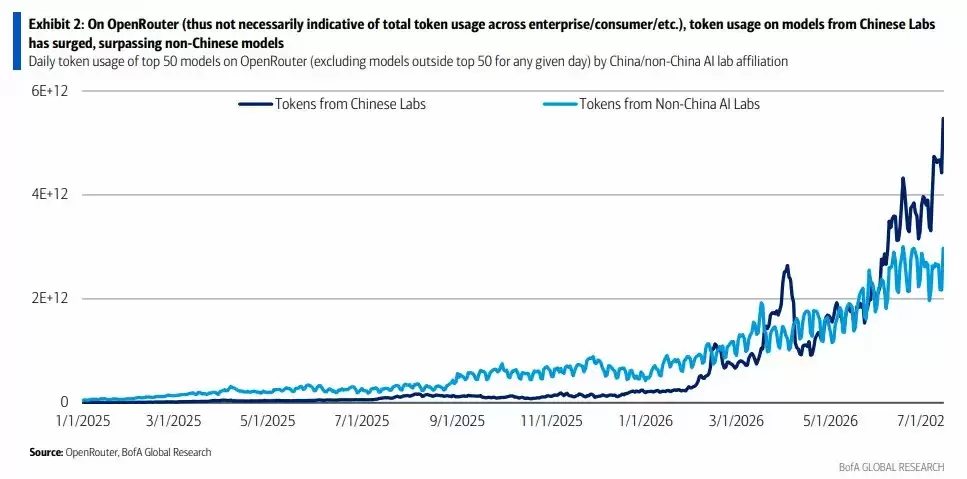
根据开放 API 网关 OpenRouter 的统计,中国 AI 模型在全球开发者流量中的 token 使用占比,一年前不足 2%,目前已超过 45%。与此同时,美银美林的数据也显示,AI 整体渗透速度正在提升:目前约 55% 的美国企业已订阅 AI 模型、平台或工具,Anthropic 的企业采用率为 42%,OpenAI 为 40%。在头部 AI 消费者中,前 1% 的企业用户每位员工每月 AI 支出已达到 4833 美元。这里要特别注意,以上渗透率、采用率和支出数据都具有时间性,查看时应以机构报告、官方页面或实时统计口径为准。
从竞争格局看,市场分层已经越来越明显。一边是以 DeepSeek、Kimi K3 为代表的中国开源模型,覆盖经济型和中高端性价比市场;另一边则是美国顶级前沿模型,继续向科学计算等更复杂工作负载集中,以维持技术溢价和定价能力。野村的判断是,只要能持续站在技术曲线前沿,中美两边的头部大模型玩家都可能受益。
Kimi K3 改变了什么:重塑 AI 竞争节奏
K3 发布之后,市场第一反应还是会把它和 DeepSeek R1 放在一起比较。这样比较本身没有问题,但如果讨论只停留在“它会不会再次打击 AI 硬件”这一层,显然不够完整。
如果说 DeepSeek 让市场重新评估了训练效率,那么 Kimi K3 进一步说明的是:开源模型同样可以在规模、长上下文、Agent 和多模态等方向推进到前沿水平。
这意味着,美国前沿实验室可能仍要保持高投入,而中国模型也有机会继续扩大在全球开发者生态中的存在感。闭源顶级模型保留技术和价格溢价,开源模型覆盖更广的价格带和部署场景;云厂商负责模型分发与企业落地,硬件产业链则继续承接训练端和推理端的基础设施压力。
从短期看,受到“DeepSeek 记忆”影响,相关交易可能仍会出现波动。拉长一点看,只要 token 使用量还在增长,长上下文和 Agent 场景继续扩散,算力、HBM、存储、网络和 IDC 这些环节仍然很难被绕开,依旧会是重要成本项。
这也就是为什么多家机构在 K3 发布后给出了相似判断:更强的开源模型,不一定意味着 AI 基建需求走弱,反而可能成为下一轮需求扩散的起点。
不过,美银美林也明确提示了一项尾部风险:如果效率提升的速度快过工作负载增长,那么基础设施建设节奏也可能放缓。换句话说,若模型持续变便宜,但实际使用量没有同步明显上升,算力需求增长逻辑就会受到影响。后续仍要结合模型部署进度、企业采纳情况以及真实 token 消耗变化继续观察。
需要说明的是,上述内容主要是对机构观点和产业逻辑的整理,用于帮助读者理解 Kimi K3 对 AI 基础设施的可能影响,并不构成投资建议、交易建议或任何收益承诺。AI、半导体、算力以及相关概念资产波动通常较大,加密货币和迷因币波动也更明显;文中提到的价格预测、市场数据、费率、排名及规则变化,均应以官方公告、交易所页面及实时行情平台为准,用户需独立判断并谨慎决策。