

Sora 出现后,AI 与 Web3 可能结合的四条路径
围绕 Sora 带来的行业变化,梳理 AI 与 Web3 可能结合的四个方向,包括去中心化算力、算法与模型协作、链上数据利用以及 AI 赋能 Dapp,并穿插说明技术逻辑、适用场景与现实限制。
原标题:《Sora 引发关注后,AI 与 Web3 会沿哪些方向继续结合?》
原文作者:Zeke,YBB Capital
前言
2 月 16 日,OpenAI 对外发布了新的文本生成视频扩散模型 Sora。凭借一批完成度较高的演示片段,Sora 再次把生成式 AI 在视觉内容生产上的能力推到了台前。和 Pika 等仍主要停留在“多张图片合成为几秒视频”阶段的工具相比,Sora 通过在视频与图像的压缩潜在空间中训练,并把内容拆解为时空位置补丁,展示出更强的扩展能力。与此同时,这个模型也呈现出对物理世界与数字世界进行一定程度模拟的能力,其最长 60 秒的 Demo 因而被不少人看作接近“物理世界通用模拟器”的早期版本。
如果从技术路线往下看,Sora 基本延续了 GPT 系列背后的“源数据-Transformer-Diffusion-涌现”框架,这也意味着它后续继续提升,仍然离不开更强的算力支撑。视频训练需要的数据量通常明显高于文本训练,对计算资源的消耗也会随之放大。围绕这一点,市场此前已经反复讨论 AI 时代的算力瓶颈,尤其是去中心化算力、存储等 DePIN 方向,近一段时间随着 AI 叙事升温而快速获得关注。真正值得继续追问的是,除了 DePIN 之外,AI 与 Web3 还能在哪些方向继续结合。下面会在已有讨论基础上重新梳理这件事,并补充 AI 时代下 Web3 可能延展出的几条主要路径。
AI 发展史中的三条主要路径
人工智能(Artificial Intelligence)可以理解为一套模拟、扩展并增强人类智能能力的技术体系。自上世纪五六十年代出现以来,AI 在几十年里不断演进,逐步从研究主题变成推动生产、生活和产业变化的重要力量。若回看它的发展过程,符号主义、连接主义和行为主义这三条线索长期并行,也共同构成了今天 AI 快速发展的基础。
符号主义(Symbolism)
符号主义也常被称为逻辑主义或规则主义。它的核心想法是:人类智能可以通过对符号的处理来模拟。这一路径会先用符号去表示对象、概念以及它们之间的关系,再依靠逻辑推理解决问题。专家系统和知识表示就是这一方向较典型的成果。换句话说,符号主义更强调“把现实抽象成可操作的符号,再通过规则推理得到答案”。
连接主义(Connectionism)
连接主义通常就是大家更熟悉的神经网络路线。它尝试模仿人脑的结构和工作方式,通过大量简单处理单元构成网络,再靠调整这些单元之间的连接强度来完成学习。和依赖明确规则不同,连接主义更强调从数据里学习规律并进行泛化,所以在模式识别、分类任务以及连续输入输出映射上有明显优势。今天常见的深度学习,本质上就是连接主义进一步发展后的重要分支,已经在图像识别、语音识别、自然语言处理等领域取得了关键突破。
行为主义(Behaviorism)
行为主义与仿生机器人、自主智能系统的研究关系更近。它关注的重点不是内部思考过程怎么被表示,而是智能体如何通过与环境不断交互来学习与适应。它的基本出发点是,智能并不是封闭产生的,而是在感知、行动、反馈的循环中逐步形成。因此,面对复杂且不确定的现实环境时,这条路线在移动机器人、自适应控制系统等场景里通常更有现实意义。
虽然这三种方法在理论上差异很大,但在真实的研究与产业落地中,它们并不是完全分开的。很多时候,正是这些方法彼此补充、持续融合,才推动了 AI 体系不断向前演化。
AIGC 原理概述
当前快速扩张的生成式 AI(Artificial Intelligence Generated Content,AIGC),本质上可以看作连接主义在今天的进一步延伸。它的关键能力,是模仿人类的创作过程并输出新的内容。一般来说,模型会依赖大规模数据集和深度学习算法完成训练,从数据中学习结构、关系和模式,再根据用户输入生成图像、视频、代码、音乐、设计、翻译、问答和文本等结果。对现阶段的大多数 AIGC 来说,底层支撑主要还是三部分:深度学习、大数据和大规模算力。
深度学习
深度学习是机器学习(ML)里非常重要的一支,基本思路是利用模仿人脑结构设计出的神经网络来完成建模。人脑由大量相互连接的神经元组成,通过协同工作完成信息处理;对应到计算机中,深度学习网络则由多层人工神经元构成,共同执行复杂任务。每个神经元都可以理解为一个进行数学运算的数据处理节点,而复杂能力则来自大量节点之间的协作。
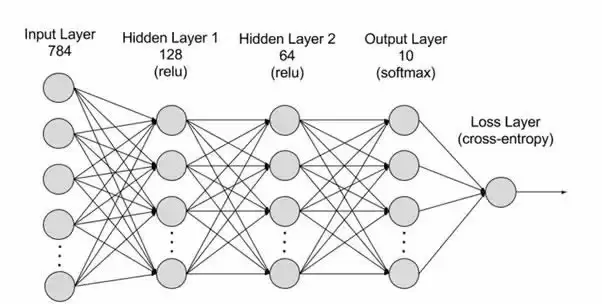
从结构上理解,神经网络一般由输入层、隐藏层和输出层组成,各层之间通过参数连接。
- 输入层(Input Layer):这是神经网络最前面的一层,作用是接收外部输入数据。输入层中的每个神经元通常对应一个输入特征。比如在图像任务里,一个神经元就可能对应一个像素值。
- 隐藏层(Hidden Layer):输入数据会继续传到更深的网络,由多个隐藏层逐层处理。隐藏层会在接收信息后不断调整自身的响应方式。深度学习网络往往拥有较多隐藏层,因此能够从多个维度拆解问题。举例来说,如果模型要判断一张未知动物图片,它可能分别分析耳朵形状、腿的数量、眼睛特征等信息,隐藏层做的就是类似这样的特征提取与组合判断。
- 输出层(Output Layer):输出层位于神经网络末端,用来给出最终结果。做分类任务时,输出神经元可以分别对应不同类别;如果是回归任务,输出层也可能只保留一个神经元,用于表示预测值。
- 参数:不同层之间的连接主要由权重(Weights)和偏置(Biases)表示。训练过程最核心的事情,就是持续优化这些参数,让模型更擅长识别模式和输出结果。通常参数越多,模型表达复杂模式的能力越强,但同时也意味着更高的算力成本。
大数据
神经网络要训练得足够有效,通常离不开大量、丰富且质量较高的数据。数据既是机器学习模型学习的原材料,也是评估模型效果的重要基础。模型通过分析这些样本,逐步学会其中的规律与关联,再把这些规律用于预测、分类或生成任务。
大规模算力
神经网络为什么如此依赖算力,原因并不复杂:模型本身往往层数多、参数量大、要处理的数据规模也高。训练时还需要不断迭代,在每一轮中重复进行前向传播、反向传播、激活函数计算、损失函数计算、梯度求解和参数更新。除此之外,高精度计算、并行计算、优化与正则化方法,以及模型评估和验证等环节,也都会继续抬高整体计算需求。
Sora
作为 OpenAI 最新推出的视频生成模型,Sora 代表着 AI 在处理和理解复杂视觉数据方面又向前迈了一步。依靠视频压缩网络和时空补丁技术,Sora 可以把来自不同设备、不同场景的大规模视觉数据转成更统一的表示形式,从而更高效地处理复杂视觉内容。再结合文本条件化 Diffusion 模型,它能够依据文字提示生成匹配度较高的视频或图像,表现出较强的适应性和内容生成能力。
但操作前先确认一点:Sora 并不是已经没有短板的成熟终局。它目前仍面临一些现实问题,比如对物理世界的模拟是否足够准确、长视频内容能否始终保持一致、复杂文本指令理解是否稳定,以及训练与生成效率是否还能继续提升。更底层地看,Sora 依然建立在 OpenAI 长期算力投入和先发优势之上,走的还是“大数据-Transformer-Diffusion-涌现”这一主流路线。因此,其他 AI 公司未来也并非没有机会通过不同技术路径实现追赶,甚至出现新的突破。
虽然 Sora 与区块链本身并没有天然的直接绑定关系,但它的外溢影响很可能会在未来一两年继续显现,推动更多高质量 AI 生成工具出现,并进一步影响 Web3 里的 GameFi、社交、创作平台和 DePIN 等细分方向。所以,先理解 Sora 的能力边界,再去看 AI 与 Web3 后续怎么结合,会更容易抓住重点,也更不容易被表面叙事带偏。
AI+Web3 的四条主要路径
前面提到,生成式 AI 的底层基础主要是算法、数据和算力;与此同时,AI 本身又是一个非常通用的生产力工具。相对地,区块链更擅长做的事情,是通过去中心化机制去重构协作关系与价值分配。两者结合后,比较典型的方向,大致可以归纳为四类。
去中心化算力
只要谈到 AI,算力几乎都是绕不开的话题。Sora 的出现,又进一步放大了外界对算力需求上限的想象空间。在瑞士达沃斯举行的 2024 世界经济论坛期间,OpenAI 首席执行官山姆·奥特曼曾公开表示,算力和能源已经成为当前阶段的重要限制因素,未来的重要性甚至可能接近货币。随后在 2 月 10 日,他又在社交平台提到一项规模惊人的计划,拟融资 7 万亿美元,希望重塑全球半导体产业格局并建立芯片帝国。无论这些计划最终如何落地,至少可以说明,算力问题已经不只是技术细节,而是产业资源配置层面的核心议题。
在这种背景下,去中心化算力被放大并不难理解。区块链确实有机会在一定程度上缓解算力资源过度集中、专用 GPU 采购成本过高等问题。若按 AI 场景拆分,算力需求大致可分为训练和推理两部分。当前主打训练的去中心化项目并不多见,因为这不仅要求去中心化网络与神经网络架构深度协同,也对硬件能力提出了很高要求,门槛和落地难度都不低。相对来说,推理方向更容易先做起来:一是网络结构设计通常更简单,二是对硬件和带宽的要求也更低,所以它成了更常见的切入点。
需要注意的是,中心化算力市场本身就有很大的想象空间,也常被和“万亿级”叙事绑定,因此它天然容易在 AI 周期里持续吸引关注。但从近期密集出现的一批项目来看,其中不少仍然带有明显的追热点色彩。很多项目强调去中心化概念,却很少正面回应去中心化网络在效率上的现实问题;还有一些产品方案高度同质化,甚至出现大量相似的“一键 L2 + 挖矿”设计。如果没有足够清晰的差异化能力,这类项目想从传统 AI 市场里真正拿到份额,并不轻松。对新手来说,这类方向更适合先理解逻辑和限制,再判断其实际落地情况,而不是只看叙事热度。
算法与模型协作系统
机器学习算法的重要性在于,它能够从数据中抽取规律和模式,并进一步支撑预测或决策。算法本身是高度技术密集型资产,它的设计与优化依赖长期的专业积累和持续创新。换句话说,算法决定了数据如何被转化为可用洞察,也是训练 AI 模型时最核心的基础之一。当前常见的生成式 AI 算法包括生成对抗网络(GAN)、变分自编码器(VAE)和 Transformer 等。不同算法通常对应不同任务方向,比如绘画、语言识别、翻译或视频生成,再据此训练出各自适用的模型。
顺着这个逻辑,一个自然的问题就出现了:既然算法和模型各有优势,能不能把它们组织成一个更通用、能协作学习的系统?近期受到较多讨论的 Bittensor,就是这一思路的代表之一。它尝试通过挖矿激励机制,让不同 AI 模型和算法之间形成协作与相互学习,以提升系统的整体能力。类似方向还包括 Commune AI 等,特点更偏向代码协作。不过从现实情况看,算法与模型往往是 AI 公司的核心壁垒,尤其在闭源体系下,并不会轻易对外开放。
因此,AI 协作生态这条叙事虽然有新意,也确实想借助区块链机制去缓解算法孤岛问题,但它最终能不能稳定形成持续价值,现在还需要继续观察。尤其是头部 AI 公司在闭源模型上的更新速度非常快,整合能力也在不断增强。以 OpenAI 为例,它在不到两年的时间里,就从早期文本生成模型快速推进到了多模态能力更强的系统。对于 Bittensor 这类项目来说,未来更现实的路径,也许不是和头部通用模型正面硬碰,而是在细分场景里找到更明确的差异化位置。
去中心化大数据
从比较直观的角度看,把私有数据用于训练 AI,或者把数据标注过程交给更开放的协作网络,这件事本身就和区块链机制有一定契合度,关键在于如何减少垃圾数据、压缩作恶空间。如果进一步涉及数据存储需求,那么 FIL、AR 等 DePIN 方向也可能从中受益。再往更深一点看,把区块链上的数据用于机器学习,提升链上数据的可获取性和可利用性,也是值得关注的一条路线,目前也已有项目在尝试。
理论上,区块链数据是公开且可访问的,能够完整反映链上状态;但对生态外部的普通用户或者数据从业者来说,真正高效获取并用好这些数据并不简单。完整存储一条区块链,通常就需要较强的专业能力和专门硬件资源。为了解决这一问题,行业已经发展出多种方案。比如 RPC 提供商会通过 API 开放节点访问能力,而索引服务则借助 SQL 或 GraphQL 来提高数据提取效率。这些方案都很关键,但也都不是没有限制:RPC 服务并不适合高密度、大规模查询;索引服务虽然能提供更结构化的检索方式,但由于 Web3 协议本身复杂,查询系统搭建依然有较高门槛,有时甚至需要写出数百到数千行代码。对于不熟悉 Web3 细节的开发者或分析人员来说,这一步并不轻松。
也正因为如此,市场始终对“更容易获取、也更容易使用的区块链数据”有明确需求。如果未来能够通过 ZKML(零知识证明机器学习)降低机器学习在链上执行环境中的负担,再结合质量较高的区块链数据集,就有机会形成改善链上数据可访问性的实际方案。若 AI 进一步降低了处理区块链数据的门槛,那么随着时间推移,开发者、研究者以及机器学习从业者,理论上都更容易拿到相关性更强、质量更高的数据集,从而支撑更有效的应用开发和创新尝试。不过这里也要注意,数据是否可用、是否准确、是否适合训练,仍然是落地时绕不过去的问题。
AI 赋能 Dapp
自 2023 年 ChatGPT 3 出圈之后,AI 赋能 Dapp 其实已经成了一个比较常见的方向。生成式 AI 的通用性很强,能够通过 API 接入,帮助分析平台、交易机器人、区块链知识工具等应用提高自动化和智能化程度。除此之外,AI 也可以被用于聊天机器人、AI 伴侣,甚至给链游生成 NPC 角色等场景。不过操作前先确认一点:这类接入方案的技术门槛通常并不算高,很多产品本质上只是接入通用 API 再做轻量微调,与自身业务逻辑结合得并不深,因此从长期看,真正有辨识度的案例其实并不算多。
但在 Sora 推出之后,AI 赋能 GameFi(包括元宇宙)以及内容创作平台,可能会成为下一阶段更值得继续观察的方向。Web3 天然带有自下而上的社区属性,这使它在传统游戏工业或大型创意公司主导的市场里,往往很难正面竞争。而像 Sora 这样的工具出现后,这种局面可能会有所变化。至少从当前 Demo 的效果看,相关能力已经表现出与微短剧内容公司竞争的潜力。与此同时,Web3 社区本身就具有很强的创意表达和二次创作文化,当内容生产门槛被进一步压低,传统自上而下的内容工业,与社区驱动型创作之间的边界,确实可能被重新划定。当然,真正能不能转化为稳定产品,还要看工具成本、版权问题、内容质量控制和用户需求是否匹配。
结语
随着生成式 AI 工具继续进步,行业后续仍可能出现更多带有里程碑意义的“iPhone 时刻”。虽然市场一直存在对 AI 与 Web3 结合价值的质疑,但从当前观察来看,这些探索方向本身并不是完全没有逻辑。真正需要回答的核心问题,仍然集中在必要性、效率以及两者的契合度上。AI 与 Web3 的融合目前还处于早期摸索阶段,不过这并不妨碍它成为未来周期里值得持续关注的一条重要线索。
对新事物保持足够的好奇心和开放度,仍然是理解产业变化的重要前提。历史上,无论是汽车替代马车,还是加密市场里不同叙事的轮换,技术与范式转换往往比预期来得更快。对于 AI 与 Web3 这样的交叉领域,更有意义的做法,可能不是简单地给它贴上看多或看空标签,而是先看清它真正能解决什么问题、适合什么场景、又存在哪些明显限制。本文内容仅供学习参考,不构成投资建议、交易建议或任何收益承诺;加密货币与迷因币波动较大,文中涉及的相关判断、项目进展及市场数据均应以官方公告、交易所页面及实时行情平台为准,参与者需独立判断并谨慎决策。