

蚂蚁发布两款万亿参数模型 AI布局加速推进
蚂蚁百灵团队近期密集发布Ling-1T与Ring-1T-preview两款万亿参数模型,跻身行业前列。模型在编程与数学推理等核心评测中表现突出,展现了强大的综合能力。蚂蚁通过开源共享技术成果,旨在推动构建开放的AGI生态。这体现了其“AIFirst”战略下,探索智能极限、促进技术共同演进的发展路径。
国庆假期,各行各业都按下了暂停键,但大模型的竞技场却比平日更加热闹。短短半个月,国内外头部团队密集发布了十余款重磅产品,技术路线却各不相同。
九月下旬,阿里推出以Qwen3-Max为代表的“全家桶”,展示了综合实力;月末,DeepSeek和Anthropic则聚焦于硬核编程场景,先后发布DeepSeek V3.2-Exp和Claude Sonnet 4.5。智谱也紧随其后,推出GLM-4.6,目标直指国内最强代码模型。
有人追求全面布局,有人专攻单点突破。当大模型竞争进入深水区,各家公司的战略分野愈发清晰。
就在10月9日凌晨,蚂蚁百灵大模型团队进行了一次“奇袭”,官宣了最新语言大模型Ling-1T,其参数量高达1000B(1万亿)。而就在十天前,他们才刚刚开源了自研的思考模型Ring-1T-preview。
十天之内,连续发布并开源两款万亿参数模型,如此密集的动作,让蚂蚁百灵瞬间成为行业焦点。这种近乎“毫无保留”的开源姿态,也引发了一个核心疑问:蚂蚁的棋局,究竟意在何方?
探索智能上限是终极目标
蚂蚁集团自主研发的基础大模型系列命名为“百灵”,取意“百试百灵”,也承载着科技普惠的愿景。与阿里系独立研发的路径类似,蚂蚁的百灵团队也走着自己的路。此次发布的Ling-1T和此前开源的Ring-1T-preview,分别代表了其技术探索的两大分支:非思考模型与思考模型。
过去半年,百灵模型的迭代速度肉眼可见。团队自上而下梳理出三条清晰的技术路线:基于MoE架构的非思考模型Ling-Series、专注于深度推理的思考模型Ring-Series,以及面向未来的原生全模态大模型Ming-Series。如今,前两条路线上,蚂蚁都已将参数规模推至万亿级别。
万亿参数,这个数字约等于人类大脑的神经元数量,象征着让AI拥有人脑级处理能力的野心。但训练一个万亿参数模型,其难度堪称登天。放眼国内,能跻身“万亿俱乐部”的选手,屈指可数。
除了蚂蚁的Ling-1T和Ring-1T-preview,目前公开资料可查的,也只有Kimi的K2、阿里通义千问的Qwen3-Max、腾讯混元大模型等少数几位。这个俱乐部的门槛,高得令人咋舌。
尽管今年以来,“数据撞墙论”和“预训练终结”的观点时有耳闻,但产业界和学术界正形成一个新的共识:更大的参数、更高质量的数据,依然能带来持续的性能提升。阿里的算法负责人林俊旸就公开表示,Scaling Law(缩放定律)远未见顶。杨植麟带领的Kimi团队,更是克服重重困难,在两个月前拿出了万亿参数的旗舰模型K2。通义千问团队则直接抛出“大就是好”的论断,让Qwen3沿着“Just Scale it”的路径坚定前行。
由此可见,探索智能的极限,仍然是头部玩家们共同锚定的终极目标。
百灵大模型加速涌现
过去一年,国内大模型领域堪称“七天一新款”,从不缺乏新面孔。但模型多了,另一个问题浮现出来:在庞大的参数规模与高效的推理性能之间,能取得完美平衡的模型,其实凤毛麟角。
对于万亿参数模型而言,规模上去了,推理速度往往成为瓶颈;而如果追求极致的响应速度,准确率又难以保障。业界公认的旗舰大参数模型,无一不是在推理能力与思考效率的“钢丝”上找到了那个精妙的平衡点,即所谓的帕累托最优。这个平衡点,通常通过多维基准测试的分数来量化衡量。
这次蚂蚁发布的Ling-1T,在公开的权威评测榜单中,表现就有些出人意料。下图展示了Ling-1T在部分核心基准测试中的成绩,红色加粗代表其得分位列第一,黑色加粗下划线则代表第二:
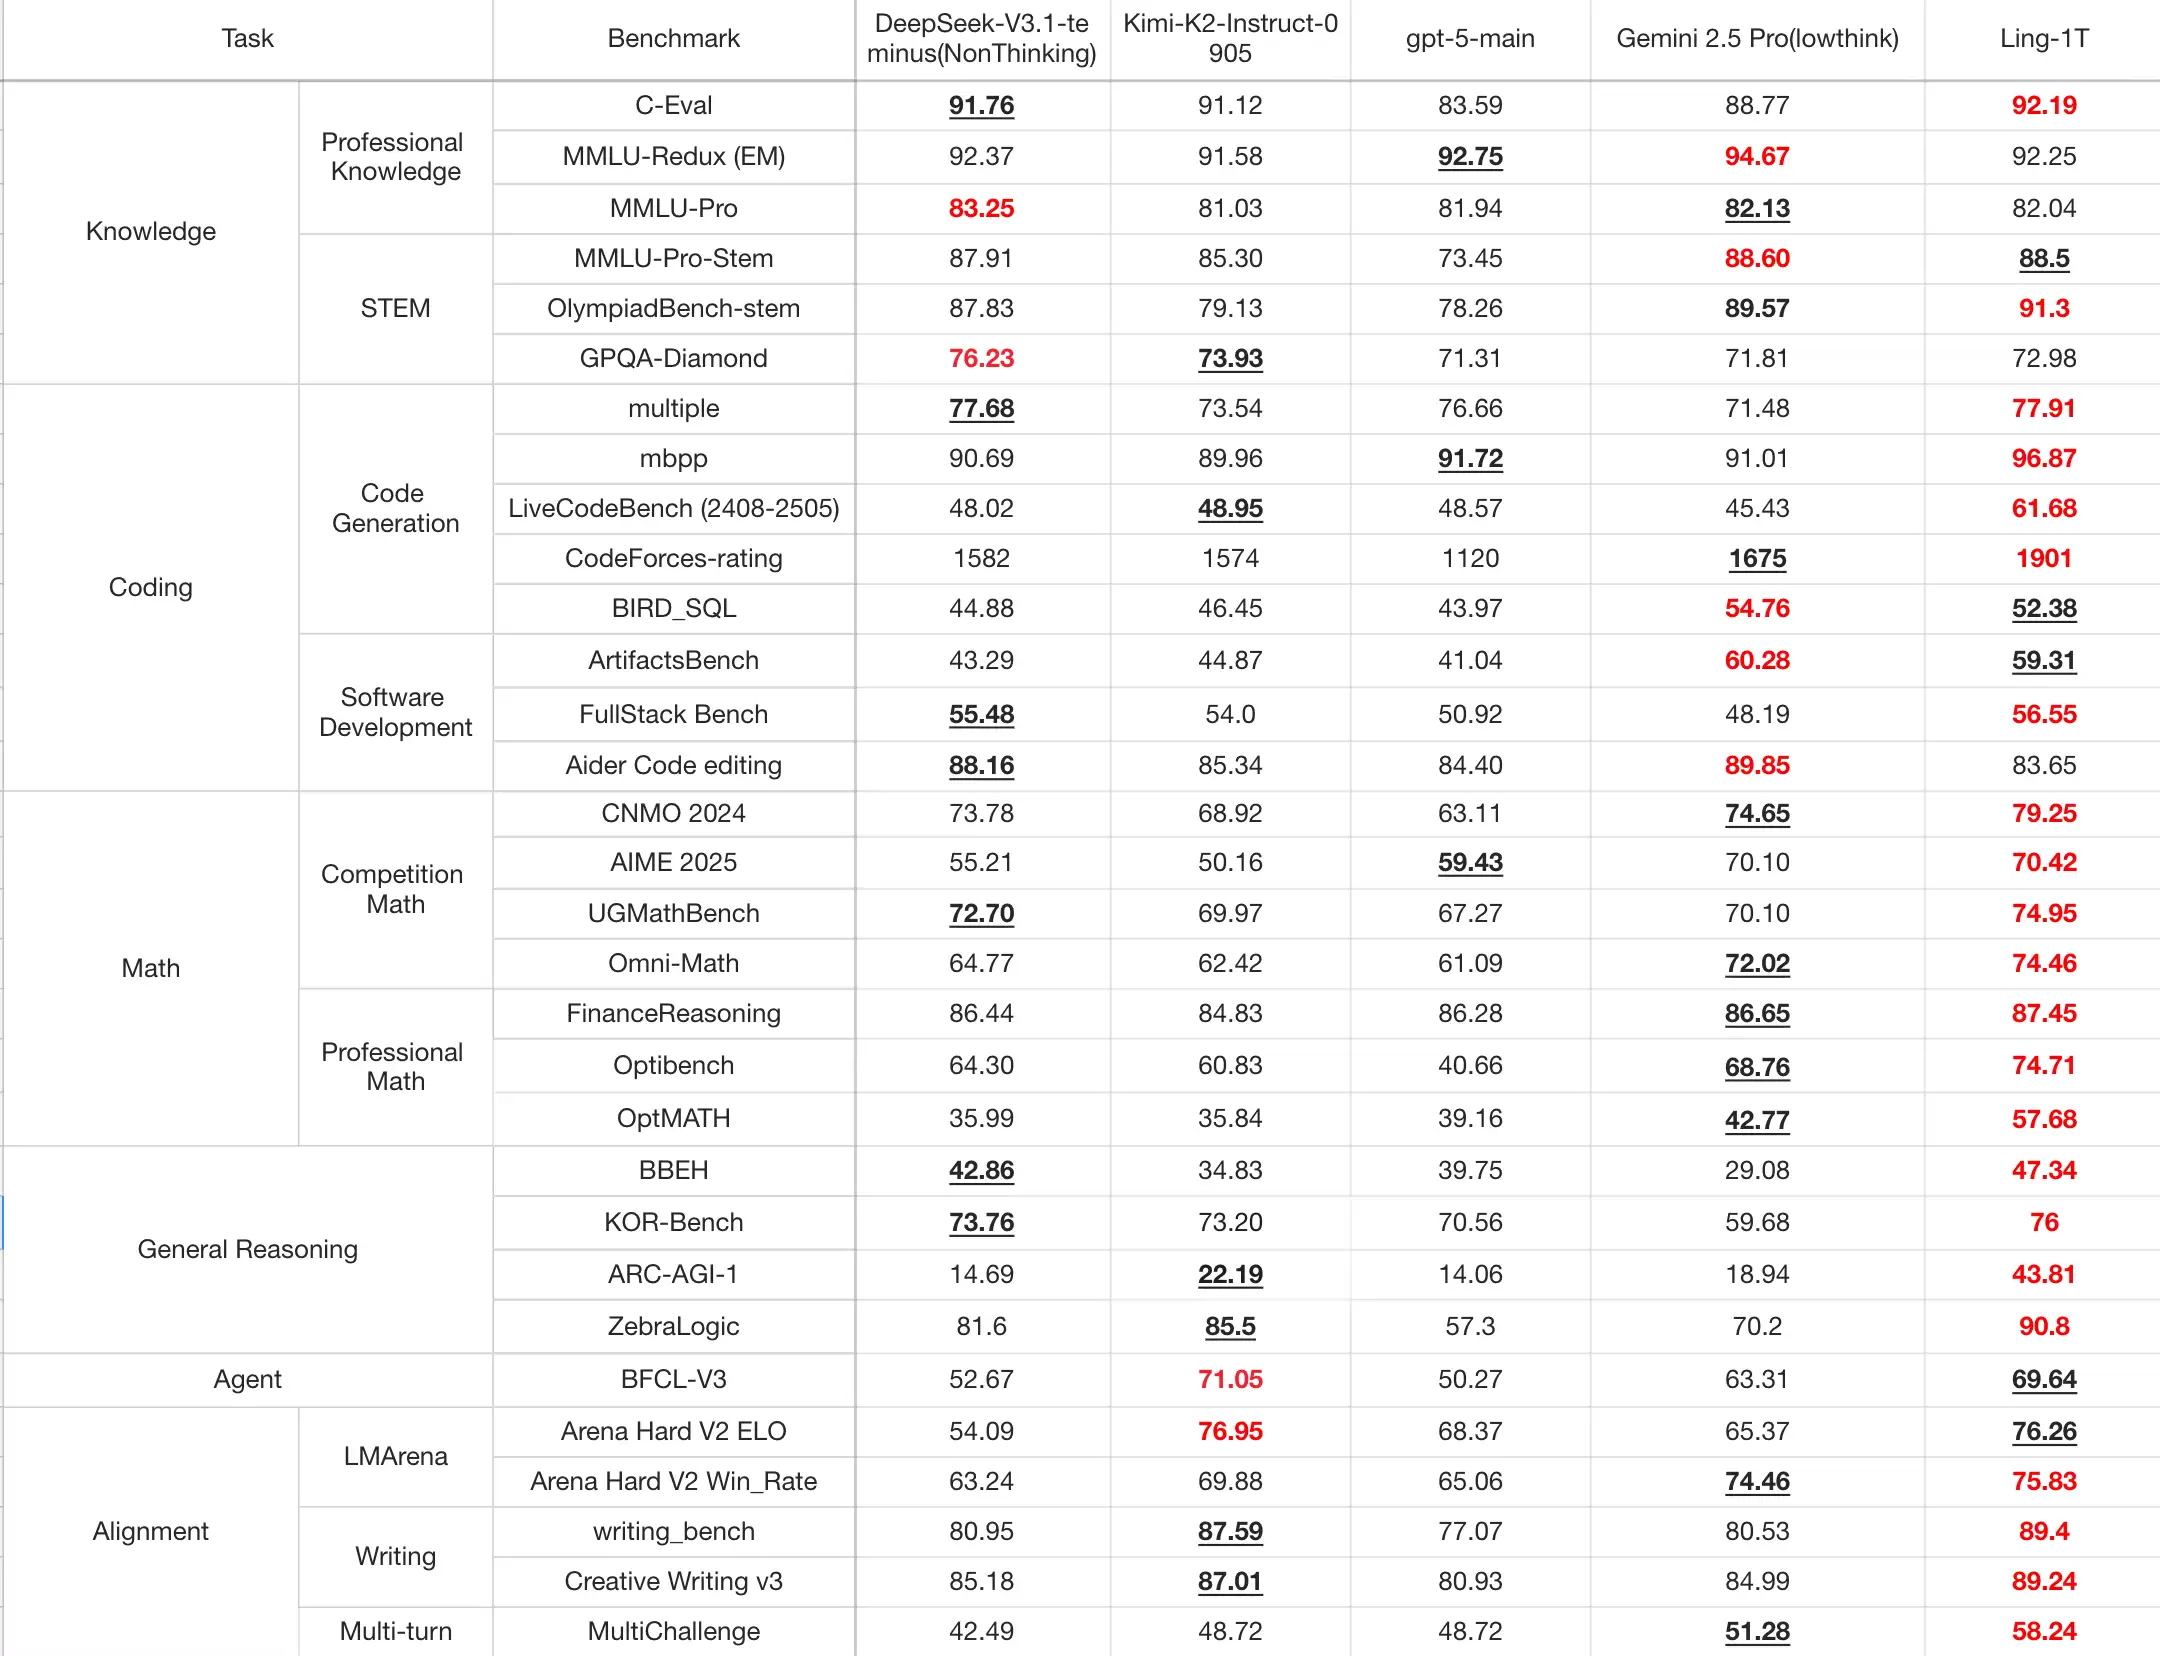
在业界尤为关注的编程与数学推理两大维度上,Ling-1T表现极为亮眼,多项得分甚至超越了以代码能力见长的DeepSeek。在知识理解方面,它的得分也略高于Kimi、GPT-5主干模型等强劲对手。这意味着,Ling-1T在深度思考、泛化能力以及逻辑推理上,展现出了相当全面的实力。因此,它在代码生成、软件开发、竞赛数学、专业逻辑推理等场景中,会显得尤为得心应手。
不过,对于万亿模型,综合性能之外,还有一个关键指标:推理的正确率。这就不得不提竞赛数学领域的试金石——AIME 25榜单。Ling-1T在该测试中的成绩如下:
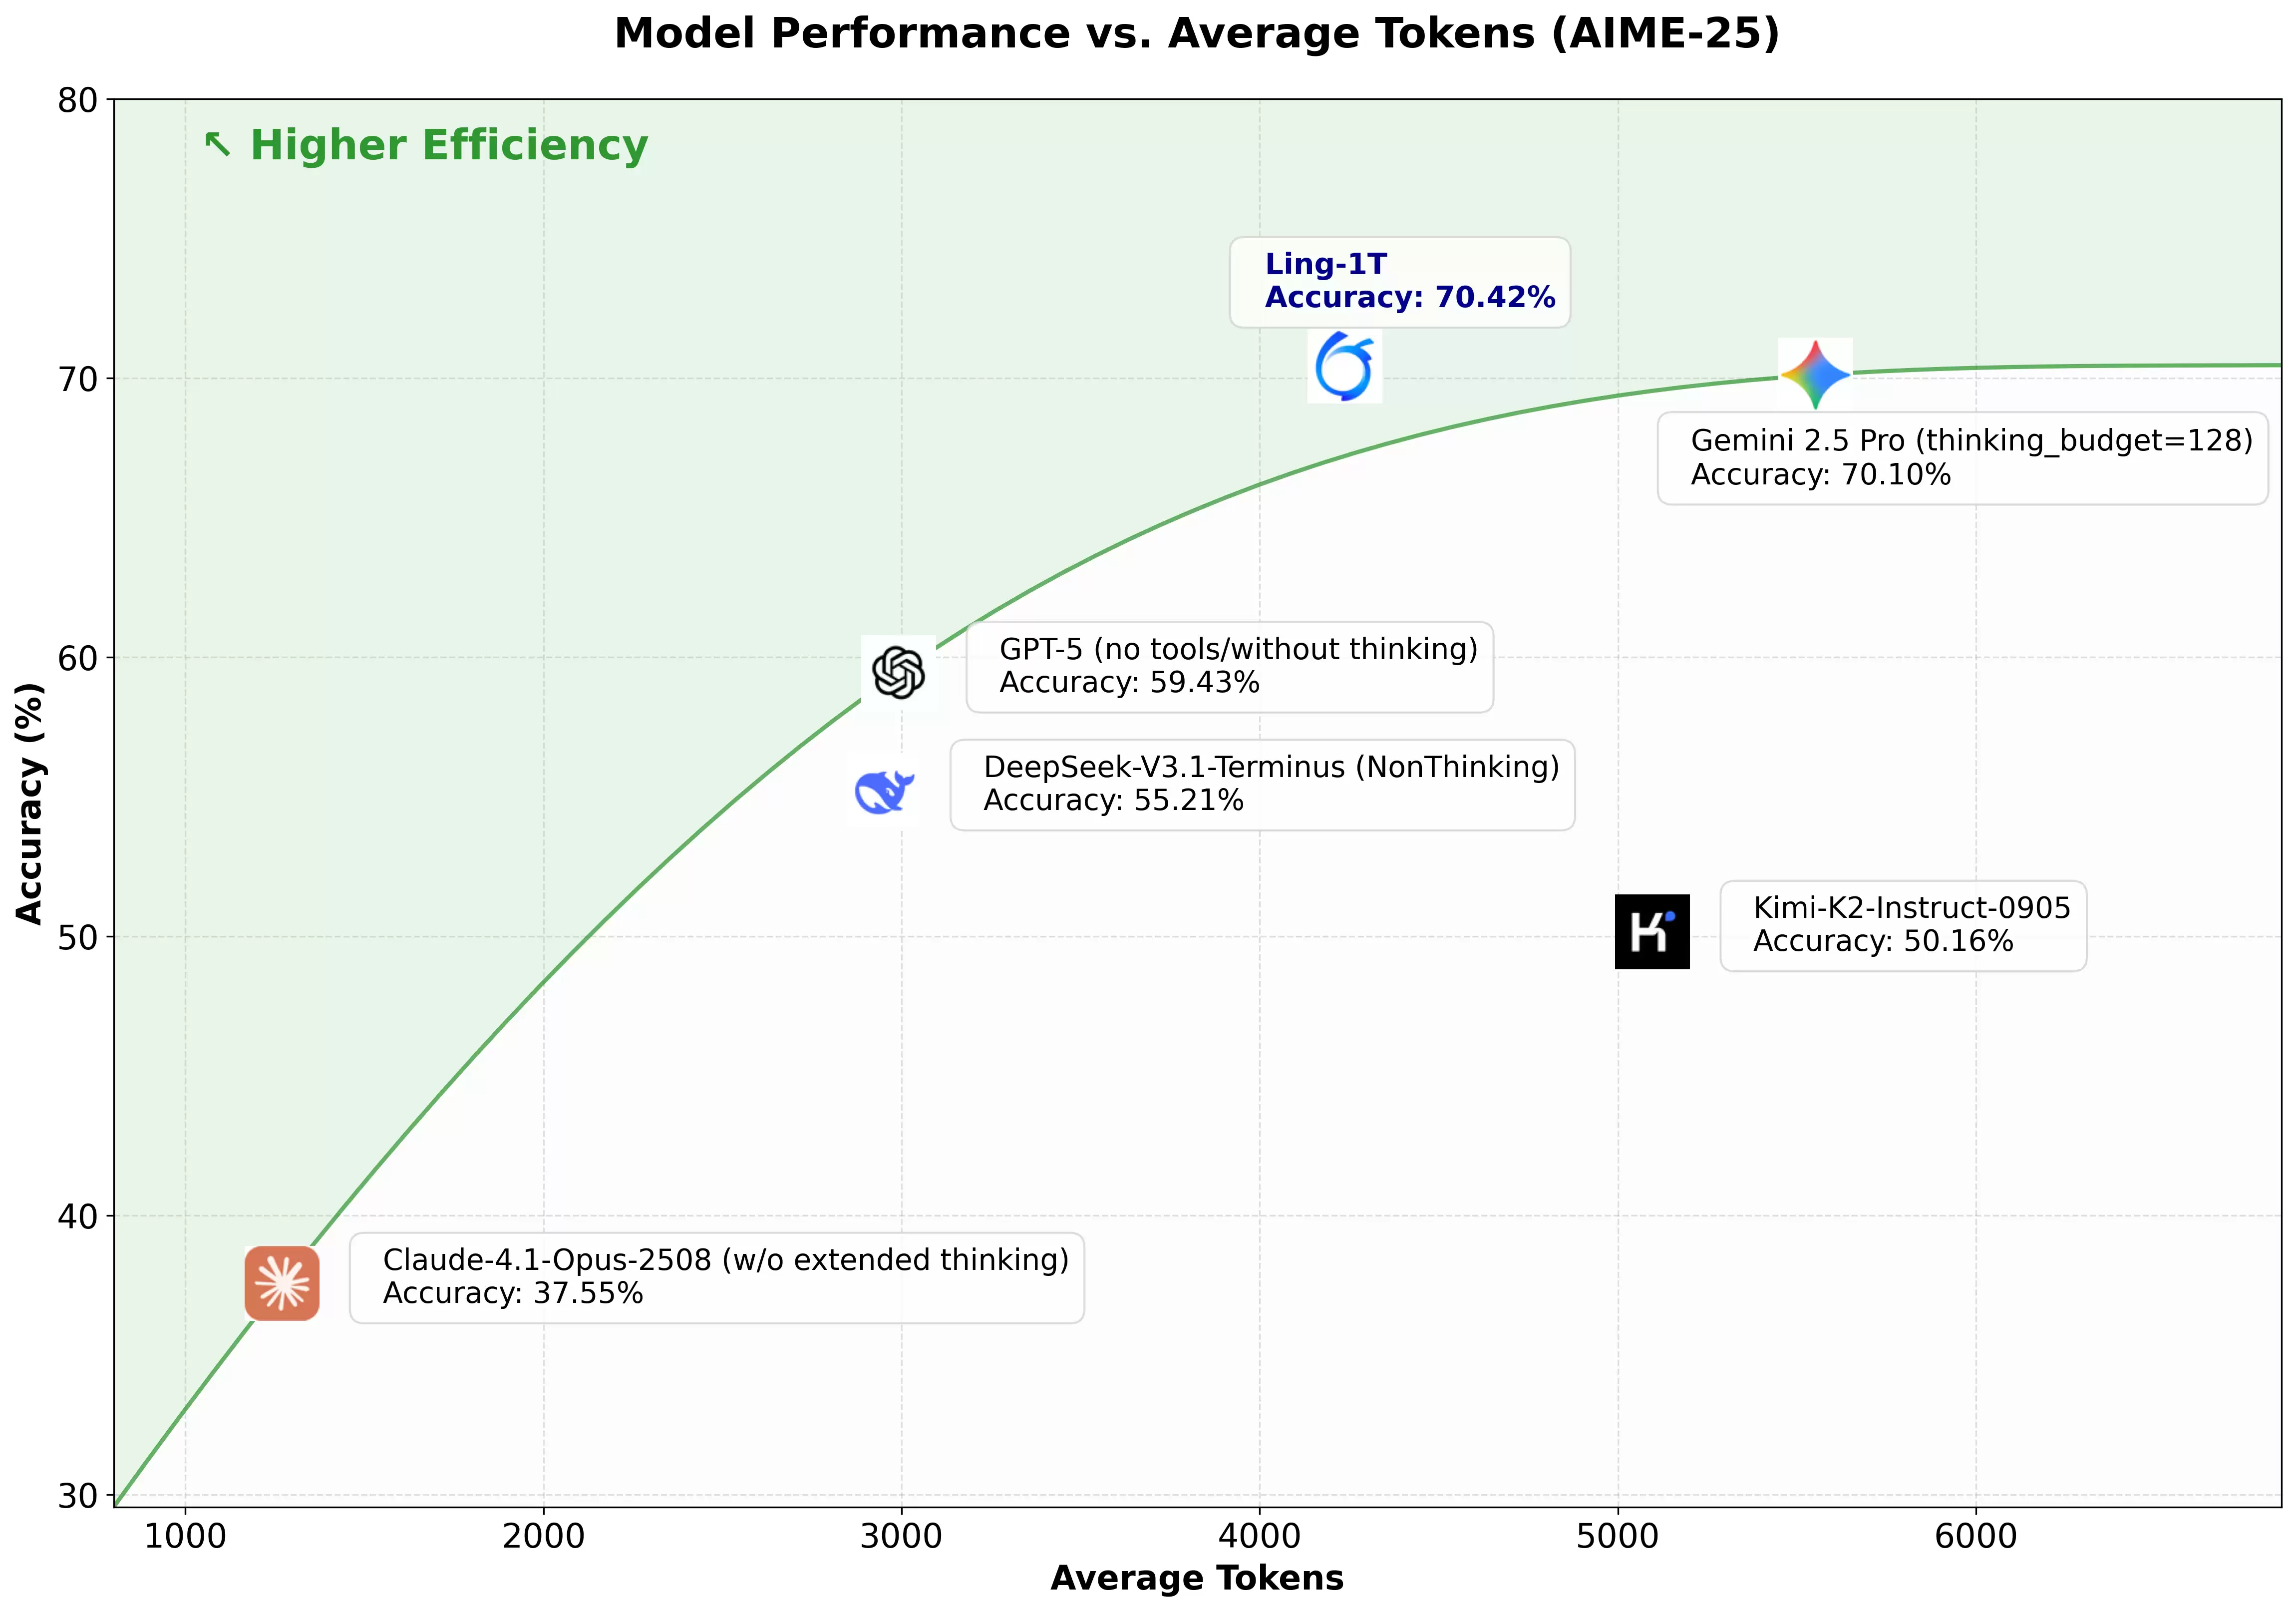
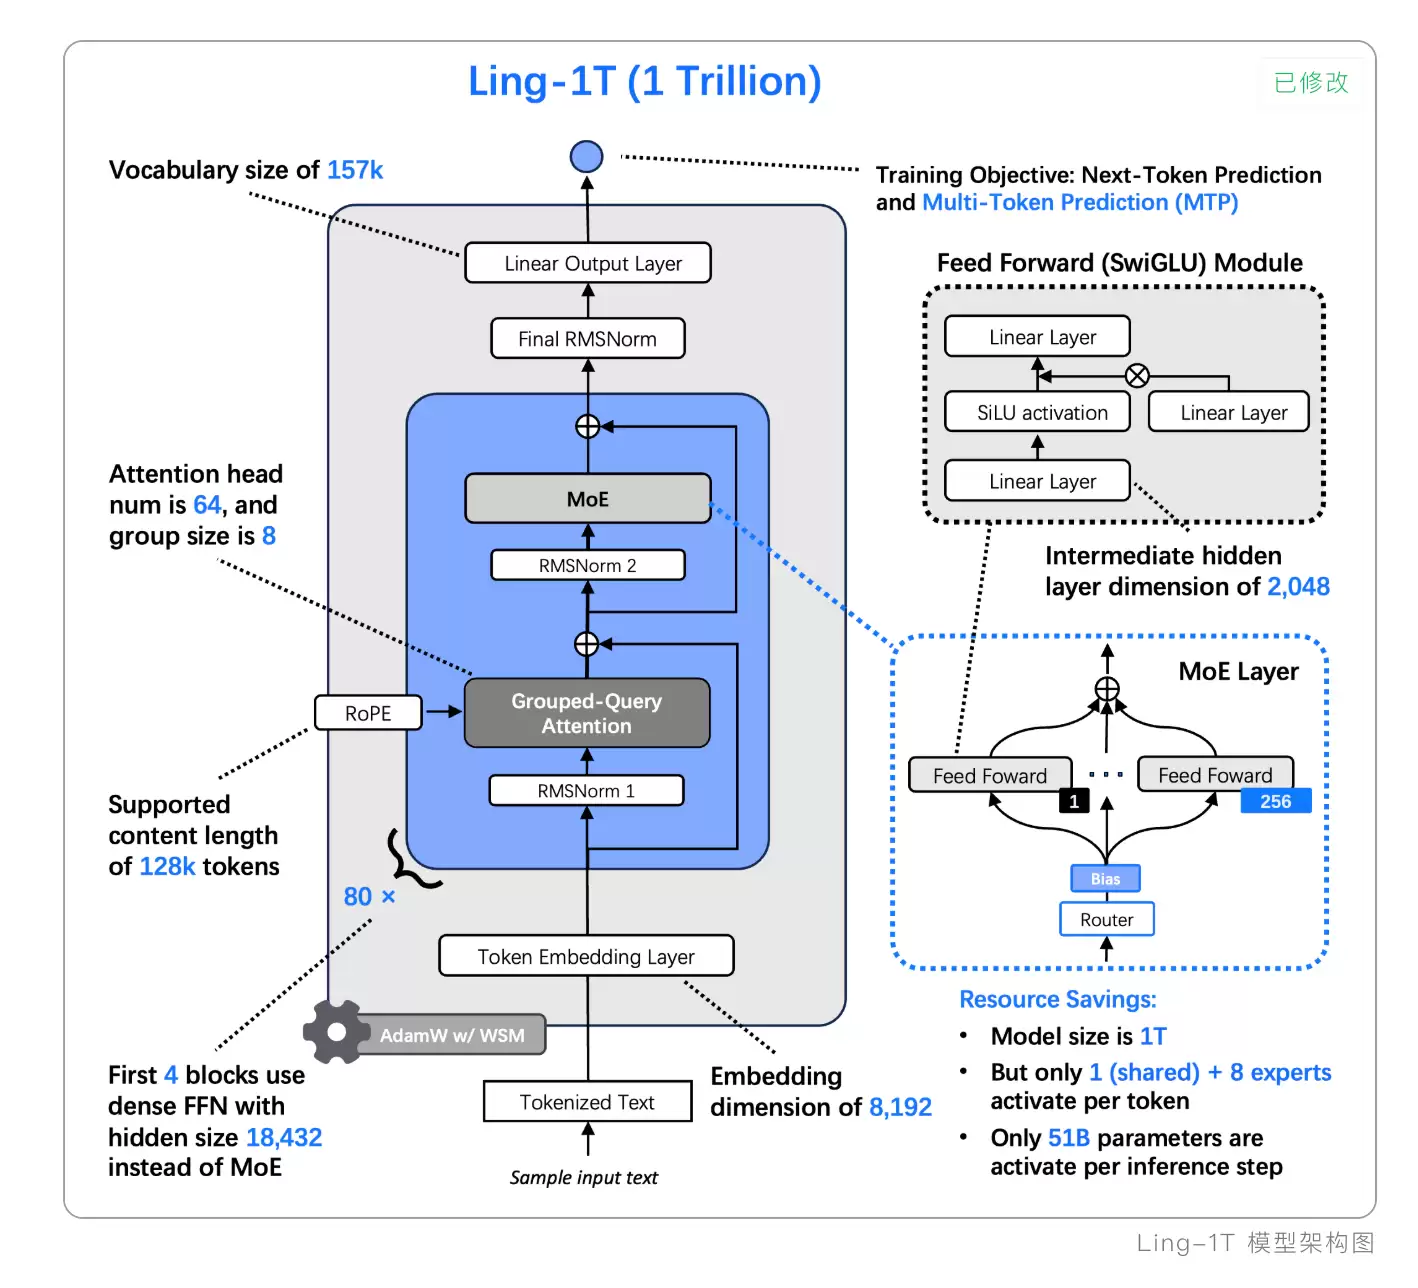
与DeepSeek-V3.1-Terminus、Kimi-K2-Instruct-0905(开源版)以及GPT-5-main、Gemini-2.5-Pro(闭源版)这些顶级模型同台竞技,Ling-1T展示了更短的思考路径和更高的推理准确率。它具备处理128K长文本的能力,而每个token激活的参数量却控制在约500亿,这在效率上是一个显著优势。
这份成绩单背后,是蚂蚁百灵团队长期的技术积累与创新。模型依托团队储备的二十万亿Token高质量文本语料进行训练,“吃”进了海量优质知识。在预训练阶段,团队创新地让模型依据“Ling Scaling Laws”自我设置关键超参数,实现了大模型的自我优化。在强化训练阶段,则引入了团队原创的LPO策略优化算法,让模型的回答更精准。此外,团队还提出了“语法-功能-美学”的混合奖励机制,提升了模型的输出“审美”。下图是工程师绘制的Ling-1T模型架构示意图:
事实上,蚂蚁已经构建起一个完整的百灵大模型家族。从参数规模看,涵盖了从160亿到1万亿的总参数产品矩阵;从模态能力看,包含了能看、能听、能说、能画,理解与生成统一的多模态模型;从应用场景看,则形成了可在手机端运行的Ling-mini、适合中小企业服务器部署的Ling-flash,以及云端调用的Ling-1T等系列。
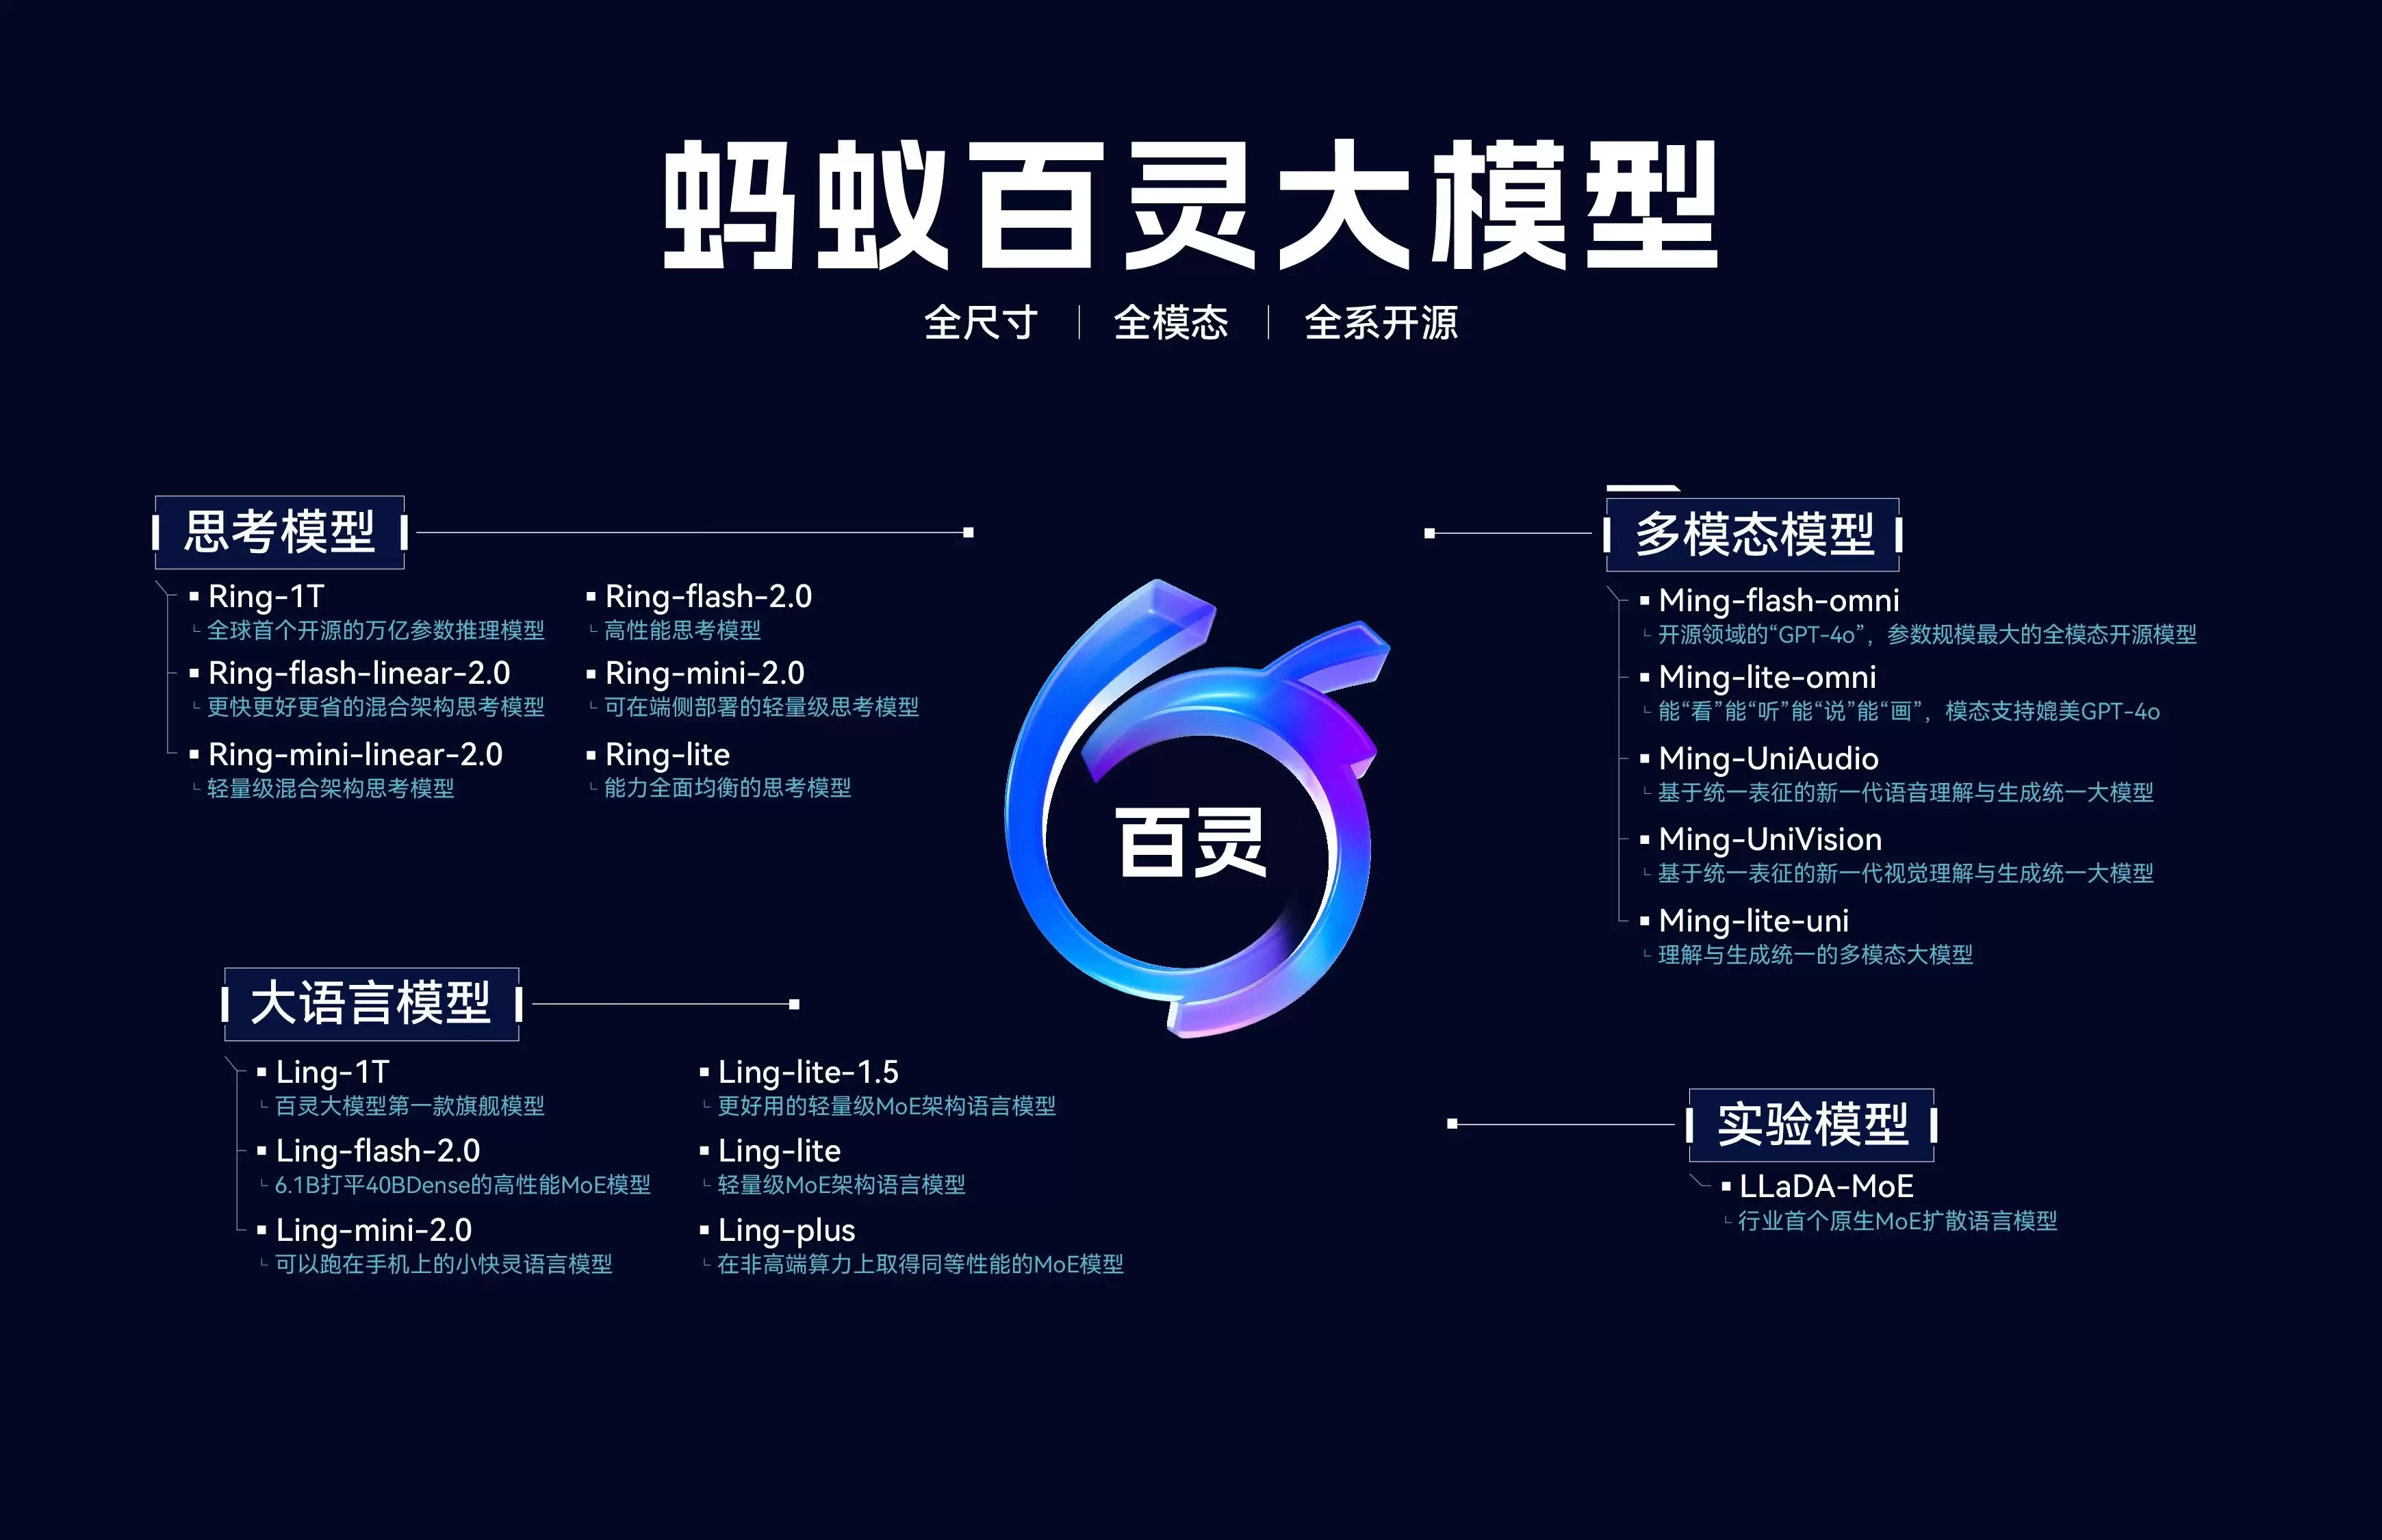
这个家族在过去一段时间里,无论是社区评测榜单还是实际应用反馈,都获得了不少积极回应。百灵团队开发的全模态模型Ming-lite-omni v1.5,曾在Hugging Face的“any to any”模型趋势榜上登顶。Ring-1T-preview发布次日,便冲上Hugging Face文本生成总榜第三,而排名第四的同样是百灵家族9月发布的混合架构思考模型Ring-flash-linear-2.0。
更值得一提的是业界的真实声音。图灵奖得主杨立昆(Yann LeCun)甚至点赞并评论“Impressive”(了不起),了解这位对LLM时常持批评态度的大佬的网友都表示,这声夸奖“来之不易”。一位苹果工程师在量化并本地运行模型后评价,其性能“Getting closer to GPT-5 at home”(在本地部署上已接近GPT-5)。这些来自一线技术开发者的反馈,无疑是对百灵模型实力的有力背书。
探索AGI,亟需参与者们的共建意识
百灵团队能如此迅速地跻身“万亿俱乐部”,与蚂蚁集团的整体战略投入密不可分。作为一家成立二十年的科技公司,蚂蚁在AI领域的布局决心和资源投入一直不容小觑。
去年蚂蚁二十周年时,董事长井贤栋明确宣布,未来二十年,蚂蚁要成为一家科技与创新双轮驱动的公司。集团随后提出的“AI First”战略,与“支付宝双飞轮”、“加速全球化”并列,成为驱动蚂蚁前进的三大核心战略。Ling-1T和Ring-1T-preview的接连亮相,正是“AI First”战略持续加速落地的鲜明注脚。
然而,蚂蚁选择的不是闭门造车的闭源道路,而是技术共享的开源路线。这足以表明,其目光投向的是更远的未来:通过技术开放,持续迭代,构建一个真正繁荣、开放的AGI(通用人工智能)生态。
据行业观察,目前“万亿参数俱乐部”中,能做到完全开源的,仅有蚂蚁百灵的Ling-1T、Ring-1T-preview和Kimi的K2。在2025年大模型参数“军备竞赛”白热化的背景下,投入巨资研发后却选择开源,初看确实令人费解。
但若理解开源背后的深层逻辑,便会豁然开朗。当Ling-1T这样的万亿参数“巨兽”公开其训练数据、算法和模型细节,全球开发者便能直接以此为基础,快速构建复杂应用,而无需从零开始攻克底层训练的难题。一个“使用-反馈-迭代”的正向循环由此建立,这将极大推动技术的共同演进,加速智能的“涌现”。这条“技术平权化”的道路,其实已有先行者。今年年初DeepSeek的横空出世,就已经为国内大模型玩家们示范了开源所能激发的巨大能量。
今年接任蚂蚁集团CEO的韩歆毅,曾在内部技术日上清晰地阐述了蚂蚁的AI主张:“年初我们讨论(蚂蚁)聚焦AI应用,还要不要做基础大模型时,答案非常坚决:一定要做。因为如果基于AI做服务和应用,就像训练一个人去做所有的事。追求智能的上限,会让这个人更加聪明,从而能够做更多、更好的服务。我们坚定地要去探索AGI,探索智能的极限。”
为此,蚂蚁专门成立了InclusionAI开源组织,并建设了涵盖强化学习推理框架AReaL、多智能体框架AWorld等在内的大模型全栈技术体系。这些技术成果也已通过开源、开放合作的形式与行业共享,旨在让更多的创作者能够交流、共创。
看得出来,相比于自己登台唱独角戏,蚂蚁更倾向于搭好一个宽阔的戏台,铺设好AI的基础设施。因为只有生态繁荣了,才能吸引更多的参与者共同建设,那条通往AGI的道路,也才能真正走得通、走得远。