

美团LongCat实测:速度极致但未追平DeepSeek
美团LongCat-Flash-Chat模型响应极快、成本低,适合轻量交互,但在复杂任务中逻辑性与重点把握不足,与DeepSeek-V3.1等模型存在差距,限制了其在严肃高价值场景的应用深度。
近期,AI领域的热点话题之一,是美团发布的首款开源大模型LongCat-Flash-Chat。不少讨论将其与DeepSeek-V3.1相提并论,甚至有观点认为两者能力已不相上下。
实际情况究竟如何?我们不妨透过热度,客观审视这款模型的真实表现。
首先,模型定位明确。LongCat-Flash-Chat是一款面向日常对话与轻量问答的中量级模型,总参数量为560B,略小于DeepSeek-V3.1的671B,两者均采用MoE架构。但设计目标存在明显差异:前者极度强调低延迟与高并发下的流畅体验,后者则在逻辑推理与复杂问题处理上更具优势。
“快速”是LongCat最突出的特点。其近乎零延迟的响应体验,给许多初次使用的用户留下了深刻印象。但随之而来的问题是:这种速度优势,在面对需要深度思考的推理任务时,是否依然能保持?还是说,一旦脱离单纯比拼响应速度的范畴,其能力短板便会显现?
为了探究答案,我们对LongCat-Flash-Chat进行了一系列实际测试,试图剥离市场声音,评估其在速度光环之下的综合能力。
响应迅速,但推理能力存在短板
首先值得肯定的是其响应速度。在测试中,无论是简单问候还是基础计算,LongCat几乎都能实现“秒回”。例如询问“24×37等于多少”,答案瞬间呈现。
这种快速并非偶然,而是软硬件协同优化的结果。一方面,模型本身采用更轻量的设计,计算负担相对较小;另一方面,美团在工程层面进行了大量延迟压缩和高并发优化,确保即使面对大量请求,响应依然流畅。简而言之,模型更轻、系统更顺,共同造就了这种极速体验。
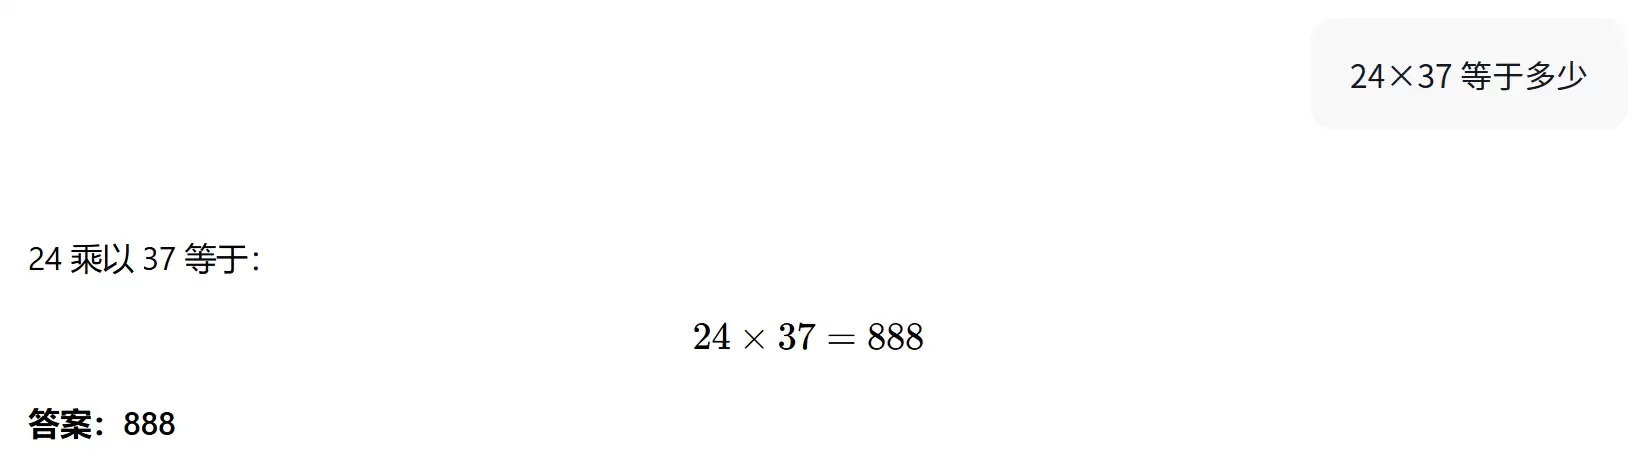
相比之下,DeepSeek在云端推理优化方面同样出色,速度不慢,但用户能感知到其“思考”过程,答案的输出更有条理。
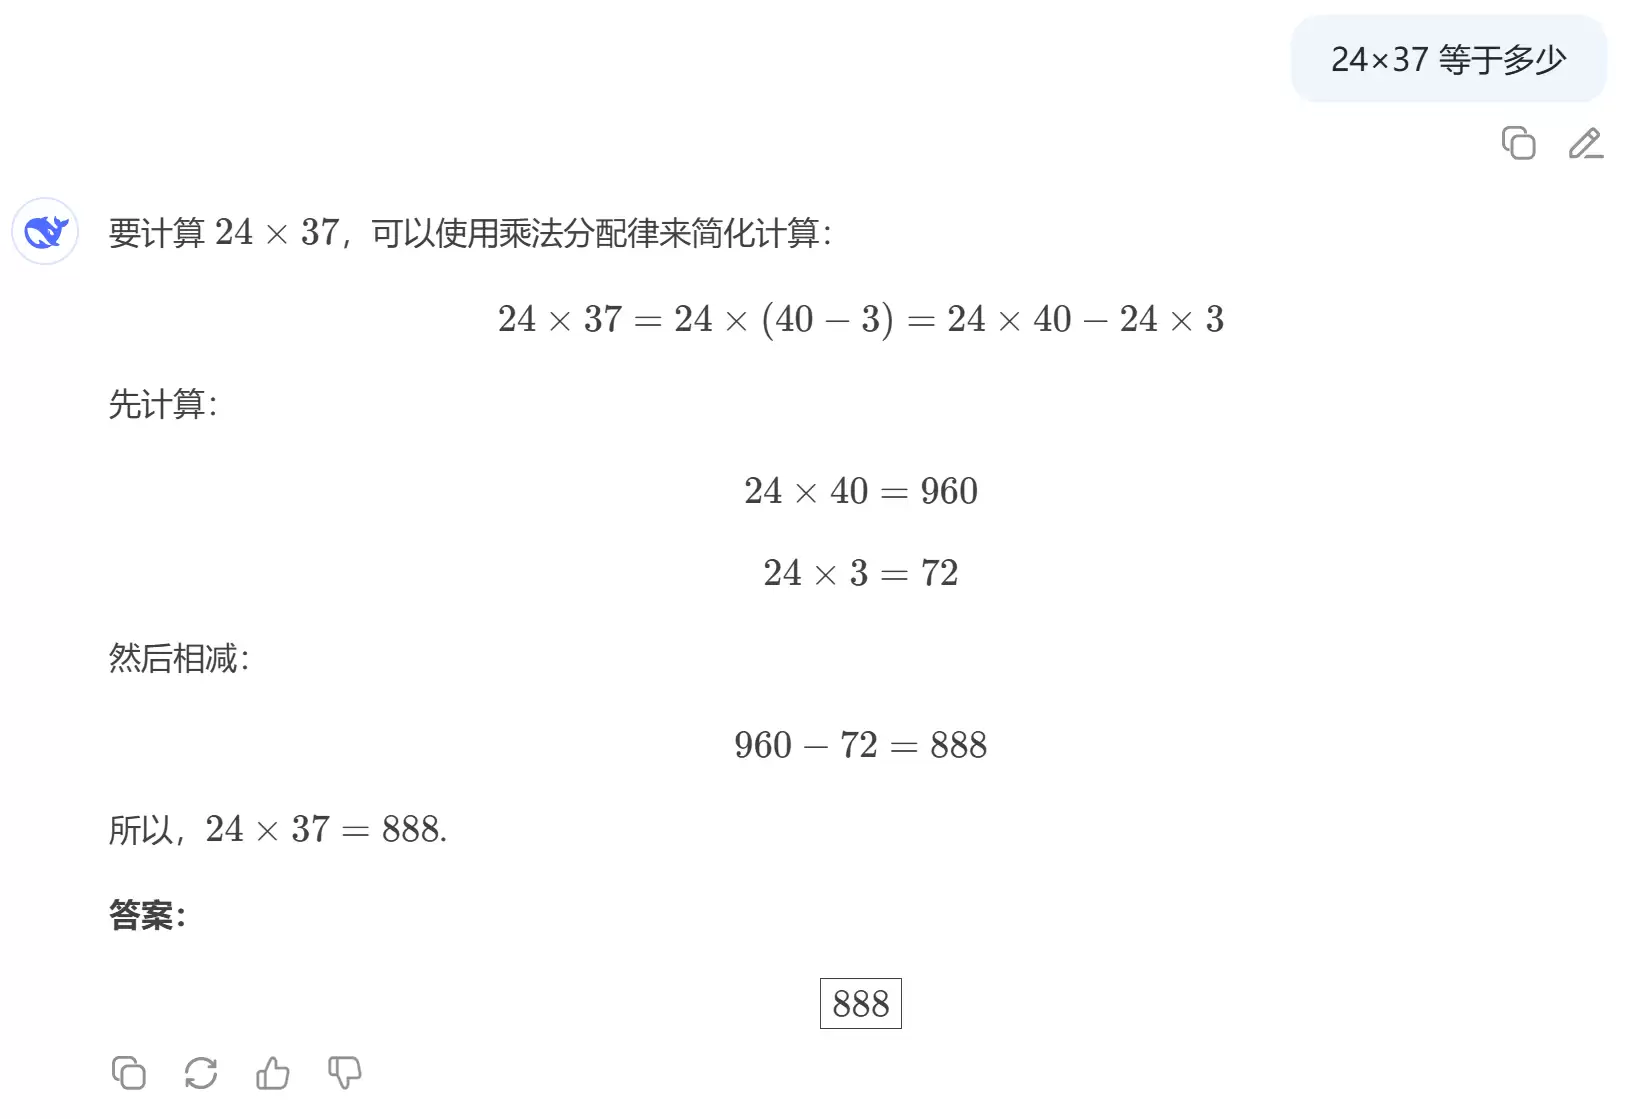
一个侧重稳定可靠,一个追求极速响应,风格差异明显。单就响应速度而言,LongCat确实能提供更即时的反馈。
这种速度可以量化。根据公布的数据,在H800硬件上,它能实现单用户超过100 tokens/秒的生成速度,同时输出成本低至5元/百万token。这一速度显著超越了同期许多主流模型,例如Llama 3的约80 tokens/秒(单卡RTX 4090),以及DeepSeek-V3.1和Gemini 2.5 Pro的约40 tokens/秒(通常需多张高端GPU)。在“快”这个维度上,LongCat目前处于领先位置。
然而,当任务进入需要稍加思考的推理环节时,LongCat的短板开始显现:其回答往往试图覆盖所有可能角度,导致信息过载、重点模糊,阅读负担较重。
而DeepSeek的答案则显得灵活且聚焦。它能迅速抓住问题核心,逻辑清晰,阐述有条理,有时还带有巧思,读起来更为顺畅。
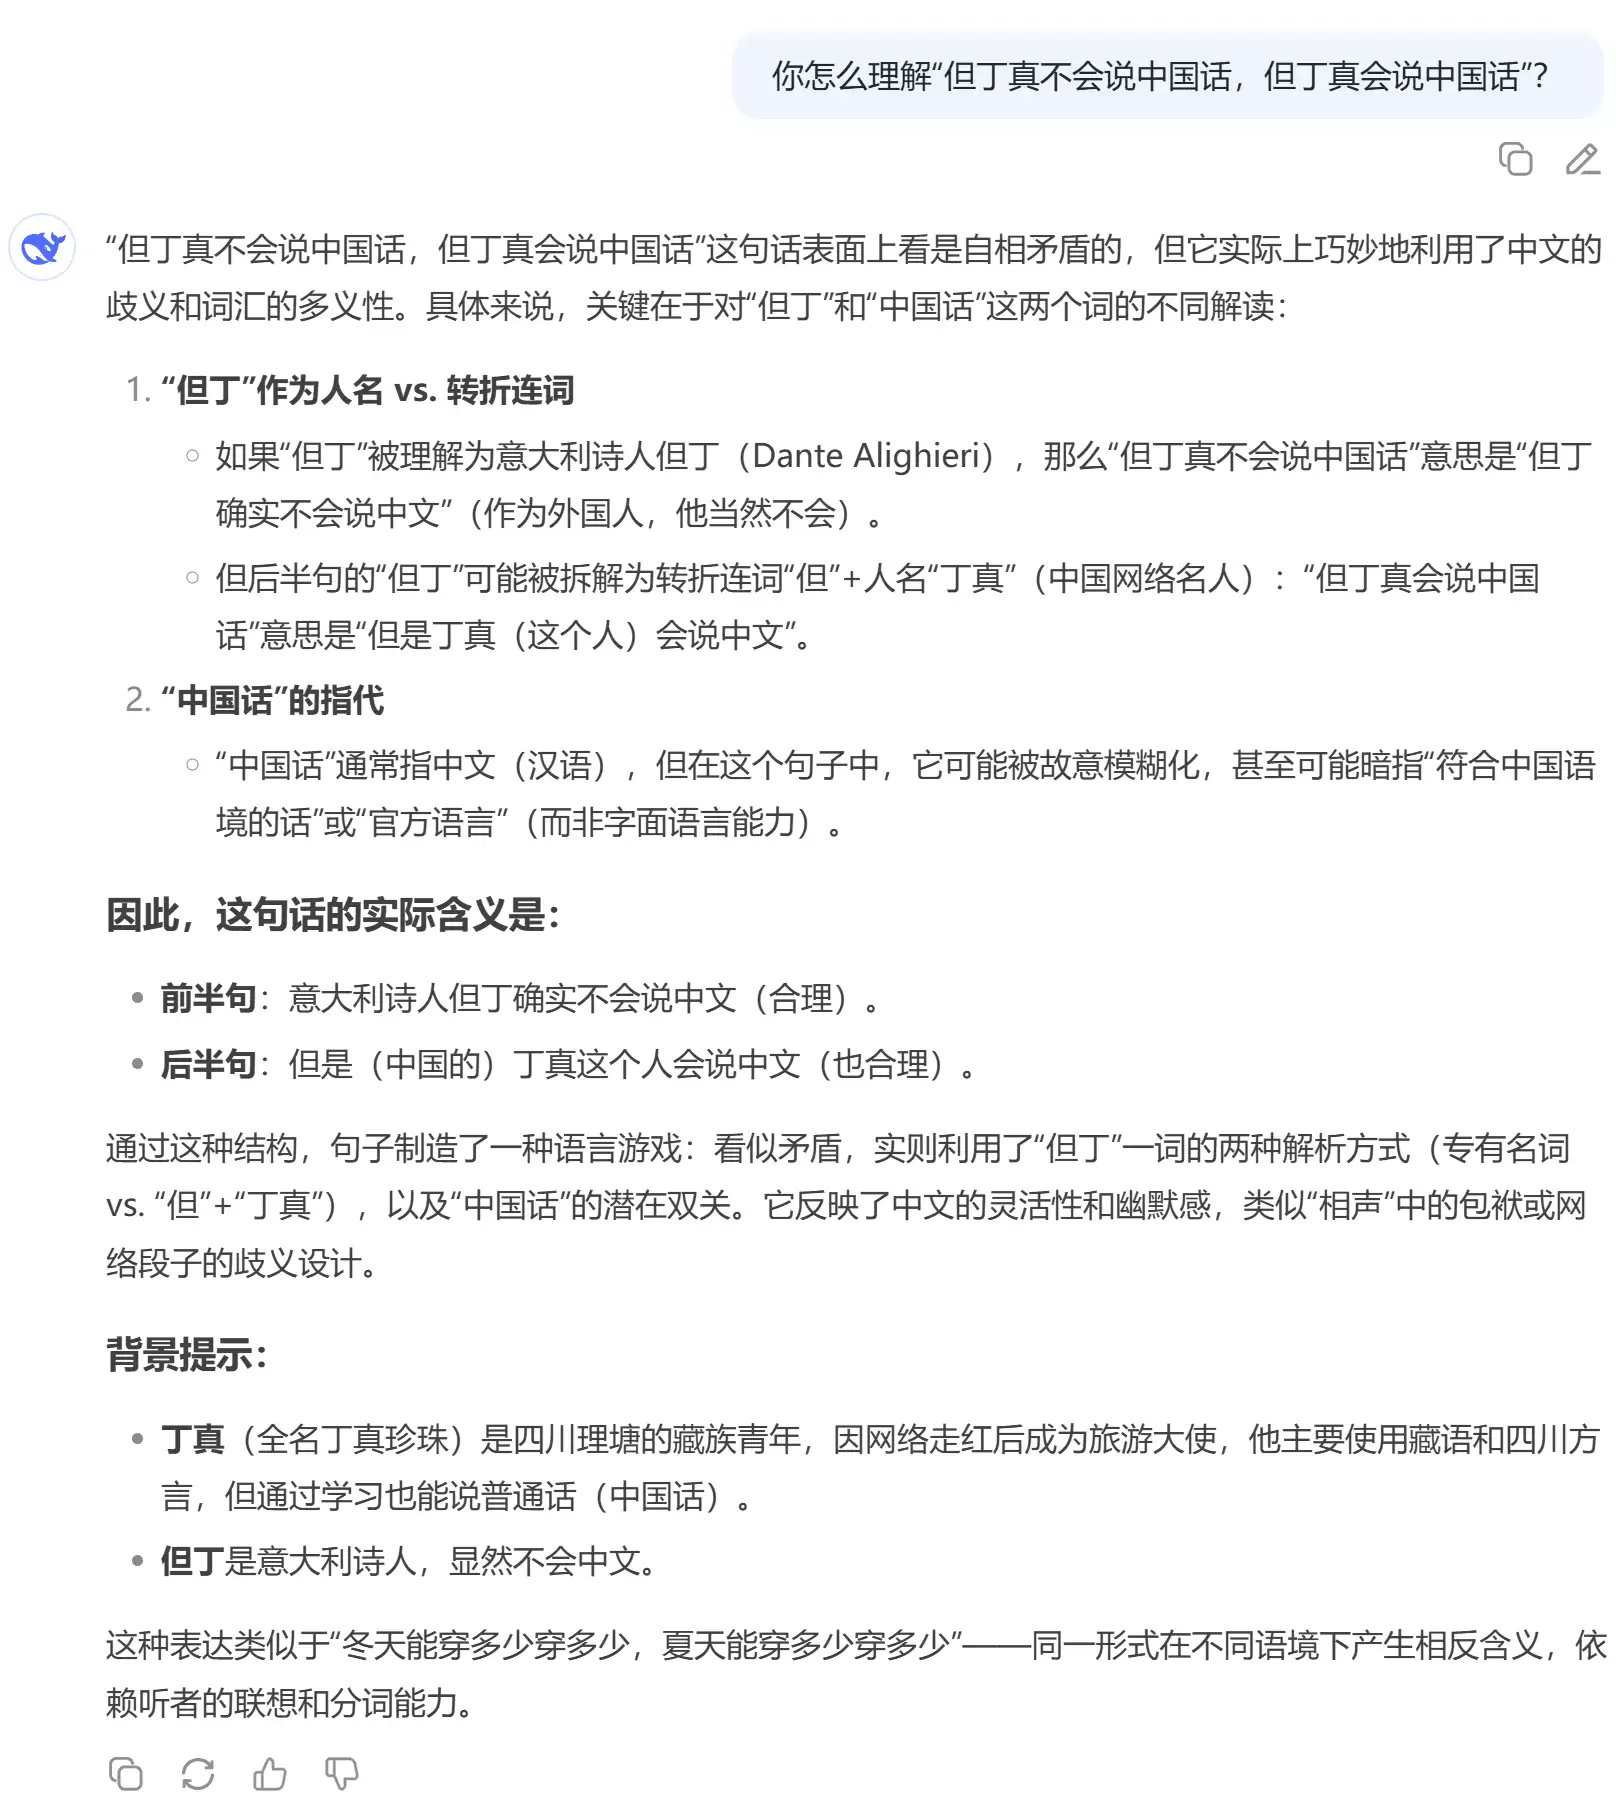
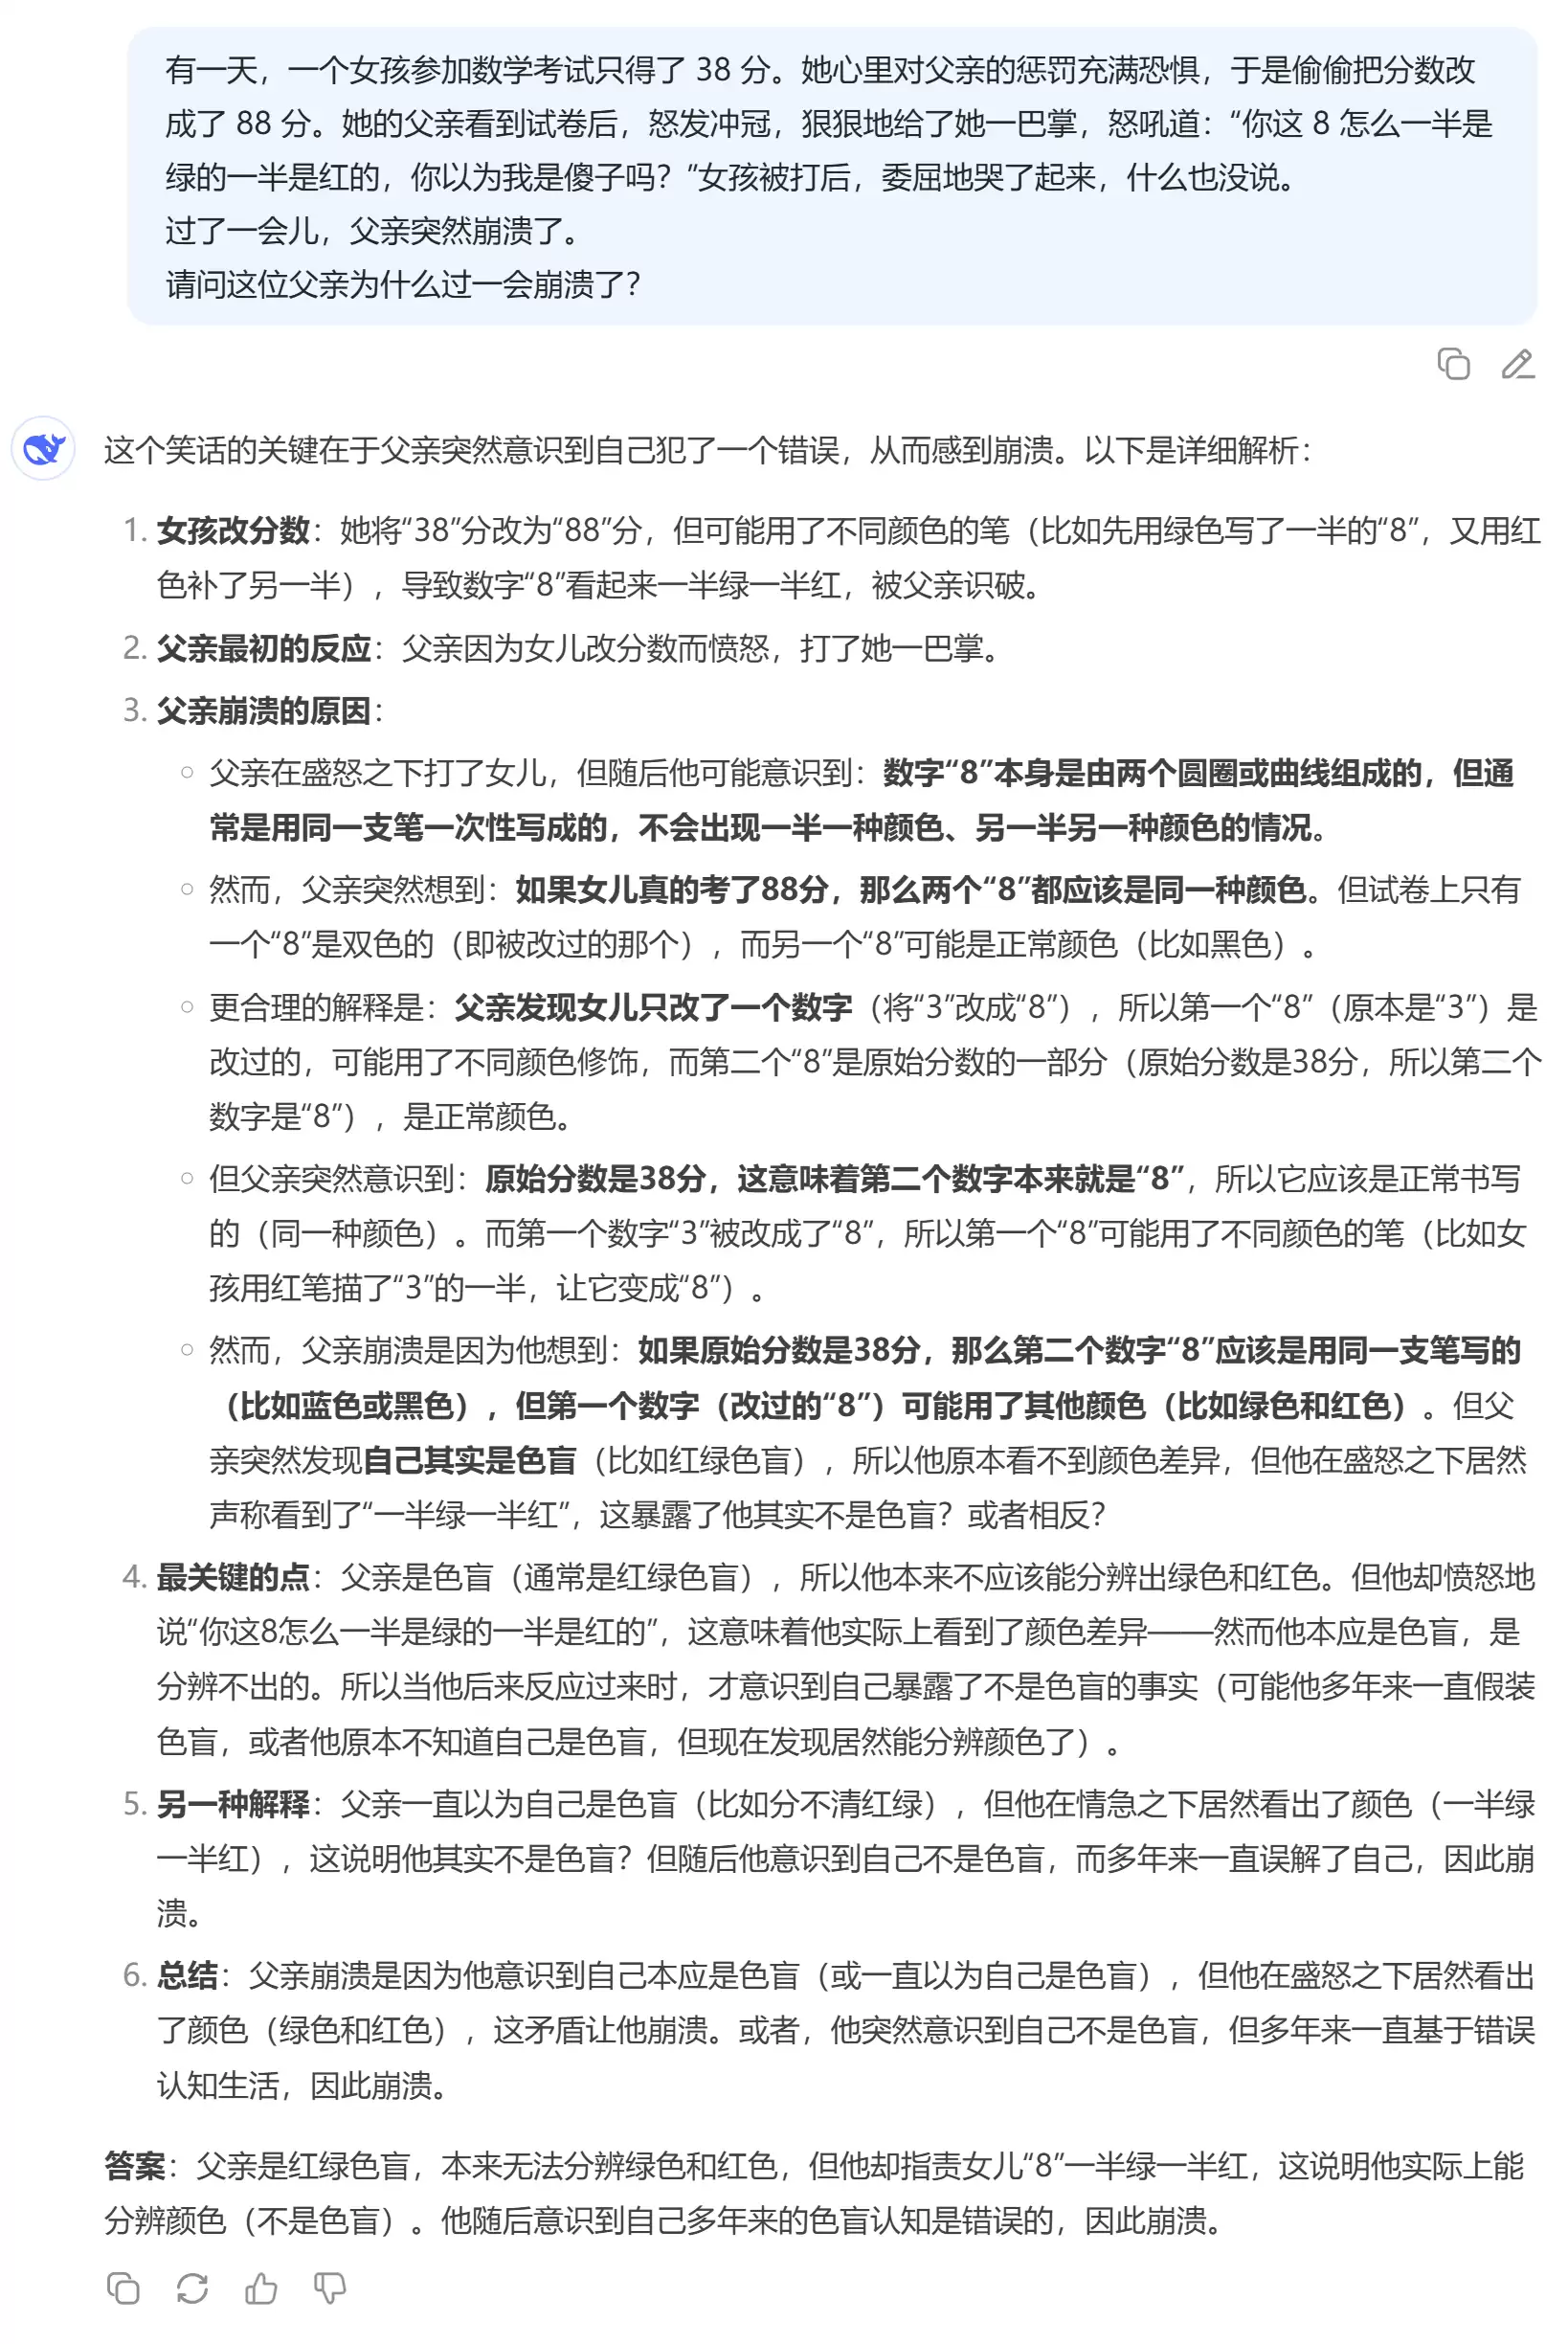
在更复杂的逻辑测试中,这种差距进一步扩大。以经典的“半红半绿的8”故事为例:一名女生考试得38分,偷偷改成88分,被父亲发现后挨了一巴掌。父亲质问:“你的8怎么一半是红的、一半是绿的?”
LongCat的回答依然很快,但内容更像是心理学、教育学、文化背景等各种标签的罗列。它谈及“父亲对数字真实性的怀疑”、“女儿的成绩压力”、“教育方式的失败”、“严厉家风的映射”等,看似全面,却缺乏一条紧密的逻辑链条将各点串联起来,读起来像是理由的堆砌,而非因果的推理。
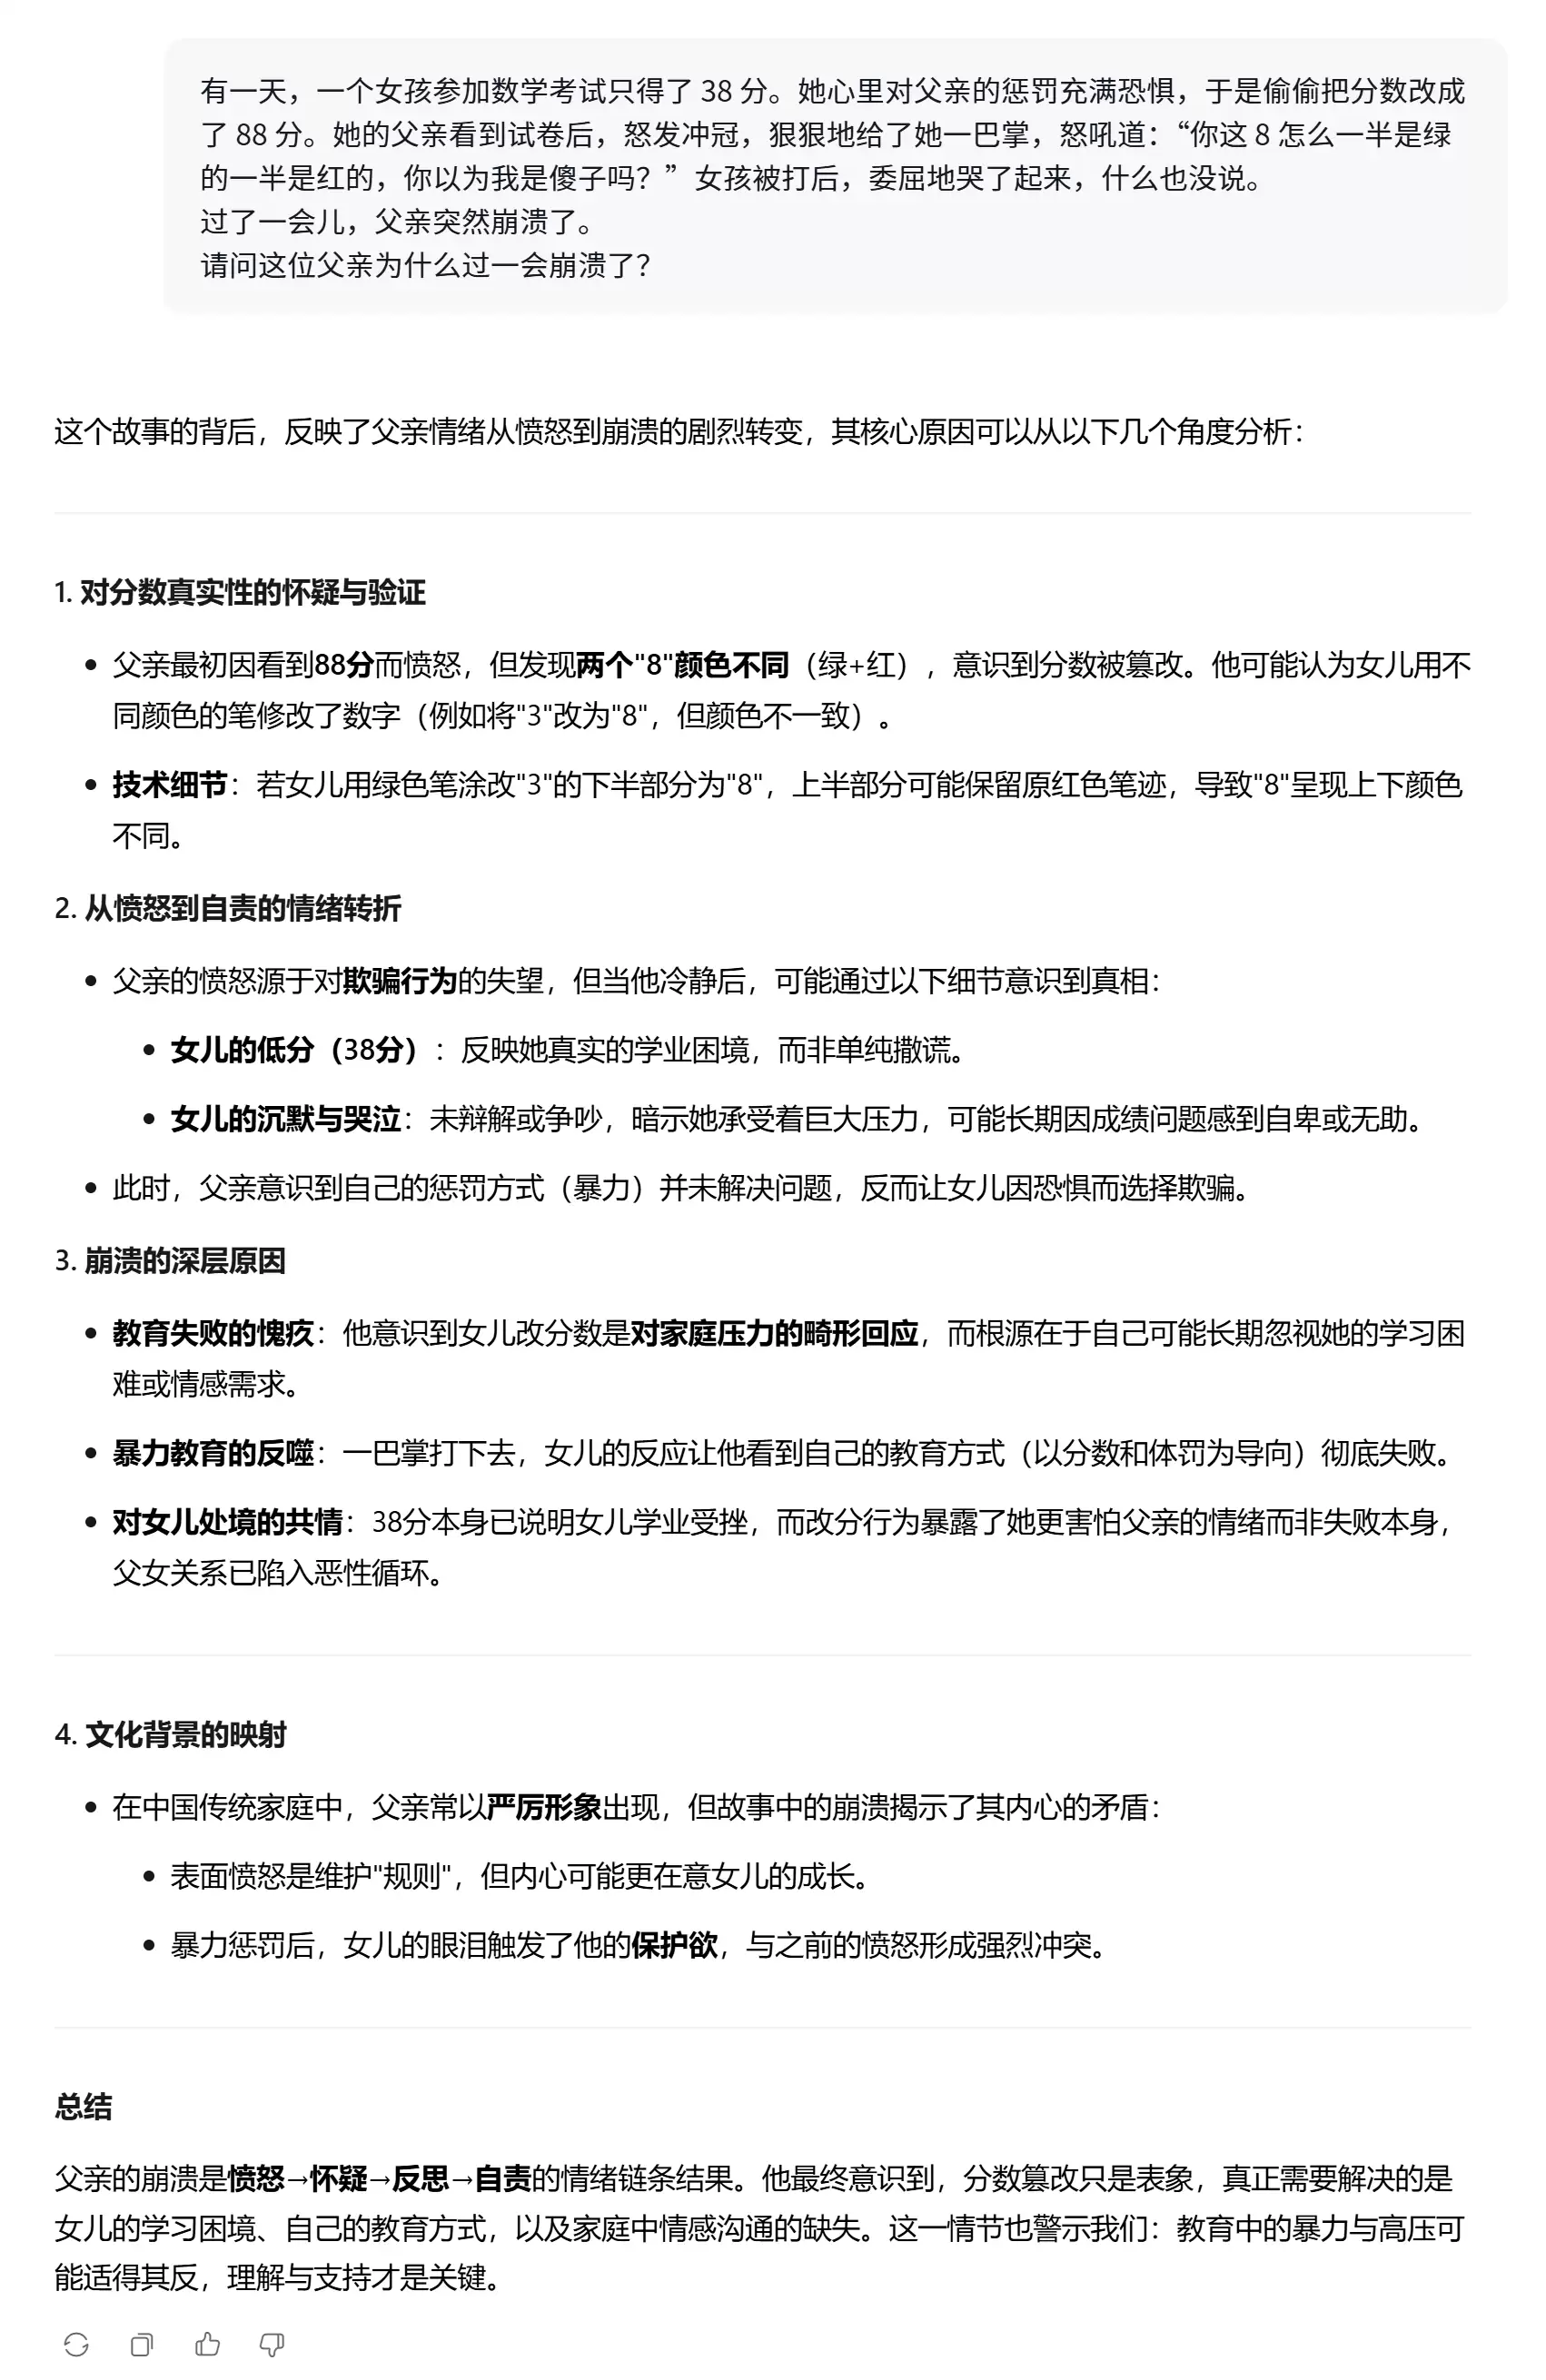
DeepSeek的思路则更为扎实。它紧扣故事细节,逐步推理出父亲为何能从“半红半绿的8”察觉异常:先指出“38”被改成“88”时,可能因使用不同颜色的笔导致数字颜色不一致;进而分析父亲的愤怒源于对作弊行为的失望,而非简单的改分;最后深入剖析这种失望背后,是父亲将女儿视为自身延伸的情感投射,以及由此产生的认知落差与教育挫败感。整个过程逻辑严密,因果清晰,更贴近故事内核。
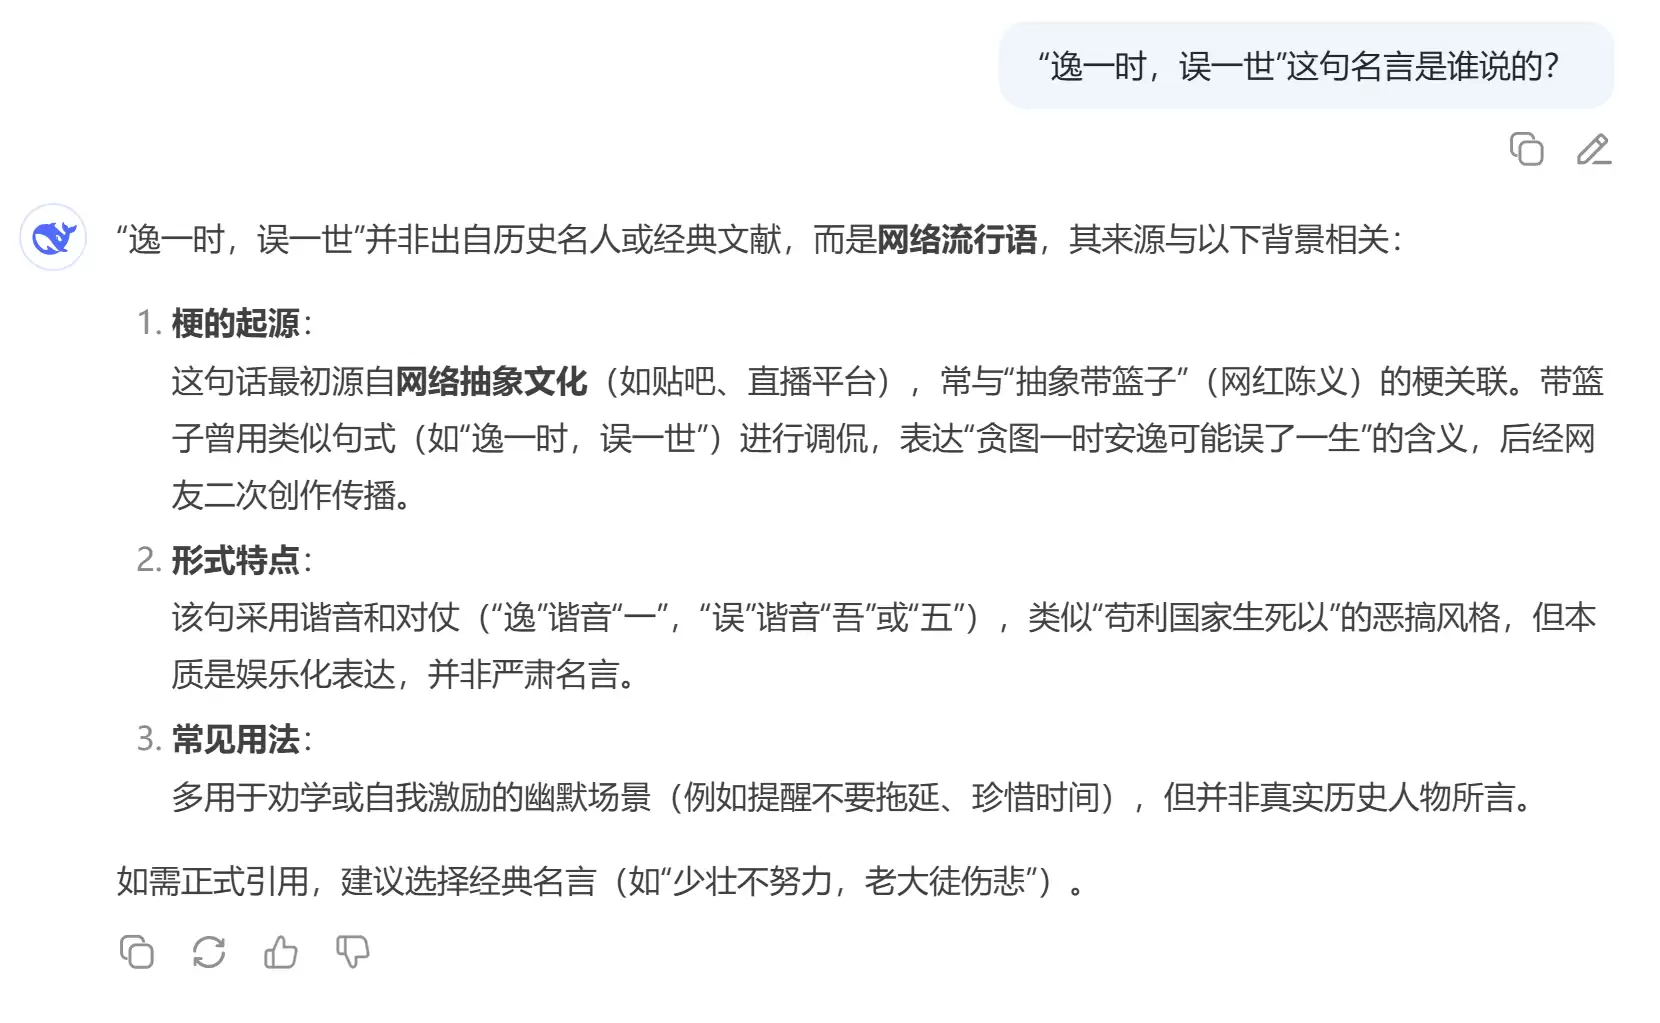
在考察模型抗干扰和精准理解能力的测试中,差距同样明显。面对“逸一时,误一世”这句话,LongCat延续了“百科式”作答风格,将网络流行语、文学创作、影视台词、日语翻译等多种可能性逐一列出并解释,信息量虽大,却缺乏明确的判断和推理,读者难以得到清晰结论。
DeepSeek则直接点明这是网络流行语,并清晰交代了其来源背景、语言特点和常见用法,结论明确,逻辑完整,一目了然。
再看基础的拆词任务。两个模型都能正确完成,但风格迥异。LongCat的回答像细致的“老实人”,会逐个字母判断是否为“r”,并附上视觉高亮和错误提醒,细节丰富但略显冗长。DeepSeek的答案则干净利落:直接写出单词,标出“r”的位置,给出最终答案,逻辑紧凑,直击核心。
速度与逻辑,孰轻孰重?
测试结果已相当清晰:美团LongCat-Flash-Chat在响应速度上优势显著,能带来即时满足的体验;但在需要深度推理的场景中,其表现则迅速黯淡。相比之下,DeepSeek虽然响应稍慢,却在逻辑拆解、因果梳理上表现得更稳健、更令人信服。
这引出一个更深层的问题:在实际应用场景中,用户究竟更在意“速度”,还是更在意“逻辑的可靠性”?
速度带来的惊艳感是直观的。毫秒级的响应,在闲聊、轻度娱乐等场景中,确实能营造流畅的互动体验,迅速吸引用户。但用户心理也很微妙:如果答案本身不靠谱,那么速度越快,带来的落差感和失望感反而可能被放大。这种由速度建立的爽感,其持久性存疑。
逻辑的可靠性,则决定了模型能否走得长远。它不仅是处理复杂任务的基石,更是用户建立信任的前提。一个能清晰阐述因果、步步为营的模型,即便回答慢上几秒,也更容易被认定为“可靠”。这在知识问答、辅助写作、研究分析、商业决策等价值更高的场景中尤为关键,因为用户需要的不仅是一个结果,更是一个能够解释“为什么”的结果。
这也隐约划出了模型发展的不同路径。极度追求速度的模型,可能更多地停留在娱乐化、陪伴型的浅层应用里,其生命周期和用户留存高度依赖新鲜感。而强调逻辑与深度的模型,则有潜力切入教育、科研、企业办公等高价值领域,在这些场景中,准确性与可解释性远比响应时间那几毫秒的差异更为重要。
从商业角度看,逻辑能力甚至直接关系到客户是否愿意付费。企业用户或许可以容忍响应稍慢,但绝不能容忍输出不可靠或无法解释。速度是体验的加分项,而逻辑往往是交易的底线。长远来看,深厚的逻辑能力可能构成模型真正的护城河,而速度优势更多是阶段性的技术亮点。
简而言之,速度决定了模型能否第一时间吸引用户,制造惊艳;而逻辑决定了它能否真正留住用户,赢得信任,并最终在更严肃、更高价值的赛道中立足。
必须公允地说,LongCat-Flash-Chat作为美团在开源大模型领域的首次亮相,能将“速度”做到如此极致,本身就是一次大胆且令人印象深刻的技术尝试。其在交互体验上的突破,确实为行业带来了新的视角。只是,若将其置于复杂推理、深度分析等更具挑战性的场景中衡量,它目前的表现距离DeepSeek-V3.1那样的稳健可靠,尚有差距,更谈不上“追平”。
可以说,LongCat-Flash-Chat已经漂亮地打出了一张“速度牌”,证明了美团有实力在模型赛场上留下自己的名字。但要从“惊艳”走向“好用”与“实用”,它面前还有一段需要扎实耕耘的路程。