

吴琦:VLN与VLA的挑战与前景分析
2018年,吴琦与合作者开创视觉-语言-导航(VLN)研究,后扩展为视觉-语言-动作(VLA)概念。他指出,尽管当前具身智能聚焦操作任务,但室内动态环境中的导航仍是关键挑战。团队持续深耕VLN在真实机器人上的应用,并指出数据稀缺、仿真器不完善及高质量3D环境构建是领域发展的主要瓶颈。
2018年6月,澳大利亚机器人视觉研究中心(ACRV)的一项研究,首次将视觉-语言(VL)技术与当时机器人领域的主流方向——导航——联系起来。这项由博士后研究员吴琦与博士生Peter Anderson完成的工作,在CVPR 2018上发表了视觉-语言-导航(VLN)领域的首篇论文。几乎同时,Abhishek Das作为第一作者发表的“EmbodiedQA(具身问答)”工作,则让“具身”概念进入了更多研究者的视野。
一个月后,在墨尔本举行的ACL会议上,一场由这三位研究者主讲的“将语言和视觉与动作联系起来”的教程,正式为视觉-语言-动作(VLA)这个全新领域拉开了序幕。
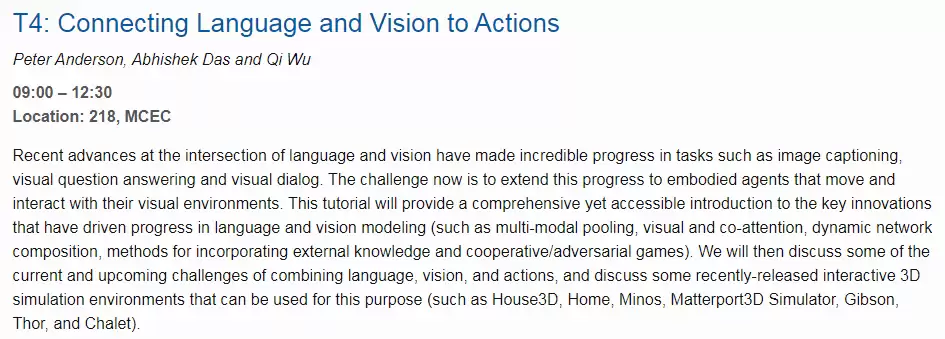
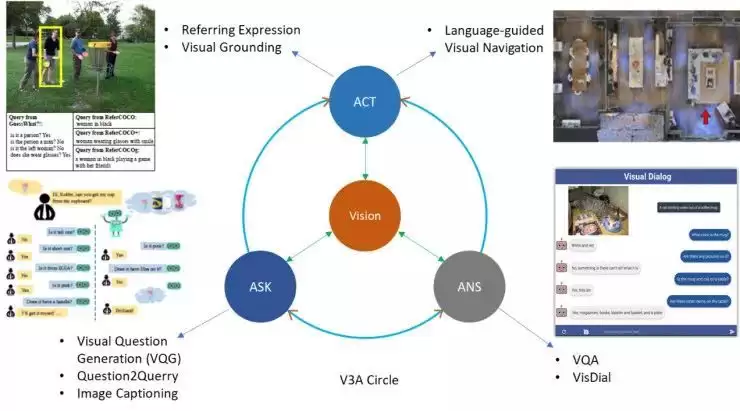
会上,众多自然语言处理学者对这个新方向表现出浓厚兴趣。除了介绍CNN、RNN等基础方法,三位讲者也分享了他们对机器人数据、环境仿真器以及强化学习应用的看法。正是对VLN的深入探索,让吴琦意识到,机器要解决实际问题,不仅需要理解和学习多模态信息,还必须能与真实环境进行有效交互。于是,他在原有的VL框架中加入了“动作(Action)”,提出了“V3A”的概念,即“视觉(Vision)、提问(Ask)、回答(Answer)与行动(Act)”。
吴琦的学术轨迹跨越了多个国家:本科毕业于中国计量大学,在英国巴斯大学完成硕士和博士学业,随后在澳大利亚阿德莱德大学进行了三年的博士后研究,并于2018年开始留校任教。他的贡献获得了学界认可,先后荣获澳大利亚科学院罗素奖与南澳大利亚杰出青年科学家称号,其谷歌学术引用量已超过1.4万次。
作为视觉-语言领域的早期探索者,吴琦的研究始终紧跟前沿。在MS COCO数据集推动图像描述任务兴起后,他于2015年迅速跟进;随后又在视觉问答(VQA)这一新兴方向发表了“Ask Me Anything”等工作;最终在2018年开启了VLA领域的研究。
七年时间过去,VLA已成为当下具身智能领域最受关注的方向之一,海内外相继涌现出如英伟达的GROOT N1、Figure AI的Helix、Physical Intelligence的π0、清华大学的RDT等一系列机器人VLA模型。
而作为领域的开启者之一,吴琦选择在VLN方向上继续深耕,并从去年开始着力推进一系列真机实验。目前,他在澳大利亚阿德莱德大学担任副教授,领导着自己的“V3A Lab”实验室,同时也在澳大利亚机器学习研究中心(AIML)担任视觉与语言研究方向的实验室主任。
谈及具身智能与VLA,吴琦认为VLA不应局限于上半身的操作任务。他指出:“很多人认为导航问题已经被解决,而操作任务更容易与产业结合落地。但实际上,视觉语言导航(VLN)仍然存在大量有待突破的空间。”
VLA的“七年之痒”
问:2018年您提出了“V3A”的概念,在原有的VL上加进action,当时是受到什么启发促使您开始了VLA的研究?
吴琦:最早在CVPR 2018上,我和Peter、Abhishek(Embodied VQA的作者)碰面,觉得彼此的研究都很有意思,于是决定在即将举行的ACL会议上联合举办一个教程。当时我们认为,单纯的视觉-语言主题已经被讨论过很多次,再办教程意义不大,应该加入一些新内容。我们做的导航和Abhishek做的问答都属于“动作”范畴,不如就做一个关于视觉、语言和动作结合的讲座,这算是VLA概念的早期雏形。
我们的首篇VLN工作开辟了这个新领域,但主要是提出了R2R数据集和任务定义,起初反响比较平淡。转折点出现在第二年,CVPR的最佳学生论文奖授予了王鑫那篇利用模仿学习和强化学习共同解决VLN问题的工作,这才彻底让这个领域火了起来。
因为非常喜欢VLA这个概念,我进一步提出了“V3A”。最初的设想是,希望机器人或虚拟智能体能够基于视觉输入回答问题,这证明它能“听懂”;而当时视觉问题生成的研究认为,提问比回答更难,这体现了更强的推理能力;在具备自然语言对话能力之后,我们希望模型能执行如导航之类的动作。为此,我们还提出了“远程具身视觉指称表达”任务,即让机器人完成“帮我找个勺子”这类基于语言指令的导航任务。
问:在您看来,2018年前后的那波VLA研究与现在具身智能领域的VLA,有什么不同之处?VLA的发展经历过哪几个比较重要的阶段?
吴琦:我们刚提出VLA概念时,操作任务还不算热门。那时的“动作”可能更偏向高层抽象,离实体机器人更远一些,比如理解场景后回答问题,或者导航到指定位置寻找物品。此外,当时的数据量级与现在相比,差距非常巨大。
Embodied QA出现后,VLA领域经历了一段停滞期,部分原因是其使用的数据存在版权问题,导致其他研究者难以复用。而VLN在VLA发展中起到了关键作用,我们的工作早期地将VL与动作结合起来,加上王鑫在CVPR 2019的工作,共同让VLN和VLA获得了广泛关注。时间再往后,上海交通大学的卢策吾老师团队将操作任务与具身智能深度结合,提出了许多新的数据集和任务。
接下来是一个非常关键的节点:GPT系列模型的出现。在此之前,尽管存在视觉-语言大模型,但在解决许多视觉问答任务上表现平平。当时普遍认为,在VL基础问题尚未妥善解决之前,结合动作是不太可能实现的。而GPT的出现,尤其是在引入多模态能力后,解决了许多传统VL模型难以处理或处理不佳的任务,其零样本性能甚至远超当时最大的VL预训练模型。因此,学界开始形成一种共识:VL的一些基础任务已被有效解决,是时候引入更高层次的维度,即利用结合后的视觉语言信息来预测和输出动作,而不仅仅是停留在难以落地的VQA任务上。
问:具身智能热潮之前,自动驾驶行业曾备受瞩目。在您看来,自动驾驶与机器人分别对VLA提出了怎样独特的要求?如果单纯从导航的角度看,研究人形机器人(双足)的意义大吗?
吴琦:自动驾驶在某种意义上也是一种VLA:视觉对应户外场景,语言对应乘客或系统的指令,动作则是车辆的操控行为。当然,这里的动作可以细分为车辆本身的动作(如转向、加速、减速),也可以是车机系统的操作(如播放音乐、导航至某地)。
机器人的VLA则有所不同。除了无人机,大部分机器人应用集中在室内场景。其视觉输入主要针对室内环境和物体,而动作则要求精度更高的操作任务,或者移动精度要求更高的导航任务。
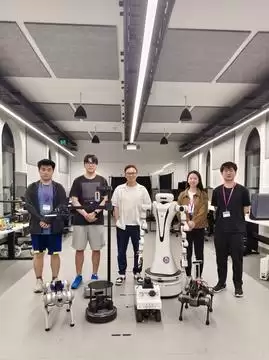
我们去年基本实现了单纯的视觉语言导航在实体机器人上的部署和运行,包括四足机器狗、扫地机器人和轮式机器人。在双足机器人上部署,我们认为问题也不大。因为目前“大脑”(决策规划)和“小脑”(运动控制)的开发通常是分开的。只要双足机器人的底层运动控制稳定,对于VLN系统来说,其任务是一样的:根据当前的视觉和语言信息,输出机器人需要执行的线速度和角速度指令。据我所知,无论是轮式底盘还是足式机器人,都可以接收这两个参数来完成底层的动作执行。
问:经历了VLA从默默无闻到如今大热的过程,您如何看待当前业界对VLA的热情?
吴琦:VLA的兴起其实是产业需求与学术发展共同作用的结果。从产业视角看,任何实际的落地场景都需要处理多模态输入,并依赖一个能够进行高层推理的模型来辅助完成复杂的规划与决策。人类大脑的工作机制就是典型例证——通过整合视觉、听觉、触觉等多模态感知信息,经过中枢神经系统处理,最终生成具体的动作指令。这种整合与决策过程在日常场景中不可或缺。
从学术研究趋势看,自然语言处理与计算机视觉领域的许多核心任务已取得显著进展,研究者们自然将目光投向了新的前沿方向。
值得一提的是,VLA领域的研究者需要精准定位应用场景,深入理解语言在其中扮演的核心角色:它为机器人提供了一种更便捷、自然的人机交互方式。这种交互模式高度灵活,允许用户以随意的口语化方式下达指令,这同时也衍生出一系列全新的技术挑战——不同于传统预设任务的固定模式,VLA面临的任务往往具有显著的临时性和动态性,需要实时响应非预定义的、随时变化的需求。
VLN之于VLA
问:您认为导航任务的难点和重要性在哪里?如何理解VLN与VLA之间的关系?
吴琦:单纯的视觉导航作为任务可能相对简单,但视觉语言导航的挑战要大得多。
举个例子,食物掉到餐桌下,让现有的扫地机器人去清理。目前的方案要么是选择全屋清扫,要么把机器人搬到附近让它转圈扫,或者更智能一些的,能在APP上手动划定餐桌区域让它清扫。而VLN能够实现的是:给它一个“去餐桌附近清理食物”的指令,它就能利用这个信息,先导航到厨房餐桌的位置,再使用视觉信息找到食物残渣的具体地点,只清理那一小块区域。相比过去的导航方法,VLN更擅长处理这类临时性、突发性的事件。我们最近在扫地机器人上已经基本实现了这些功能。
当然,VLA中的“动作”包含很多种类,VLN只是其中一个子集,需要根据具体场景具体分析。有些场景可能并不需要VLN,比如在工厂、超市等固定场景下执行分拣或清理货架等任务,机器人往往只需要按照预设的固定轨迹运动即可。
但是,未来如果进入家庭等实际应用场景,机器人需要不断移动以适应动态环境,这时导航问题就变得非常棘手。我和北京大学的王鹤老师也讨论过,室内场景存在诸多挑战,除了环境建模不准确,还有人员移动和交互带来的动态影响。
问:人的移动或交互这类动态场景,对VLN最大的挑战或难点在哪里?目前有哪些可行的探索方向?
吴琦:动态场景带来的最大影响,就是之前基于SLAM建图的导航方式不再完全适用。提前利用地图信息规划好的导航路线,可能因为动态障碍物的出现而无法完成任务。
这个时候就需要VLN这类技术的辅助。其核心是利用当前的视觉信息以及最初的语言指令,做出短程的导航路径规划,甚至只预测下一步该往哪里走。到达下一个位置后,再结合新的感知信息做出新的决策。我们最近也提出了一个新的数据集叫“Obstructed VLN”,专门研究路径被遮挡时需要做出临时调整的问题。
问:之前林倞老师团队发表的综述也将VLN列为具身智能的一大关键任务。VLN发展至今已七年,除了开山之作,您认为哪些工作是关键节点?
吴琦:很荣幸我们实验室主导了VLN领域多个关键节点的工作。在提出三个基准数据集后,我们相继采用CNN、RNN及注意力机制等方法展开研究。
Transformer架构诞生后,我们率先基于该架构提出了“VLN-BERT”,探索用Transformer处理VLN任务。2022年CVPR上发表的“Discrete-Continuous-VLN”则首次尝试弥合VLN在离散环境与连续环境之间的学习鸿沟。去年推出的Na vGPT是首个将大语言模型引入VLN的工作。而今年ICRA上的Open-Na v,则首次实现了VLN在真实机器人上的落地应用。
其他研究组也做出了许多关键贡献。例如早期Hao Tan在NAACL上提出的EnvDrop,以及Chen Shizhe提出的多个重要模型,比如现在常被用作基准模型的DUET。我们目前的SOTA模型ScalVLN也是基于DUET的工作改进的。值得一提的是,Shizhe也曾在我们V3A实验室访问过,非常优秀。
问:当前具身智能领域对操作任务热情高涨,但您似乎更关注具身导航?
吴琦:这可能还是出于落地导向的考虑。目前很多落地场景是工业场景或商业理货场景,大部分时候机器人可以按照固定路径,在相对固定的场景中移动。而家用场景的落地目前还比较困难,所以很多人尚未体会到室内视觉导航的真正挑战。
许多人认为导航问题已经完全解决,室内导航只需建好地图就能让机器人指哪到哪,不像操作任务那么复杂。但事实上,如果将其放在具身智能的完整框架下审视,室内导航仍需要相当长的时间来攻克。毕竟,机器人只有先移动到正确的位置,才能执行后续的动作。
如果认为具身行动只与上半身的抓取或操作有关,那可能并没有真正思考清楚什么是具身智能。关于具身智能的众多定义中,我最认同CVPR 2024一场讨论中提出的观点:一个AI智能体需要具备看、听、说、行动和推理这五项基本能力,并且能够将模拟环境中的解决方案迁移到真实的机器人和现实世界中。
也就是说,只有把视觉信息、语言能力和具体的执行任务(无论是上半身还是下半身的动作)最终在真实机器人上实现,才能称得上是一项真正的具身智能研究。
问:这与自动驾驶中的导航有哪些本质不同?
吴琦:自动驾驶的导航属于室外导航,可以利用大量现成信息,比如GPS提供精准定位,再结合高精度地图、视觉感知(车道识别、路标检测)以及雷达系统(实现障碍物检测与规避)。
而我们研究的VLN主要是室内导航,面临诸多限制。由于缺乏GPS信号,且环境信息(如地标、纹理)相对稀疏,无法直接套用室外方案。早期技术主要依赖视觉SLAM实现环境建图与定位,通过摄像头实时采集数据构建局部地图。但这种方案对环境依赖性很强,常常需要人工预处理(如标记特征点、优化场景纹理)来提升建图精度,难以实现完全自动化。
最大的难点在于数据收集,尤其是大量的室内3D环境数据。我们希望获取尽可能真实的3D环境,但这类数据本身就很少,也没有一个特别理想的仿真器。而扫地机器人等设备采集的真实数据又涉及隐私问题。我们因此也曾涉足室内设计相关的研究,与装修设计公司酷家乐合作,基于视觉和语言进行装修风格生成。他们所提供的海量3D场景数据对我们的研究非常有帮助。
问:室内环境虽然不受天气影响,但也可能在低光照、烟雾等极端感知条件下导致视觉输入失效。是否需要考虑为VLN引入多模态备份方案(如超声波雷达、红外传感)?如何实现多模态信号与语言指令的实时对齐?
吴琦:确实,随着仿真器变得越来越逼真,我们可以模拟出这些复杂情景,也可以考虑引入其他传感器来辅助导航。在这方面,或许可以参考自动驾驶的一些解决方案,来实现多模态信息的对齐与融合处理。
卡脖子的数据也最易突破
问:在VLN和VLA领域,当前最亟待解决的三大研究问题是什么?
吴琦:目前面临的核心挑战首推数据问题。当前缺乏足够优质、大规模的数据集来支撑VLN或VLA模型的训练,这与GPT依赖的海量语料形成鲜明对比。具体而言,数据问题可以拆解为三个部分:
第一是仿真器的必要性。在与机器人技术结合的场景中,仿真器是训练和测试的基础平台,其性能直接影响生成数据的质量。这里有很多因素需要考虑,比如材质摩擦力、摩擦系数、环境重力,甚至是热交互等物理特性。我们熟知的物理定律在目前的仿真器中体现得还不够充分。要构建真正的“世界模型”,数字孪生不能只停留在表面,还必须涵盖其内在的物理特性。
第二是高质量3D环境构建的稀缺性。仅有仿真器还不够,还需要在其中构建多样化、真实的场景(如家庭、工厂、购物中心等)。这类3D环境不仅稀缺,制作成本也非常高昂。
第三是专用应用数据的独特性。与传统AI数据(如NLP的纯文本、CV的带标签图像)不同,VLA/VLN需要特定任务的数据(如抓取、操作、导航等)。其数据格式必须整合仿真器、环境以及应用场景三类要素,缺一不可。因此,构建大规模、复合型的数据集是VLA/VLN发展的关键方向。
第二个挑战是“仿真到现实”的迁移鸿沟。模型在仿真器中高效训练后,需要部署到真实的机器人和环境中。但二者之间存在多重差距,包括环境差异(如光照、物体物理属性)和机器人硬件差异(如执行器精度)。如何弥合这些差距是技术落地的核心难点。
第三个挑战与工程部署相关。VLA/VLN任务涉及复杂的推理和模型计算(例如将导航模块与GPT等大模型结合),通常依赖高性能GPU。如何在机器人终端实现高效的模型压缩,平衡算力需求与设备轻量化,是亟待突破的技术瓶颈。
问:在这些瓶颈中,哪一个最有可能率先取得突破?
吴琦:虽然数据是最大的难题,但它其实也是最容易取得突破的环节,尤其是围绕如何构建更好的数据集、仿真器和环境,并利用它们训练出更强大的VLA模型。
比如我最近在思考环境生成的工作。之前与酷家乐的合作,就是通过输入语言描述来生成三维房间环境,包括房间布局、家具摆放、墙壁颜色、地板材质等。但由于当时模型能力有限,效果比较一般。现在,或许可以重新审视并实现这个想法。输入可以是多种模态的,比如对环境的语言描述、现有环境的图片、视频或结构信息。我们希望模型能按照用户需求,快速生成一个精准、符合要求的环境,再将这个环境导入到“桃源”或NVIDIA Isaac Sim等仿真器中,供大家进行训练。
问:针对最关键的数据问题,目前主要有哪几种技术路径?
吴琦:数据构建主要存在三种技术路径。
第一是真人操控采集。通过人工控制机器人完成行走、抓取、家具组装等任务,同步记录动作轨迹与环境交互数据,直接用于模型训练。这种方式依赖真实场景操作,数据贴合实际应用,但采集成本较高。
第二是仿真到现实生成。借助高逼真度的物理仿真器(如NVIDIA Isaac Sim、上海人工智能实验室的“桃源”系统)构建虚拟环境,通过算法自动生成机器人执行各类任务的数据。这种路径的优势在于能够低成本、大批量地生产数据——无需真实硬件介入,即可在模拟环境中完成海量训练,训练后的模型可直接部署到真实机器人。
第三是视频数据驱动。聚焦于互联网上的海量公开视频(如导航、烹饪等场景),通过分析视频中的高层决策逻辑(如任务规划、动作序列)来训练模型。这种路径规避了传统数据采集的繁琐过程,仅关注“做什么”的高层规划,而无需处理机器人“如何执行”的底层控制细节。
问:您很早就开始进行VLA相关的仿真研究。在您看来,这些年来仿真技术最大的进展是什么?当前最亟待突破的卡点又是什么?
吴琦:确实,当时我们在设计和发布VLN任务时,就为MP3D数据构建了一个MP3D仿真器。但这个仿真器仅仅是为MP3D环境数据和VLN任务服务的,功能非常简单。
随着具身智能的发展,大家越来越关注仿真器,从早期Meta发布的Habitat 1.0、2.0,到最近的NVIDIA Isaac Sim。我认为仿真器最好由大厂来主导开发,因为它更多是一个工程化的问题。
对于仿真器,我认为有三个方面的内容比较重要:一是场景仿真,即场景看起来要非常真实。这涉及到渲染、追光、建模、纹理等技术。二是物理仿真,要能够模拟现实世界的物理现象,比如重力、摩擦力、碰撞等。第三,仿真器必须高效,不能因为运行速度拖慢模型训练,尤其是在结合强化学习训练时,需要与仿真器频繁交互,其运行效率至关重要。
问:那么,有哪些方法可以解决Sim2Real鸿沟和工程部署这两大难题呢?
吴琦:如果我们普遍相信“规模定律”的话,那么解决仿真到现实的鸿沟,本质上就是解决数据的问题。
想象一下,如果我们拥有一个非常庞大的环境数据集,包含了各种各样的场景,而这些场景又足够真实,并且能够导入到仿真器中供我们训练一个足够大的模型,那么我认为是有可能解决这种差距的。我们目前就在与酷家乐合作,利用他们之前积累的大量3D资产,批量生成这类环境数据。
说到部署,我认为机器人本体公司可以发挥更重要的作用,提供相对易用的部署工具。这是一个生态问题。英伟达之所以成功,关键在于构建了良好的生态,推动了整个行业的发展。硬件公司应该具备这样的前瞻性,提供好的工具,建立好生态,硬件才能更好地销售出去。