

月之暗面推出数学模型k0-math,对标OpenAI o1
月之暗面发布数学模型k0-math,其数学能力对标OpenAI的o1系列。该模型采用强化学习技术,旨在赋予AI深度推理能力,并以数学为突破口进行训练。基准测试显示,其在多项数学评测中表现优异,超越或接近o1系列部分模型。强化版即将上线,未来推理能力将向更多学科扩展。
今天,京东科技大厦迎来了一场备受关注的发布。月之暗面创始人杨植麟正式揭开了其数学模型 k0-math 的面纱。这款模型在数学能力上直接对标 OpenAI 的 o1 系列,同时公布了一组关键数据:截至2024年10月,Kimi 的月活跃用户已突破3600万。
在阐述技术路径时,杨植麟将焦点投向了强化学习。他指出,未来的重心将不仅仅是基于静态数据集预测下一个词(Next-Token Prediction),因为这种方式难以应对更复杂的任务。关键在于赋予AI“思考”的能力。而强化学习,正是通往这一目标的重要路径。
这就像解一道数学题,真正的价值不仅在于最终答案,更在于理解其解题思路和一步步的推导过程。这是一个深度思考的链条,而传统的预测方法难以捕捉这种链条。
为何选择数学作为突破口?杨植麟引用了伽利略的名言——数学是宇宙的语言。数学场景应用广泛,且无需与外界进行复杂交互,自成一体,是锤炼AI思考能力的绝佳“训练场”。OpenAI的o1模型也遵循了相似的逻辑。k0-math正是从数学这一核心场景出发,再将其推理能力泛化至更广泛的任务中。
具体而言,当面对一道高难度竞赛题时,k0-math可能会进行大量、多样的尝试。或许在八九种解法都未能直接通向答案后,它能综合前几种思路的精髓,最终整合出一条正确的解题路径。
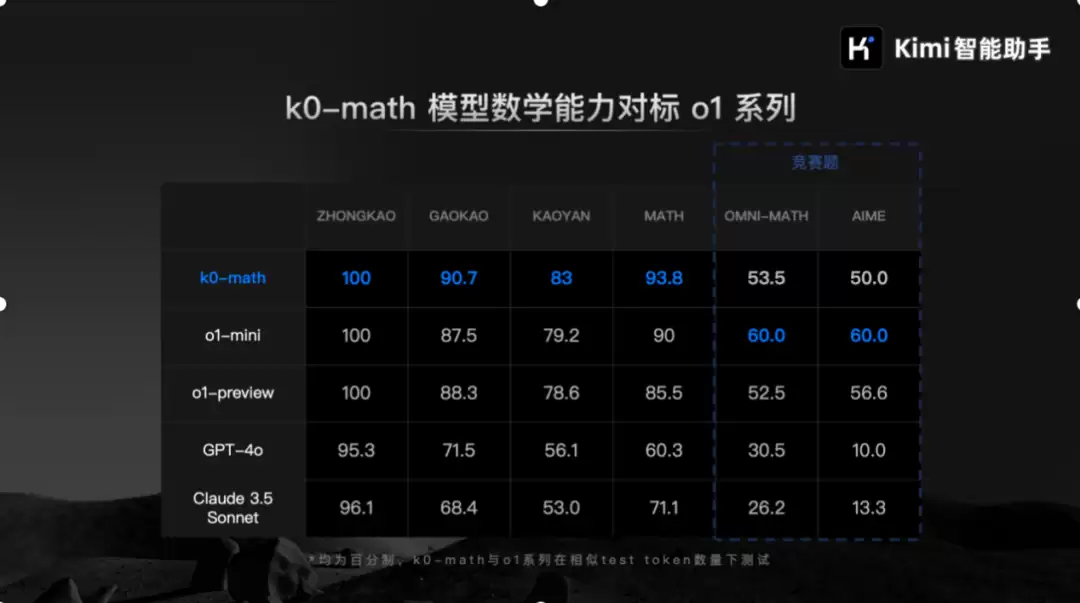
k0-math模型性能表现
性能如何?根据公布的基准测试结果,k0-math初代模型的数学能力已可对标OpenAI o1系列中公开可用的o1-mini和o1-preview模型。在中考、高考、考研以及包含入门竞赛题的MATH基准测试中,k0-math的成绩实现了超越。而在难度更高的竞赛级题库OMNI-MATH和AIME上,其表现也分别达到了o1-mini最佳成绩的90%和83%。
据悉,强化版的k0-math模型将在未来一到两周内,搭载于Kimi探索版中与用户见面。新版本将突出三大特点:意图增强、信源分析与链式思考。
强化学习的技术挑战与“过度思考”
从技术层面看,这种深度思考模式带来了新的挑战。在强化学习中,模型生成的大量“思考数据”是否都有用、是否正确,成为核心问题。这与处理静态数据的传统预测模式不同,对奖励模型的设计与训练提出了更高要求。关键在于如何设置更有效的奖励机制,引导模型尽可能减少学习错误数据。
这种机制也带来了一个有趣的“副作用”——过度思考。例如,当被问到“1+1等于几”时,k0-math可能会煞有介事地展开一整套推理过程,最后才得出结论“等于2”。杨植麟解释,这是因为当前的奖励模型并未对思考长度设限,允许其自由思考。当然,通过调整奖励模型的结构,可以在一定程度上抑制这种过度思考。
关于用户体验,杨植麟透露,搭载了强化版k0-math的Kimi探索版很可能会让用户自主选择是否使用。这种设计在早期有助于更好地匹配用户预期与分配算力。这背后涉及两个技术考量:一是模型需要智能地动态分配最优算力,如同人类知道简单问题无需深思;二是这是一个成本持续优化的过程。
展望未来,k0-math的推理能力将从数学领域,逐步泛化至物理学、化学、生物医学等更多学科场景。
克制与聚焦:月之暗面的产品哲学
回顾过去一年,月之暗面的步伐清晰而稳健:去年今日,Kimi Chat全面开放服务;今年10月,推出AI搜索功能;直至今天发布k0-math。三个关键动作,恰好走过一年。
与行业内许多公司相比,月之暗面的产品策略显得尤为克制。杨植麟将这种克制归因于主动的“业务减法”。团队选择聚焦于那些最接近AGI(通用人工智能)上限的事情,并力求做到极致。同时,公司始终保持“卡(算力)与人(才)”比例的最高化。
尽管去年整个行业经历了大规模扩张,但月之暗面至今仍是头部大模型公司中人数最少的团队,规模控制在200人以内。“我们不希望把团队扩得太大,规模过大对创新是致命的。如果想保持团队的精干,最好的方式就是在业务上做减法。”杨植麟坦言,公司早期也尝试过多个产品并行,短期内或许有效,但最终发现,聚焦于一个产品并将其做到极致才是关键。否则,创业公司很容易失去自身优势,变得与大型机构无异。
目前,Kimi最核心的任务是提升用户留存率。
预训练仍有空间,强化学习引领范式变革
面对当前业界关于Scaling Laws(缩放定律)是否“撞墙”的激烈辩论,杨植麟给出了他的判断:预训练仍有发展空间,这一空间将在明年被充分释放,领先的模型会把预训练推向极致。
然而,接下来更重要的变革将来自技术范式层面——即强化学习带来的改变。这本质上依然是一种“缩放”,但方法已然不同。Scaling Laws是否触及上限,核心在于数据的使用方式。过去依赖静态数据集的方式相对简单直接,而现在通过强化学习,结合了人类标注的智慧(例如,人工标注100条高质量数据就能产生巨大杠杆效应),其余则交由AI自主思考。这种“AI+人类”的协同模式,其潜力上限是非常高的。