

摩尔线程GPU技术再进一步
摩尔线程发布云边端产品矩阵,从GPU芯片公司转型为AI基础设施提供商。其夸娥集群展示大规模算力交付能力,MUSA生态降低开发门槛,长江SoC覆盖边缘与终端,MTLambda平台瞄准具身智能仿真。公司整合云端训练、软件迁移、边缘设备和智能体仿真,以系统能力应对AI竞争,但仍需在规模交付、生态构建和场景验证中。
5月18日,摩尔线程在北京举办发布会,集中展示了最新的云边端产品矩阵,信息量丰富。
从夸娥万卡级智算集群、长江SoC,到AICUBE、AIBOOK、E300边缘模组,再到小麦智能体、MT Lambda具身智能仿真平台,以及MUSA软件生态的最新进展,一系列产品被集中呈现。
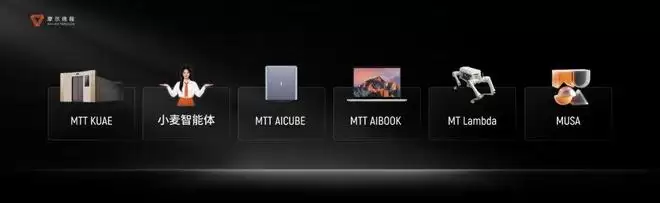
值得关注的是产品矩阵的组织逻辑。摩尔线程将云端训练、软件迁移、边缘设备、终端智能体和具身仿真串联成线,这清晰地表明,其市场定位正从单一的GPU芯片公司,转向更全面的AI基础设施提供商。
从单点性能到系统能力
过去,国产GPU公司常被追问单卡性能、框架兼容性及CUDA生态迁移难度。这些问题依然关键,但随着AI进入Agent阶段,客户的问题变得更加系统和具体。
大模型公司关注集群能否支撑长期稳定训练与故障快速恢复;自动驾驶公司在意世界模型与仿真验证的链路对接;机器人公司关心策略能否高效下发至海量端侧设备;企业客户则会综合考量迁移成本与长期维护复杂度。
单卡性能是入场券,而系统级的交付与运维能力,才是影响采购决策和复购的关键。本次发布会,摩尔线程重点强调的正是这种系统能力。
云端:规模化交付的证明场
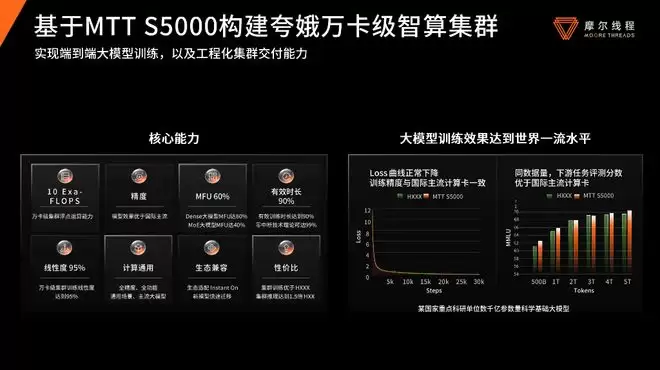
云端是当前最重要的能力证明场。据披露,夸娥万卡级智算集群已实现落地,其Dense大模型训练MFU达60%,MoE大模型达40%,训练线性扩展效率高达95%,有效训练时长达到90%。
大模型训练的复杂性随规模扩大而凸显。更多GPU带来更高算力峰值,也对通信、调度、容错、存储、散热及框架适配构成全方位挑战。训练周期越长,系统整体稳定性越重要。夸娥集群的任务,正是向企业客户证明摩尔线程具备大规模、高可用的系统交付与运维实力。
软件栈的补齐同步推进。摩尔线程已完成对DeepSeek、GLM、MiniMax、Kimi、Qwen等国内主流大模型的适配,并在SGLang主线代码中获得最新原生支持,同时开源了vLLM-MUSA。其MUSA SDK 5.1.0版本对标CUDA 12.8,并宣称完整支持PyTorch全部3194个算子。
这些进展的战略价值在于持续降低开发者的迁移阻力。国产GPU生态建设的难点常在于“长尾”细节:主流框架能跑,不代表企业遗留工程代码能顺利迁移;模型完成适配后,版本更新需持续跟进;基础算子补齐后,业务中可能还存在自定义Kernel和旧版本依赖。开发者的耐心和信任,常消耗在这些关键环节。
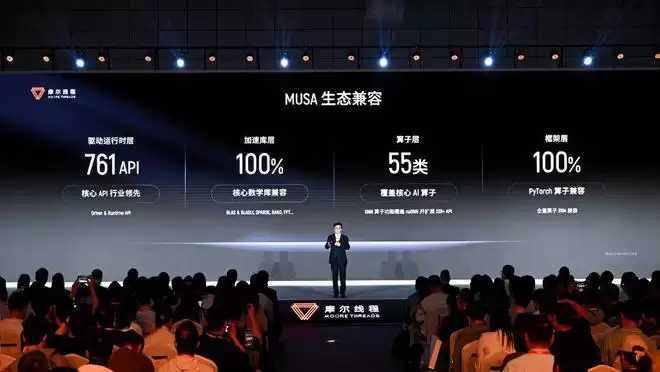
因此,摩尔线程强调MUSA兼容性、推动vLLM-MUSA开源、争取SGLang最新支持,以及推出Automusify自动迁移工具、MUSACODE编程助手,核心都在解决同一问题:如何将国产GPU从“可用”持续推向“好用”。
边缘与终端:切入更复杂的场景
在边缘和终端侧,摩尔线程展现出更主动的市场切入姿态。
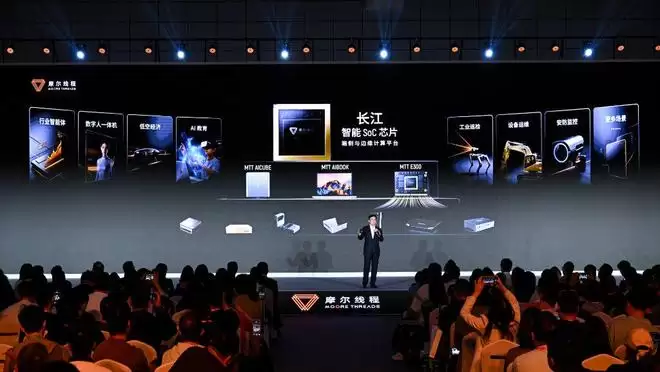
基于长江SoC,公司推出了AICUBE、AIBOOK和E300三款产品。AICUBE瞄准家庭场景,整合小麦智能体、AI PC和AI NAS功能,聚合家庭数据管理、设备控制与智能体服务。AIBOOK面向开发者和学习者,运行MTT AIOS,预装龙虾智能体OpenClaw,支持多智能体协作。E300专攻工业质检、能源巡检、具身智能、智能汽车、低空经济等边缘场景,提供50TOPS异构AI算力,主打本地推理、低延迟与稳定运行。
这些产品将摩尔线程带入评价维度更复杂的市场。家庭用户看重高频需求满足度,开发者评估能否融入现有工作流,行业客户则精算部署成本、设备故障率及服务响应速度。AICUBE、AIBOOK和E300的最终价值,需通过用户使用频率、开发者社区留存率及行业项目复购率来验证。
MT Lambda:连接虚拟与物理的关键变量
在这套产品矩阵中,MT Lambda扮演着关键变量角色。
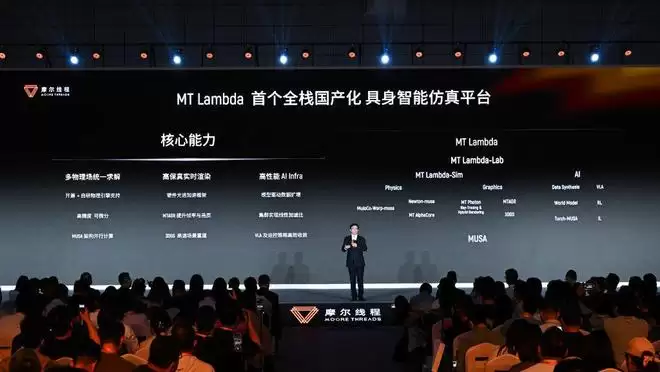
摩尔线程将其定义为全栈具身智能仿真平台。它基于全功能GPU,将图形渲染、物理仿真和AI计算集成于同一芯片,上层提供数据合成、策略训练和仿真验证工具链。
这部分业务让摩尔线程的GPU叙事进入“物理AI”范畴。大模型训练主要检验云端算力的规模和效率,而具身智能的要求更宽:机器人、自动驾驶车辆、工业设备不仅需要理解环境,更需在物理世界中安全、高效地行动。这依赖语言、视觉、动作理解、物理仿真、图形渲染及端侧实时响应能力的综合。
真实世界的试错成本极高。机器人会摔倒,设备会损坏,生产线会受影响,自动驾驶汽车更不能依赖真实道路进行无限次冒险测试。因此,高保真仿真训练平台成为不可或缺的基础设施。
摩尔线程强调其“全功能GPU”,原因正在于此。进入具身智能时代,图形渲染、物理仿真与AI计算必须被放在同一计算底座上统筹。谁能更高效地生成可信合成数据,在虚拟环境中完成策略的充分训练与验证,谁就能显著降低机器人、自动驾驶等应用落地真实场景的成本与风险。
更多产业合作也在支撑这条链路。例如,摩尔线程联合智源研究院完成了RoboBrain 2.5的训练;并与光轮智能、小马智行、五一视界、光线云等伙伴,在仿真数据生成、世界模型、自动驾驶仿真及具身智能平台适配等方面展开合作。
战略路径清晰,挑战随之而来
将云端、软件、终端和仿真平台放在一起审视,摩尔线程此次发布的公司战略图景逐渐清晰:夸娥集群攻坚大规模AI计算;MUSA生态降低开发迁移门槛;长江SoC及端侧产品深入具体设备和场景;MT Lambda切入具身智能核心工作流。
这是一条从底层芯片向上,向系统、平台乃至最终场景不断延伸的路径。其优势在于,公司可以减少对单点硬件销售的依赖,将自己嵌入客户AI系统建设的更深处。当客户采购AI基础设施时,算力单价只是因素之一,稳定性、迁移成本、服务能力以及最终的场景落地效果,都会被纳入综合考量。
当然,风险也同样明显。每深入一个层面,评价标准就会变化。云端看规模交付和长期稳定性;软件看开发者体验和生态活力;终端产品看是否切中高频刚需;具身智能平台则需接受真实场景的严苛验证。这意味着,摩尔线程需要在多个战场同时证明自己的能力。
发布会展示的是一张结构完整、逻辑自洽的蓝图。接下来的考验在于,各个节点能否真正顺畅地“跑”起来。例如,夸娥集群训练出的模型,能否高效部署到边缘和终端设备?MT Lambda生成的控制策略,能否顺利进入机器人或自动驾驶客户的真实业务流程?MUSA生态又能否将开发者的迁移成本降到可接受、甚至乐于接受的范围?
结语:融入AI竞争的新维度
从行业趋势观察,AI的竞争正从模型能力本身,外溢到整个系统能力。过去两年,行业注意力集中在参数规模、上下文长度、多模态表现、推理成本以及Agent能力上。模型固然仍是核心,但产业界已开始面对更具体、更系统工程化的问题:算力如何稳定、高效供给?高质量数据如何持续生成?模型如何训练、优化并最终部署?机器人如何在仿真中学习,并在现实中可靠执行?
这些问题的解决,需要坚实、灵活的基础设施来承接。摩尔线程这次发布会的意义,或许就在于它明确地将自己定位到了这个新的命题之中。对于国产GPU公司而言,下一阶段的突破点,很可能将来自于系统级交付能力、软件生态的完善度以及场景闭环的验证。摩尔线程给出的方向是,同时进入大规模智算集群、边缘终端市场以及具身智能仿真生态。
蓝图已经绘就,接下来,市场将检验这些产品之间,能否产生真实的化学反应与协同效应。