

TiDB联合创始人分享Vibe Engineering
TiDBPostgres重写项目使用Rust取得接近生产级质量。头部模型在长上下文召回和AgenticLoop上跨越临界点,使无人工干预的复杂Infra开发成为可能。人在需求提出、测试验收阶段至关重要,多Agent协同可显著提升代码质量。顶尖工程师借助AI实现10倍产出,但不同VibeCoder工作流难以协作。
其实在上一篇介绍 OpenCode 之后,得到了不少朋友的关注和反馈。这几周过去,对 Vibe Engineering 的实践有了更多体会,今天再总结一下。能看出来,刻意避开 Vibe Coding 这个词——当下的重点已经不再是代码,而是更高维度的东西。另外,本文的 AI 含量尽量控制在 5% 以内,可以放心阅读。
顺便汇报下,上一篇提到的 TiDB Postgres 重写项目已经不再是个玩具。前些天出差,长途飞行没网络,仔细 review 了一遍这个项目的代码——虽然有些小瑕疵,但总体质量已经很高,接近生产水平的 Rust 代码,和以往认知中“早期原型”的定义很不一样。从一开始就选 Rust 是个无比正确的决定:Rust 的严谨性让 AI 能写出更接近 bug free 的 infra 代码(对比另一个项目 agfs,因为用了 Python,项目变大后维护性大幅下降,现在只能捏着鼻子慢慢重构)。所以到了 2026 年,如果要再启动一个新的 backend infra 项目,Rust 应该是第一选择。
TiDB PostgreSQL Cloud
验证差不多后,邀请了几位团队内的顶尖 vibe coder 加入项目,看看 100% AI Native 研发模式能在多快把这个项目推到什么程度。无论结果如何,都会很有意思。
下面说说近来的感受。
当前关于 Vibe Engineering 的所有认知都会在 1 个月内严重过时
并非危言耸听。哪怕正在写的这篇文章,如果是在 2026 年 2 月看到,那很遗憾,文中提到的东西很可能已经过时。这个领域发展太快,很多今天的 SOTA 下个月就失效了。有意思的是,过去对 Vibe Coding 嗤之以鼻的大佬——比如 DHH、Linus、Antirez 等——从 2025 年 12 月开始纷纷改口。这很正常,去年 12 月起,AI 编程工具和头部模型突然有了跳跃式进步,对复杂任务和大型项目的理解、以及写出代码的正确率都有了极大提升。进步大概来自两个方面:
一方面,头部模型在长上下文(>256K)的支持上,关键信息的召回率提升惊人。
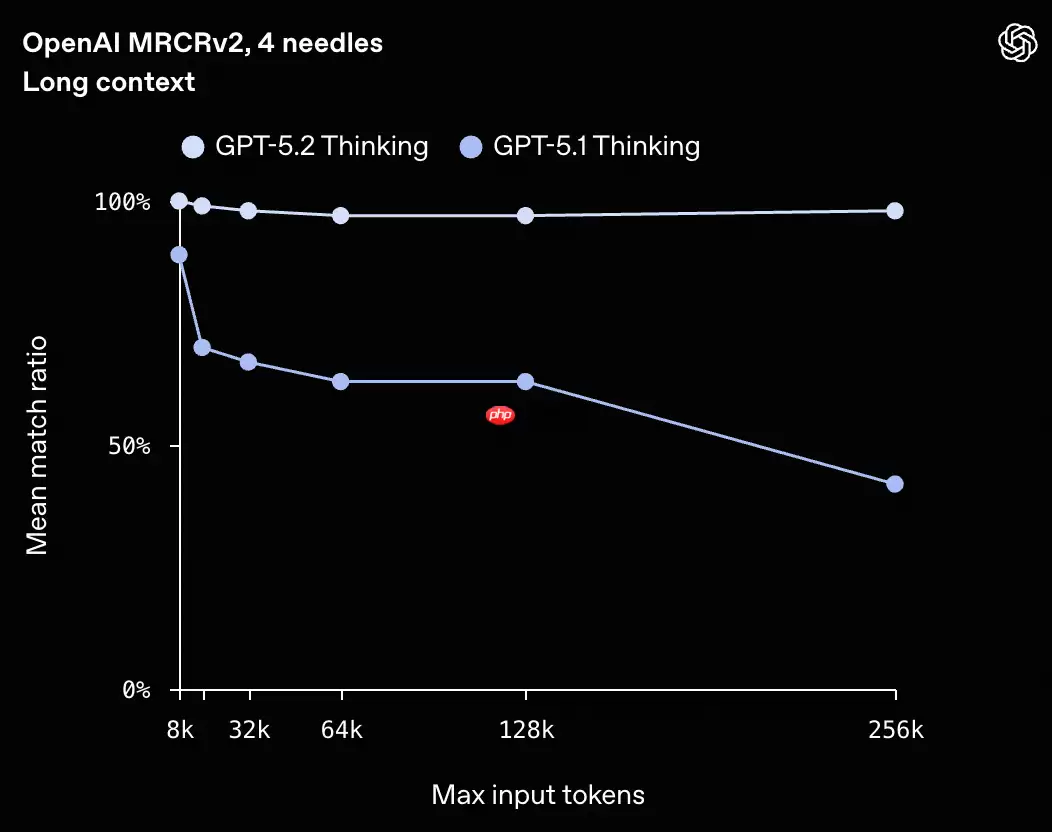
比如上面是 GPT-5.2 在长上下文的召回表现与 GPT-5.1 的对比,差距很明显。对于 Agent Coding 场景,通常是多轮次推理 + 长上下文(因为要放更多代码和中间推理结果)才能有更好的大局观,而大局观的正确性直接决定复杂项目的成败。简单算一笔账:一个模型每轮召回率 50%,大概 3 轮后正确的召回率就会降到 12.5%;而 GPT-5.2 仍然能保持 70% 以上。
另一方面,主流的 Vibe Coding 工具(Claude Code / Codex / OpenCode)在 Context Engineer 实践上日益成熟,从用户体验到最佳实践都在肉眼可见地变好——比如对 Bash 的使用、Subagent 等。大量资深工程师的重度使用和经验分享正在为这些工具提供数据飞轮,何况 AI 本身也在深度开发这些工具,迭代速度只会更快。
这种进步并非去年 12 月突然的“黑科技爆发”。前几个月一直在积累,只是还没到能长时间离开人工干预的临界点。而那个时间点恰好让主流 Coding Agent 的质量跨过了一个门槛:100% 无人工干预下完成长时间的 Agentic Loop 成为可能。
Hire the best (model),否则就是在浪费生命
上面提到的所有进步,只反映在顶尖的闭源头部模型中。很多朋友反馈说:“我感觉 AI 编程还是很傻啊?并没有你提到那么聪明。”首先会反问:是不是只用着 $20 一个月那种入门模型?如果是,先去用一阵 $200 以上的 Pro Max 档次,也许有惊喜。
客观而言,目前主流模型——哪怕不是头部那档——作为 chatbot 处理大多数普通人的短上下文日常工作完全足够。哪怕是 GPT-4,在讲人生道理时也已经能把你说得一愣一愣的。但作为人类,我们的直觉或者一些简单的 CRUD Demo 已经无法评估模型之间的智商差距了。在复杂项目开发中,这个差距极端明显。
从实践来看,当下能用来进行大型 Infra 项目(数据库、操作系统、编译器等)开发的模型大概就两个:GPT-5.2 (xhigh) + Opus 4.5,还有半个是 Gemini 3 Pro。
上个月主要用 opencode + oh-my-opencode + Opus 4.5,最近两周转向了 codex + gpt-5.2 的组合。下面分析这几个模型在后端 Infra 软件开发领域的脾性和调性,仅为个人感受,仅供参考。
Opus 4.5 速度快,是个话痨。由于 Sonnet 4 有严重的 reward hacking 问题(解决不了 bug 时会偷偷构造作弊测试糊弄过去),很长一段时间不敢用 Sonnet 系列干复杂的事。这个问题在 Opus 4.5 中解决得很好——即使在模型冥思苦想、各种尝试都搞不定的情况下,也没有选择作弊。但 Opus 的问题是 reasoning 和做 investigation 的时间太少,动手太快,导致发现不对时又回头确认假设和研究,也催生了像 ralph-loop 这样的奇技淫巧:同一个 prompt 在 Claude Code 结束后通过 stop hook 重新调用,再完整走一遍流程,不断逼近最终结果。
相比之下,GPT-5.2 更像是一个小心谨慎、话不多的角色。最初用 Codex 的体验不算太好,总觉得它太慢——习惯用它的 xhigh 深度思考模式,在真正开始写代码之前,它会花很长时间浏览项目里的各种文件和文档做准备工作。加上 Codex 客户端不会告诉你计划和大致的耗时,过程就显得特别长。有些复杂任务,前期的调查可能就要花上一两个小时。但经过长时间思考后完成的效果通常更好,尤其是在项目大体框架已经稳定之后,Codex 考虑得更周全,最终体现出更少的 bug 和更好的稳定性。
第三个顶级模型 Gemini 3 Pro。尽管多模态能力很吸引人,但就复杂任务的 Coding 场景而言,至少从体验来看,它的表现并没有 Opus 4.5 和 GPT-5.2 那么强。不过它针对快速的前端 Demo 和原型制作做了优化,配合 Playground 模式,在需要一些炫酷的小 Demo 或前端项目时能更快实现。
一个反直觉的事情是:过去常说 Vibe Coding 只能搞简单的事——比如那些小 Demo 或 CRUD 项目,网上各种 KOL 也都在做小原型,大家觉得后端这种核心基础设施代码 AI 还搞不定。以前也这么想,但从去年 12 月开始,这个结论需要修正了。原因在于,这类基础设施代码通常由顶级工程师长期精雕细琢而成——有清晰的抽象、良好的测试,代码本身经过多轮重构后相当精炼。当 AI 具备足够的上下文空间 + 更好的推理能力 + 更成熟的 Agentic Loop + 高效的工具调用时,这类 Infra 代码的开发和维护反而是最能有效利用顶尖大模型智商的场景。
实际工作中,经常会让多个 Agent 互相协作,或者用复杂的工作流把它们编排在一起,不会让一个模型完成所有事情。后面会再分享一些具体例子。
人在什么时候进入?扮演什么角色?
上面提到,顶级模型配合主流 Vibe Coding 工具已经能超越大多数资深工程师的水平——不仅体现在写出更少 bug 的代码,也体现在 review 中能发现更多人类工程师可能看不到的问题(毕竟 AI 真的会一行一行仔细看)。
那么人在这个过程中扮演什么角色?哪些阶段只有人才能做?根据实践来看:
第一,提出需求。 只有你知道自己想要什么,这很自然,但也确实挺难的——人很难从一开始就准确描述自己想要什么。一个偷懒的办法:让 AI 来角色扮演。比如在开发 PostgreSQL 版本的 TiDB 时,让 AI 假设自己是一个资深 Postgres 用户,从开发者视角告诉我哪些特性非常重要、一定要实现且 ROI 比较高,列出 N 个功能点。然后 AI 根据它的理解生成一个需求列表,你再和 AI 逐个打磨。这是一个高效冷启动的方法。
第二,在需求提出后,Coding Agent 大多会有一个规划阶段(Planning),反复确认需求。这里有些技巧:不要给 AI 太具体的方案,而是让 AI 生成方案,你只需关注最终想要的结果;提前告诉 AI 有哪些基础设施和环境问题,让它少走弯路。
另外,通常会在提出需求的第一阶段就要求 Agent 做几个关键动作:无论接下来做什么,都要把计划和 todo 列表放在 work.md 或 todo.md 里;每完成一个阶段的工作,就把上一阶段的经验教训更新到 agents.md 里;当一个计划完成且代码合并后,把设计文档添加到项目的知识库中(.codex/knowledge)。这些都是在提需求时就放进去的内容。
第三,调查、研究和分析阶段。 这个阶段基本不需要人做什么,Agent 的效率比人高得多,你只需要等着。唯一需要注意的是,在 Research 过程中通常告诉模型它拥有无限的预算和时间,尽可能充分调研。如果模型有推理深度参数,建议在这个阶段全部调到 xhigh 级别。虽然会变慢,但在这个阶段多烧一些 token、做好更好的规划、了解更多上下文,对后续的实现阶段会更有帮助。
第四,实现阶段。 没什么特别要说的。基本上不会一行行去看 AI 的代码。唯一要注意的是:要么让 AI 完全去做,要么完全自己做,千万别混着来。目前倾向于完全零人工干预的模式效果更好。
第五,测试和验收阶段。 人变得非常重要。在个人和 AI 开发项目的过程中,90% 的时间和精力都花在这个阶段——如何评估 AI 的工作成果。有一个原则:There's a test, there's a feature。只要你知道如何评估和测试你想要的东西,AI 就一定能给你做出来。需要注意的是,AI 在实现过程中会自动添加很多单元测试,这些微观层面的测试基本都能通过,毕竟 AI 写局部代码已经很难出 bug。但 AI 不擅长的是集成测试、端到端测试。比如开发一个 SQL 数据库,每个细节的单元测试都没问题,但整合到一起时集成测试可能会出错。所以在完成大目标前,一定会先和 AI 一起做一个方便的集成测试框架,提前准备好测试基础设施,收集和生成一些现成集成测试的用例,尽量一键运行。这些关于如何使用测试基础设施的信息,都会在正式开始前固化在 agents.md 里,不用每次沟通时再告诉它该怎么测试。至于测试从哪来,可以让 AI 帮忙生成,但一定要告诉它生成逻辑、标准和目的,另外千万不要把生成测试的 Context 和实际开发工作的 Agent 的 Context 混在一起。
第六,重构和拆分。 当前的 Coding Agent 在面对单一模块复杂度超过大约 5 万行代码后,就很难在 1-shot 里一次性解决问题(但反过来,只要任务复杂度控制在这个阈值之下,好的 first prompt 驱动下很多事可以做到 1-shot AC)。Agent 通常不会主动去做项目结构和模块边界的治理——你要它把功能做出来,它恨不得把所有东西都写进几个几万行的大文件里,短期看似很快,长期就是债务爆炸。这个阶段的做法通常是先停下来,用自己的经验进行模块拆分,然后在新的架构下进行 1~2 轮重构,之后又可以高并发地进行开发了。
多 Agent 协同编程的一些实践
前面提到,使用 Coding Agent 时通常不会只用一个。工作流会尽量让多个 Coding Agent 同时工作,这也是为什么有些项目会花掉好几千美金——必须把并发跑起来。并发和吞吐是一方面,另一方面,让不同的 Agent 在不共享上下文的前提下互相 Review 工作,能显著提高质量。就像管理研发团队时,不会让同一个人既当运动员又当裁判。Agent A 写的代码交给 Agent B 来 Review,往往能发现 A 看不到的问题。循环往复,会更有信心。
实际工作中用得比较好的一个工作流:首先让 GPT-5.2 在 Codex 下生成多个功能的设计文档,做出详细的设计和规划,第一阶段把这些规划文档保存下来。第二阶段,依然用 Codex 根据这些需求文档一个一个去实现功能。实现过程中记录 To-Do、经验教训,在代码通过测试并准备提交之前停下,把当前工作区交给另一个 ClaudeCode 或 OpenCode,在不提供上下文的情况下让其 Review 当前还未提交的代码,根据设计提出修改建议。然后把建议发回给 Codex,让 Codex 来评论,有道理就修改。改完之后,再让 ClaudeCode (Opus 4.5) 那边再次 Review,直到双方都觉得代码写得很不错了,再提交到 Git 上,标记任务完成,更新知识库,进入下一个功能的开发。
另外,在一个大型项目中会同时开多个 Agent(在不同 Tmux)并行开发多个功能,但尽量让它们负责完全不同的模块——比如一个 Agent 修改内核代码,另一个做前端界面。如果需要在一份代码上做一些彼此不太相关的工作时,可以利用 git 的 worktree 让多个 Agent 在不同的 git 分支上各自工作,快速提升吞吐量。
未来的软件公司和组织形态
未来的软件公司会是什么形态?从实践和一些朋友交流来看,至少在当下,团队中 Coding Agent 的 token 消耗呈现一个非常符合二八定律的分布——最头部用 AI 用得最好的工程师,消耗的 token 可能比剩下 80% 的工程师加起来还多。而且 Coding Agent 对不同工程师产出(质量、吞吐)的增益方差非常大:用得最好的一群人增幅可能是 10x,普通人可能只有 10%。唯一的瓶颈是人工 code review 和一些无法被自动化的线上运维工作(觉得也快了)。这样的特点让头部的工程师在 AI 协助下可以无边界地工作——越来越多的 one-man army 出现,而且和 token 消耗正相关:能花掉多少 token,大致代表能做得多好。
另一个有趣的现象:同样是 10x 工程师,各自的 Vibe Coding 工作流和最佳实践并不相同。这意味着两个顶尖的 Vibe Coder 很难在一个项目(同一模块)中协作。这种工作方式更像是头狼带着一群狼(Agents),在一片自己的领地里耕耘,但同片领地里很难容纳两匹头狼,会造成 1+1 < 2。
在这样的组织形态下,传统意义上的“团队协作方式”会被重新定义。过去强调多人在同一个代码库、同一模块里高频协作,通过评审、讨论、同步达成共识;但在 Vibe Engineering 模式下,更有效的方式反而是强解耦的并行。管理者要做的是把问题切分成足够清晰、边界明确的“领地”,让每个头部工程师带着自己的 Agent 群,在各自的领域里做到极致。
从管理角度看,这其实是个不小的挑战——不能再统一流程、统一节奏去约束所有人。对顶尖 Vibe Coder 来说,过多的流程和同步反而会显著拉低效率,甚至抵消 AI 带来的增益。管理者更像是在做“资源调度”和“冲突隔离”:确保不同头狼之间尽量少互相干扰,同时在必要时通过清晰的接口、契约和测试来完成协作。
基于以上原因,AI-Native 的研发组织很难自底向上从一个非 AI-Native 的组织中生长出来——大多数开发者面对变革时的第一反应不是拥抱,而是回避和抵触。但时代的进步不会因个人意志转移,只有主动拥抱和被动拥抱的区别。
大概就写到这里。总的来说,在这样的大环境下,对个人而言意味着一场深刻的转变。最好的工程师们有一些已经陷入了或多或少的存在主义危机。但作为具体的 Builder 来说,是兴奋的——造物,在当下,门槛低了许多。如果你能从造物中获得成就感和找到人生的意义,那恭喜你,活在一个最好的时代。但反过来,作为一个抽象的“人”来想,又是悲观的——人类是否准备好面对这样的工具?以及它带来对整个社会和人类文明的冲击?不知道。