

JavaScript遍历树结构:收集所有从根到叶子的路径数组
深入讲解在JavaScript中遍历树结构并收集所有从根到叶子节点路径数组的高效实用方案。包含深度优先搜索回溯机制、纯函数传递、显式迭代栈实现及常见引用陷阱排查。
核心方案与即用代码
在前端业务与服务端逻辑中,树形数据随处可见,例如多级权限分类树、级联选择器(Cascader)、组织架构图以及路由层级结构。当我们需要生成面包屑导航链、导出所有可达分类组合或计算所有终端业务路径时,目标都是将非线性的树结构转换为一个二维数组,其中每个子数组表示一条从根节点开始、以叶子节点结束的完整节点序列。
我们先来看最标准、内存表现最好的基础实现:通过递归维护一个共享数组,并在叶子节点处固化路径。
/**
 * 收集树结构中从根到叶子节点的所有路径
 * @param {Object} root 树的根节点对象
 * @returns {Array<Array>} 路径二维数组
 */
function getAllRootToLeafPaths(root) {
  // 边界防护:空树直接返回空数组
  if (!root) return [];

  const result = [];
  const currentPath = [];

  function traverse(node) {
    // 1. 压入当前节点值(或节点本身 node)
    currentPath.push(node.val);

    // 2. 判断是否为叶子节点:无 children 或 children 为空数组
    const isLeaf = !node.children || node.children.length === 0;

    if (isLeaf) {
      // 命中叶子节点:存入当前路径的浅拷贝,避免后续回溯修改污染
      result.push([...currentPath]);
    } else {
      // 非叶子节点:递归遍历每一个子节点
      for (const child of node.children) {
        traverse(child);
      }
    }

    // 3. 回溯清理:从子分支返回时弹出当前节点,还原路径状态
    currentPath.pop();
  }

  traverse(root);
  return result;
}
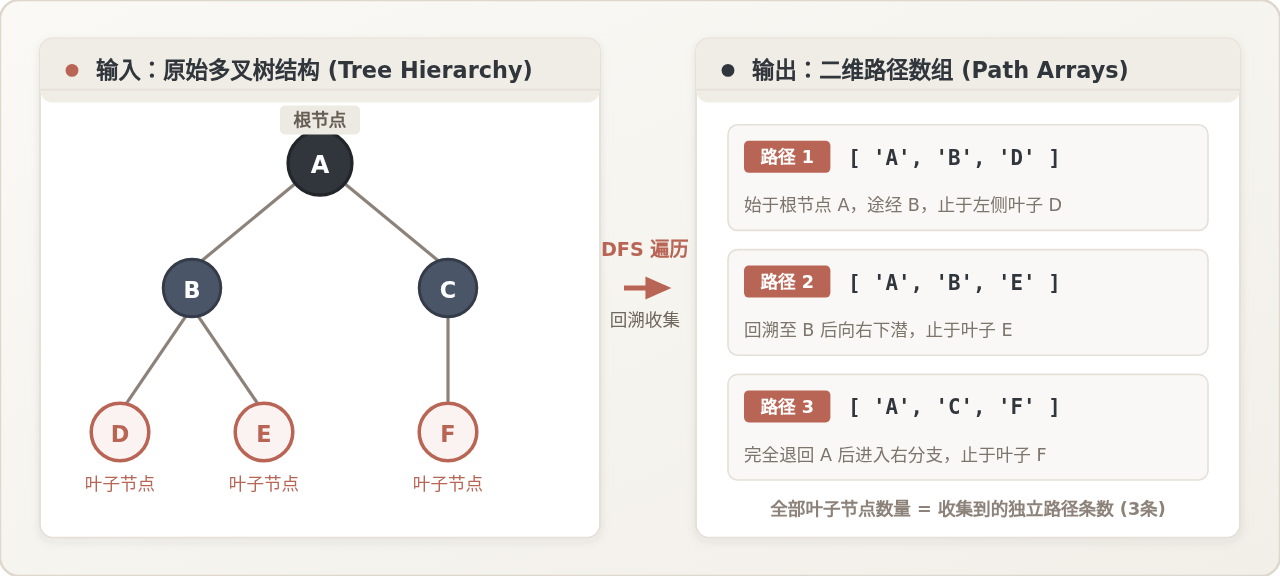
给定包含分支与叶子的多叉树测试数据,执行该函数可以直观看到转换映射关系:
// 示例多叉树输入数据
const tree = {
  val: 'A',
  children: [
    {
      val: 'B',
      children: [
        { val: 'D', children: [] },
        { val: 'E' }
      ]
    },
    {
      val: 'C',
      children: [
        { val: 'F', children: [] }
      ]
    }
  ]
};

const paths = getAllRootToLeafPaths(tree);
console.log(paths);
// 示例输出结果:
// [
//   [ 'A', 'B', 'D' ],
//   [ 'A', 'B', 'E' ],
//   [ 'A', 'C', 'F' ]
// ]
核心机制:叶子节点严谨判定与回溯时序
很多开发者在实现该算法时容易写出两个隐藏缺陷:一是叶子节点判断逻辑过于简陋,二是忽略了 JavaScript 对象引用的传递特性导致结果被洗空。理解以下两个核心机制,是写出高鲁棒性树遍历代码的前提。
1. 多叉树与二叉树的叶子节点判定差异
在严格二叉树(LeetCode 257 题等算法题场景)中,节点结构通常为 { val, left, right },因此叶子节点的充要判定条件是 !node.left && !node.right。
但在真实的 JavaScript 业务数据(如前端级联组件或后端接口返回的 JSON)中,树往往是多叉树,属性键通常为 children。此时叶子节点有三种常见的数据形态:
- 完全缺少
children属性(例如undefined); children被显式赋值为null;children存在但为一个空数组[]。
如果仅仅使用 if (!node.children) 来判断叶子节点,当节点带有空数组 children: [] 时,在 JavaScript 中 Boolean([]) === true,条件会判断为“非叶子”。随后代码进入 for (const child of node.children),由于数组长度为 0,循环根本不执行,结果导致该叶子节点既没有被记录到 result 中,也没有继续下潜,最终导致整条路径凭空消失。因此必须写成 !node.children || node.children.length === 0。
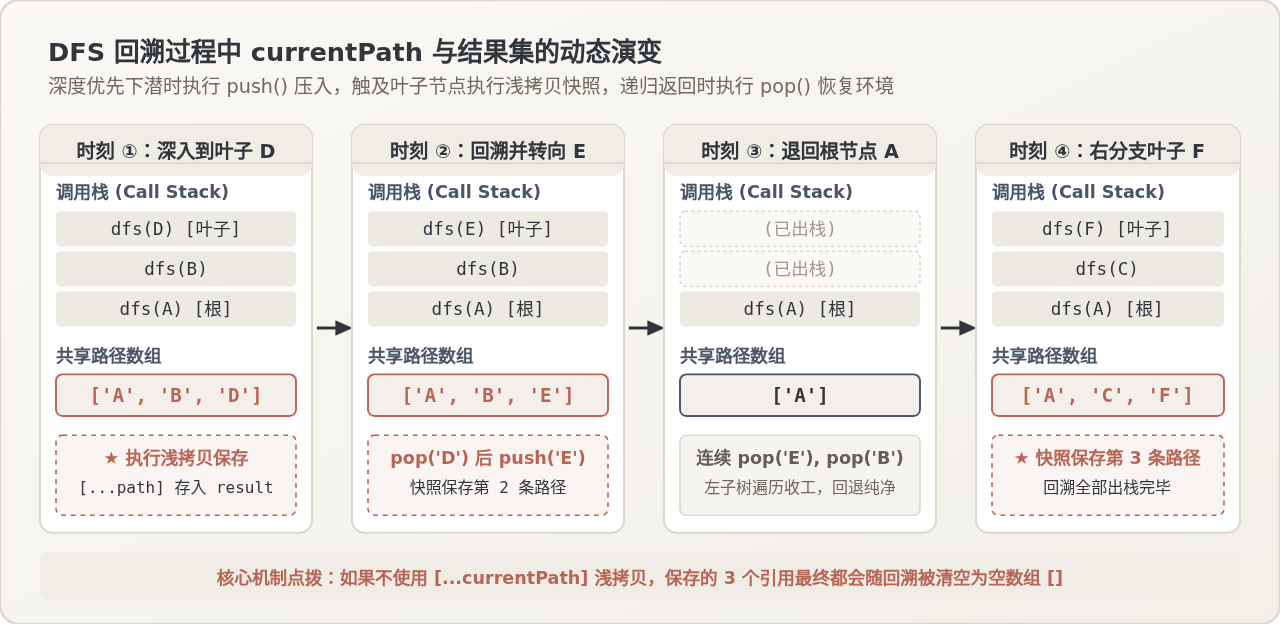
2. 为什么必须使用 [...currentPath] 浅拷贝?
在 JavaScript 中,数组属于引用类型(Reference Type)。变量 currentPath 存储的是内存堆中的数组地址。如果在遇到叶子节点时直接调用 result.push(currentPath),推入结果集的并不是该时刻数组的静态数据,而是对 currentPath 变量所指数组的引用。
当后续递归执行 pop() 回退状态,甚至整个树遍历完成将 currentPath 清空时,result 里面存放的每个元素引用的数组内容都会被同步修改。最终返回的 result 将变成包含多个空数组的错误结果 [[], [], []]。通过 [...currentPath] 或 currentPath.slice() 进行浅拷贝,可以在命中叶子节点的那一刻将数组切片固化,彻底隔绝后续回溯操作的副作用。
操作步骤:标准 DFS 回溯算法实现流程
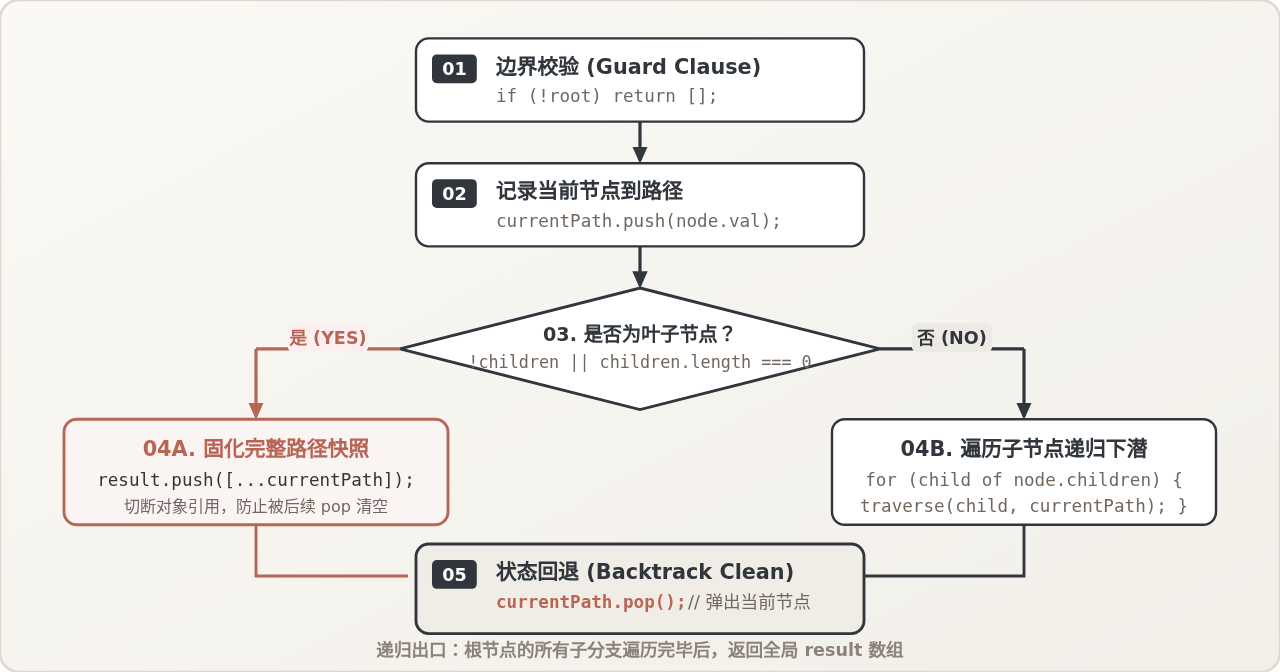
把树结构路径收集落实到代码上,可以拆解为五个清晰标准化的操作阶段:
-
步骤 01:前置安全防御(Guard Clause)
检查输入的根节点root是否有效。若为null或undefined,直接返回空结果集[],避免后续访问root.val触发运行时报错。 -
步骤 02:当前节点入栈(Push State)
在进入traverse函数体首部,立即把当前访问节点的特征值(例如node.val或完整node)追加到currentPath的末尾。 -
步骤 03:分支判定(Branch Decision)
通过!node.children || node.children.length === 0评估当前节点是否已达分支末端。 -
步骤 04A:叶子收敛(Snapshot Persistence)
如果判定为叶子节点,当前currentPath正好完整记录了从根到达此叶子的全量链路,立即调用result.push([...currentPath])截取快照。 -
步骤 04B:子树递归遍历(Subtree Recursion)
若非叶子节点,迭代node.children数组,对每个子节点依次递归调用traverse(child),继续向下延伸路径。 -
步骤 05:回溯清理(Backtrack Cleanup)
在当前节点的全部子树处理完毕即将跳出函数之前,调用currentPath.pop()。它将把当前节点从路径尾部移出,使调用上下文恢复到进入当前节点前的纯净状态。
实现范式对比:共享数组回溯、纯函数不可变与显式栈迭代
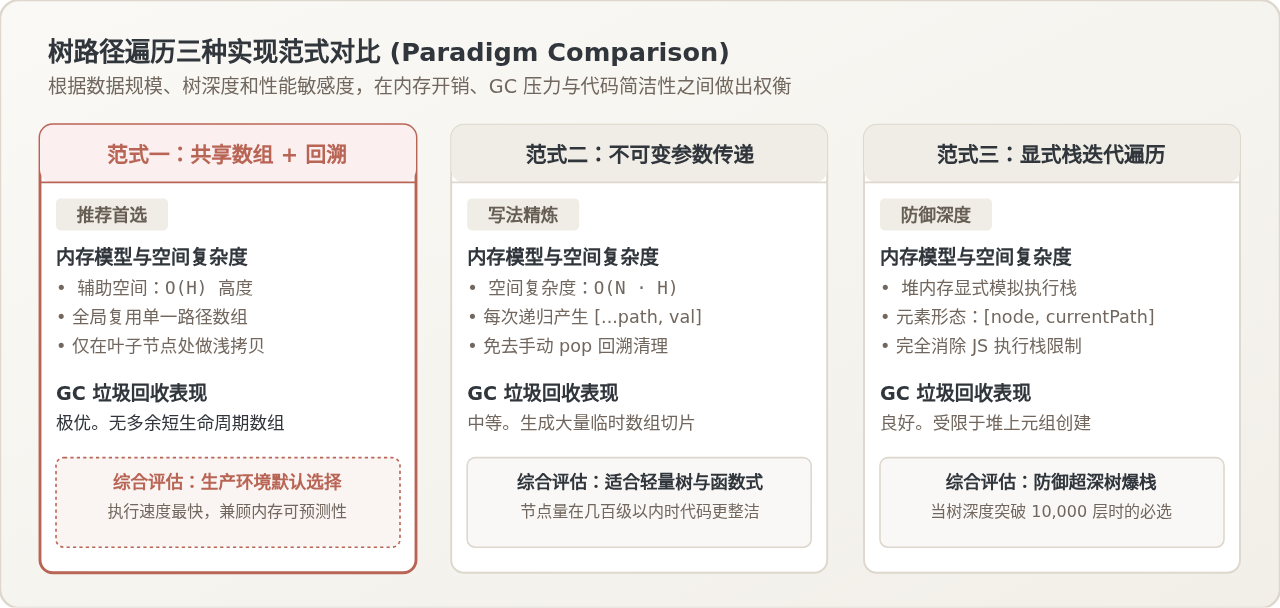
除了前文推荐的“共享数组 + 回溯”范式,根据团队代码规范与树的数据规模,还有另外两种常见的实现风格。不同方案在空间复杂度、垃圾回收(GC)开销和防爆栈能力上存在显著差异。
范式二:不可变纯函数传递(无副作用,适合轻量树)
纯函数式写法的特点是:每次向下递归时,直接把包含当前节点的新数组作为参数传递给下一层。由于每层都拥有自己独立的局部路径变量,因此不需要手动编写 pop() 回溯代码:
/**
 * 纯函数不可变参数传递实现
 */
function getPathsFunctional(node, currentPath = []) {
  if (!node) return [];

  // 每次递归直接通过展开运算符产生新数组
  const newPath = [...currentPath, node.val];
  const isLeaf = !node.children || node.children.length === 0;

  if (isLeaf) {
    return [newPath];
  }

  const result = [];
  for (const child of node.children) {
    result.push(...getPathsFunctional(child, newPath));
  }
  return result;
}优劣分析:代码极短且无共享状态,非常符合 React / Redux 生态推崇的不可变数据习惯。但其缺陷在于:树如果包含 10,000 个节点,算法在递归下潜途中会频繁创建数万个短生命周期的临时数组,显著增加 V8 引擎年轻代(Young Generation)GC 回收压力。
范式三:显式栈迭代遍历(消除 JavaScript 调用栈溢出风险)
JavaScript 引擎(如 Chrome V8 或 Node.js)对递归调用栈的深度有严格上限(通常在 10,000 层左右)。当解析极其深邃的抽象语法树(AST)或层级特别深的链状树时,递归方案会抛出 RangeError: Maximum call stack size exceeded。
通过在堆内存中维护一个自定义的显式栈(Stack),将状态打包为 [node, currentPath] 压栈与出栈,可以彻底规避调用栈溢出问题:
/**
 * 显式栈迭代方式收集路径(抗深度爆栈方案)
 */
function getPathsIterative(root) {
  if (!root) return [];

  const result = [];
  // 显式栈存储元素结构:[当前节点, 到达该节点前累积的路径]
  const stack = [[root, [root.val]]];

  while (stack.length > 0) {
    const [currentNode, path] = stack.pop();
    const isLeaf = !currentNode.children || currentNode.children.length === 0;

    if (isLeaf) {
      result.push(path);
    } else {
      // 为保持与递归相同的前序访问顺序(左优先),子节点倒序入栈
      for (let i = currentNode.children.length - 1; i >= 0; i--) {
        const child = currentNode.children[i];
        stack.push([child, [...path, child.val]]);
      }
    }
  }

  return result;
}
生产环境进阶处理:异构键名、格式化与环引用防御
在企业级应用中,后端接口返回的树数据结构往往各不相同,例如有的使用 subList 代替 children,有的使用 code 代替 val;另外,某些复杂图结构转换不彻底时,节点可能存在循环引用(导致 DFS 进入死循环导致页面崩溃)。
以下是一个高度可配置、具备防御性编程的工业级通用封装:
/**
 * 通用树路径收集器(支持自定义属性键、格式化输出与环引用检测)
 * @param {Object} root 根节点
 * @param {Object} options 配置参数
 * @param {string} options.childrenKey 子节点数组键名,默认 'children'
 * @param {string|Function} options.valueExtractor 节点值提取器,默认提取 'val' 或 'id'
 * @param {boolean} options.formatString 是否格式化为字符串路径,如 'A > B > C'
 * @param {string} options.separator 路径字符串分隔符,默认 ' > '
 * @returns {Array<Array|string>}
 */
function collectTreePaths(root, options = {}) {
  const {
    childrenKey = 'children',
    valueExtractor = node => (node.val !== undefined ? node.val : node.id),
    formatString = false,
    separator = ' > '
  } = options;

  if (!root) return [];

  const result = [];
  const currentPath = [];
  // 防御环形引用:记录当前递归调用链中已经访问过的节点对象
  const visitedInPath = new Set();

  function traverse(node) {
    if (!node || typeof node !== 'object') return;

    // 环形引用检测:若当前调用栈已包含该节点,说明出现死循环链路,主动熔断
    if (visitedInPath.has(node)) {
      console.warn('[collectTreePaths] 检测到树结构中存在循环引用,已自动熔断当前路径', node);
      return;
    }

    visitedInPath.add(node);
    const nodeValue = typeof valueExtractor === 'function' ? valueExtractor(node) : node[valueExtractor];
    currentPath.push(nodeValue);

    const children = node[childrenKey];
    const isLeaf = !Array.isArray(children) || children.length === 0;

    if (isLeaf) {
      if (formatString) {
        result.push(currentPath.join(separator));
      } else {
        result.push([...currentPath]);
      }
    } else {
      for (const child of children) {
        traverse(child);
      }
    }

    // 回溯清理
    currentPath.pop();
    visitedInPath.delete(node);
  }

  traverse(root);
  return result;
}
特殊单节点树验证:当传入的树仅包含一个孤立根节点 { val: 'Root', children: [] } 时,该节点在执行到步骤 03 时即被识别为叶子节点,算法会正确输出 [['Root']],既不会死循环也不会丢失数据,符合边界预期。
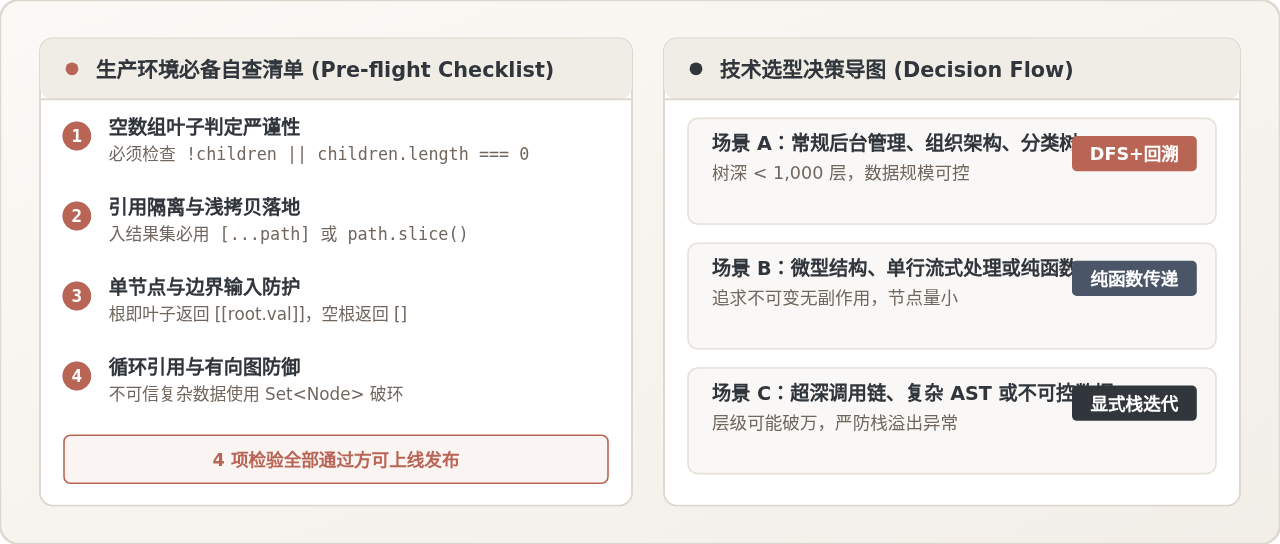
实施自查清单与技术选型总结
| 核对维度 | 合格标准 | 不合规潜在故障 |
|---|---|---|
| 叶子判定条件 | !node.children || node.children.length === 0 |
仅判 !node.children 会把 [] 当非叶子,导致漏掉整条叶子路径 |
| 路径快照隔离 | result.push([...currentPath]) 或 slice() |
直接存引用会导致数组元素在回溯完成后全部被清空为空数组 [] |
| 回溯时序配对 | 函数退出前执行 currentPath.pop() |
漏写 pop() 会使后续分支残留前驱路径,产生杂糅脏数据 |
| 极端树深防御 | 树深 > 10,000 层时改用显式栈迭代方案 | 递归调用深度超限抛出 Maximum call stack size exceeded 崩溃 |
JavaScript对象与数组基础操作入门
2026-11-22 19:51:43
JS控制台console.log输出怎么实现换行
2026-11-22 17:29:57
JavaScript Fetch API怎么使用AbortController实现请求超时
2026-11-22 16:53:58
JS数组筛选后怎么高效去重?结合Set与filter的链式操作
2026-11-22 16:20:36
避免JS数组修改陷阱:浅拷贝与深拷贝的选择
2026-11-22 14:15:31







