

JavaScript引擎排序算法演变:V8中TimSort与稳定性保证
深入解析JavaScript引擎排序算法的历史演变与现代实现,探讨V8如何从早期的快速排序+插入排序混合机制升级为基于Torque的TimSort算法,从而在ECMA-262标准下彻底实现排序稳定性保证。
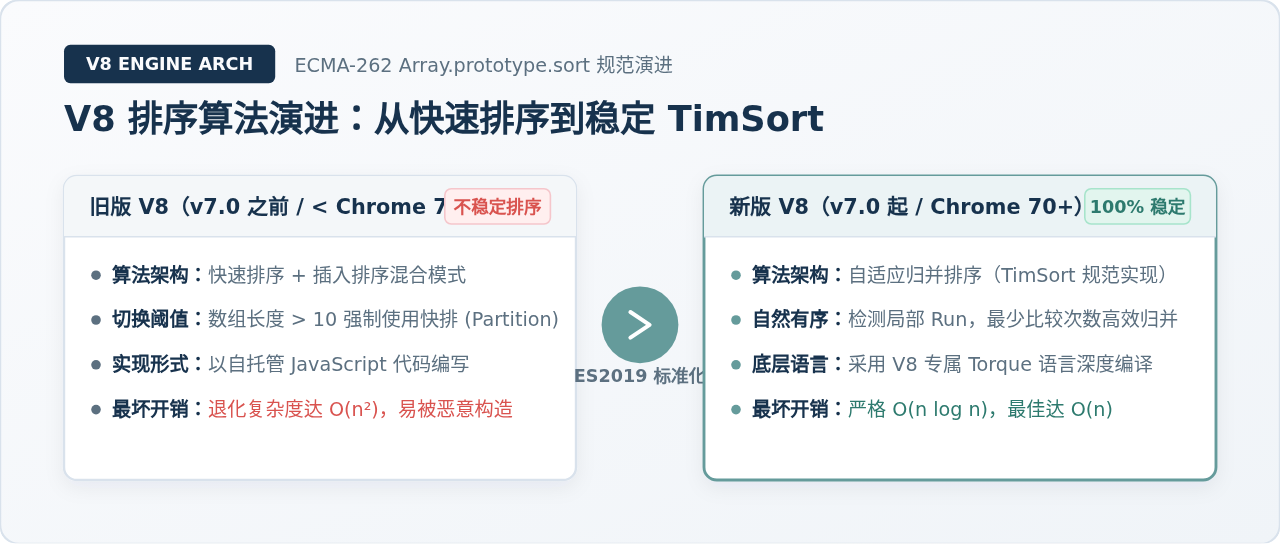
在 ECMAScript 2019 标准正式发布之前,JavaScript 开发者在日常编码中调用 Array.prototype.sort() 时,其底层的排序结果是否“稳定”完全取决于各个浏览器的自主实现。在主流的 Google Chrome 及 Node.js 底层 V8 引擎中,旧版本长期采用以 JavaScript 自身编写的“快速排序(QuickSort)与插入排序(InsertionSort)”混合架构;该设计在数组长度超过 10 时会直接调用快速排序,从而产生等值元素相对位置失序的致命缺陷。自 V8 v7.0(Chrome 70)起,Google 团队彻底重构了该内置函数,引入基于自研语言 Torque 编写的 TimSort 算法,不仅全面达到了 ECMA-262 强制稳定性的要求,而且在真实业务数据的部分有序场景下将时间复杂度优化到了近乎线性的 O(n)。本文将从算法原理、V8 演变史、底层核心机制及工程实践四个维度,为你彻底拆解这一机制。
一、为什么业务开发必须依赖“排序稳定性”?
在算法定义中,排序算法的稳定性(Sorting Stability)指的是:如果待排序序列中存在两个或多个键值相等的元素,在排序完成后,这些相同键值元素之间的相对先后顺序依然与排序前完全保持一致。
很多开发者初学排序算法时,往往只关注渐进时间复杂度(如 O(n log n)),容易认为数值大小相同就无所谓先后。然而在真实业务开发中,待排序的往往不是单一原始数值,而是由多个字段构成的复杂业务对象,多重排序需求非常频繁。
假设系统需要对一批商品订单进行排序,要求“先按【下单时间】由远及近排序,再按【订单金额】从高到低排序”。标准开发策略是流水线式处理:第一轮先依据下单时间排序,第二轮依据订单金额排序。如果第二轮排序算法是稳定的,那么金额相同的订单将严密保留第一轮排序确立的时间先后关系;反之,若第二轮排序不稳定,金额相同的订单将被随意洗牌打乱,前一轮的时间顺序彻底失效。
我们可以用一段精炼的代码直观展示这一差异:
// 待排序的学生成绩列表(已预先按学号升序排列)
const students = [
  { id: 101, name: "张伟", score: 90 },
  { id: 102, name: "李娜", score: 85 },
  { id: 103, name: "王磊", score: 90 },
  { id: 104, name: "赵敏", score: 85 }
];

// 按分数降序排列:
students.sort((a, b) => b.score - a.score);

// 【稳定排序预期结果】:张伟 (101) 仍在 王磊 (103) 前面;李娜 (102) 仍在 赵敏 (104) 前面
// 【不稳定排序反例】:可能变成 [王磊(103), 张伟(101), 赵敏(104), 李娜(102)],相对位移错乱
二、旧版 V8 排序机制回顾及其历史缺陷
在 V8 v7.0 之前(即 Chrome 70 / Node.js 11 及更早版本),V8 的 Array.prototype.sort 并不是直接用 C++ 编写,而是作为一个内建 JavaScript 模块(通过自托管 JavaScript 文件 v8/src/js/array.js)加载执行的。为了在小规模数组和大规模数据间寻求折中,旧版实现采用了混合排序策略:
- 短数组模式(长度 length ≤ 10):直接使用原地插入排序(InsertionSort)。插入排序在交换相邻逆序元素时,天然不会越过相等的元素,因此在短数组下是稳定的。
- 长数组模式(长度 length > 10):一旦数组长度超过 10,代码立即切换为快速排序(QuickSort),通过三数取中法选定基准值(Pivot),进行双向指针分区与元素交换。
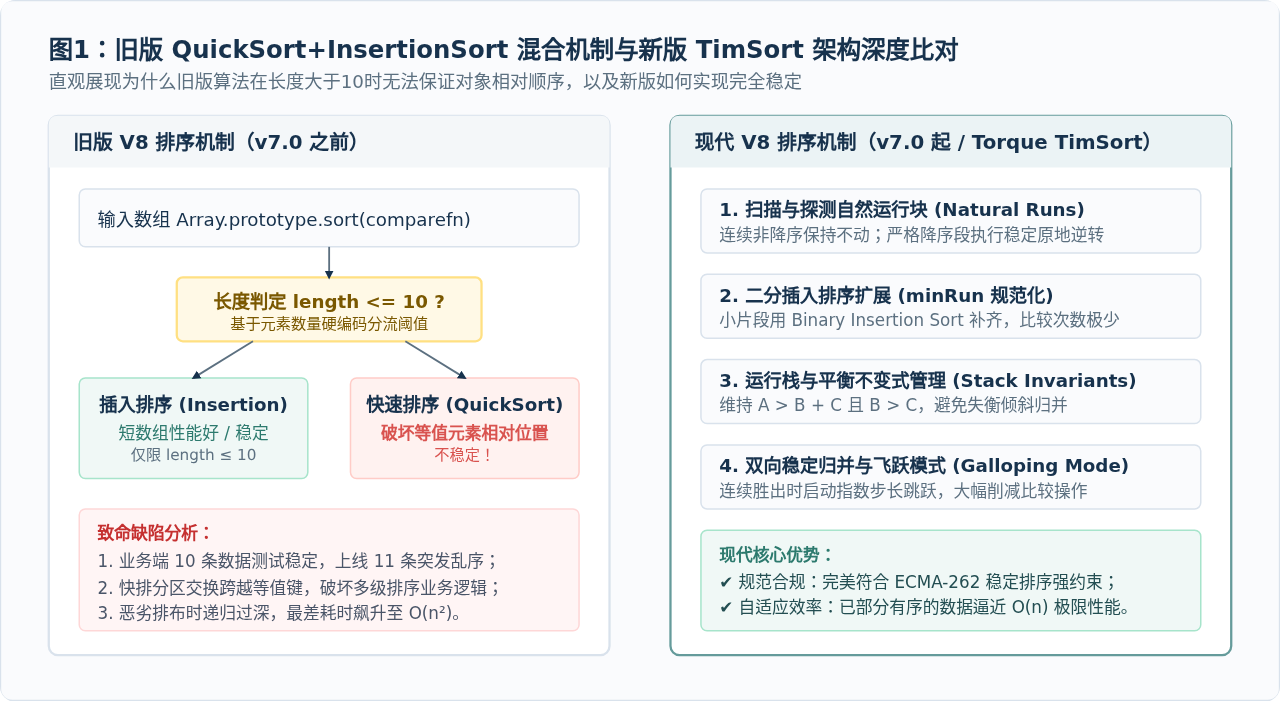
这种设计在当时引发了前端工程领域的巨大痛点:
- “本地测试通过,线上突发乱序”的幽灵 Bug:由于
length ≤ 10具有迷惑性的稳定性,开发者在编写单元测试或录入少量 Mock 数据时,多级排序完全符合预期;然而一旦上线后数据条数达到 11 条,快速排序立即生效,等值对象瞬间被换位,产生难以排查的偶发业务缺陷。 - 极端分布下的性能退化:传统快排如果遇到精心构造的碰撞数据或恶劣分布,递归树深度将退化为
O(n),时间复杂度跌落至O(n²),甚至导致调用栈溢出(Call Stack Overflow)。 - 规范约束缺失:在 ECMAScript 2018(ES9)及更早的规范正文中,对
Array.prototype.sort的稳定性描述为 “The sort is not necessarily stable”(排序不一定是稳定的)。这导致不同 JavaScript 引擎各自为政,SpiderMonkey(Firefox)很早就采用稳定的归并排序,而 V8(Chrome)与 JavaScriptCore(Safari)早期版本均存在不稳定阶段,跨浏览器一致性体验极差。
三、TimSort 算法的诞生与核心运转机理
为了从根本上解决稳定性问题并兼顾真实世界数据的分布特征,ECMA-262 委员会在 ES2019 中正式将“必须为稳定排序”确立为强制规范。V8 团队借此契机,引入了由 Tim Peters 于 2002 年为 Python 语言量身定制的高性能自适应混合排序算法 —— TimSort。
TimSort 结合了插入排序对局部小规模数据的极致处理速度,以及归并排序的稳定性与 O(n log n) 上界保证。更重要的是,现实生产中的业务数据很少是完全杂乱无章的随机噪点,通常已经包含了大量局部递增或递减的“连续自然片段”。TimSort 正是通过探测这些连续片段(称为 Run)来实现自适应提速。
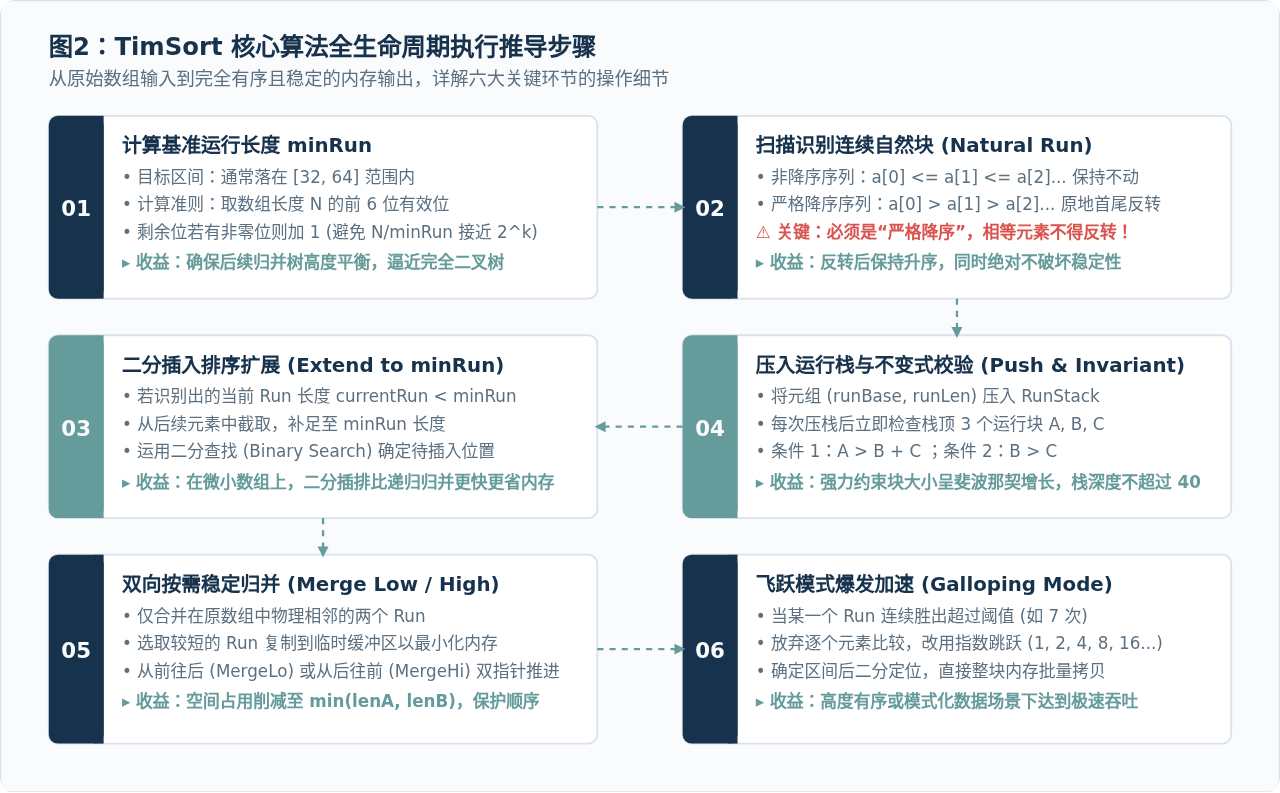
下面我们按照算法执行流水线,详细推导其六大关键步骤:
步骤 1:动态计算基准运行长度 minRun
算法启动后,首先根据输入数组的实际长度 $N$ 计算出一个基准阈值 minRun。minRun 的合理取值通常在 $[32, 64]$ 之间。确定该数值的原则是:使后续整个数组被切分成 Run 的总个数接近或略小于 $2$ 的整数幂(例如 16、32、64),从而让最终的归并阶段形成极其对称的完全二叉树。
在 V8 底层,计算公式相当于提取 $N$ 的最高 6 位有效数字,如果低位存在任何非零位,则结果加 1:
// minRun 计算的逻辑等价模拟
function computeMinRun(n) {
  let r = 0;
  while (n >= 64) {
    r |= (n & 1);
    n >>= 1;
  }
  return n + r;
}
步骤 2:扫描自然连续块(Natural Run)与严格降序逆转
算法从数组首部开始向后顺序扫描:
- 如果遇到连续的非降序片段($a_0 \le a_1 \le a_2 \dots$),直接将其记录为一个 Run。注意此处允许等于,完全保序。
- 如果遇到连续的严格降序片段($a_0 > a_1 > a_2 \dots$),则通过双指针在内存中就地首尾反转该片段,使其转变为升序。
假设遇到数组序列
[5, 5, 2],如果将其当作降序反转,反转后将变成 [2, 5, 5];其中原先在第一个位置的 5 会被交换到第二个 5 的后面,直接摧毁了稳定性!因此,TimSort 严格要求降序判断必须使用 > 而不是 >=。一旦遇到相等项,降序扫描立即截断,确保相等元素的物理先后次序永不颠倒。
步骤 3:运用二分插入排序扩展 Run(Binary Insertion Sort)
如果当前探测到的自然 Run 长度小于计算出的 minRun,TimSort 会从数组后续元素中主动截取元素加入当前 Run,直到其长度达到 minRun 为止。随后,使用二分插入排序对这组扩充后的小数据段进行排序。
二分插入排序利用了 Run 前半部分已经有序的特性,在寻找新元素插入点时使用折半查找(比较次数缩减至 $\lceil\log_2 k ceil$),然后统一后移内存段。对于长度在 32~64 之间的片段,现代 CPU 的 L1/L2 缓存命中率极高,二分插排的实际吞吐量远超复杂的递归算法。
步骤 4:运行栈管理与平衡不变式(Stack Invariants)
每构造完成一个符合规范的 Run,算法就将其起始下标与长度 (runBase, runLen) 压入专门的运行栈(Run Stack)中。为了防止过早合并或过迟合并导致的效率退化,TimSort 规定栈顶的连续三个 Run(从栈底到栈顶记为 $A, B, C$)必须严格满足两大平衡不变式:
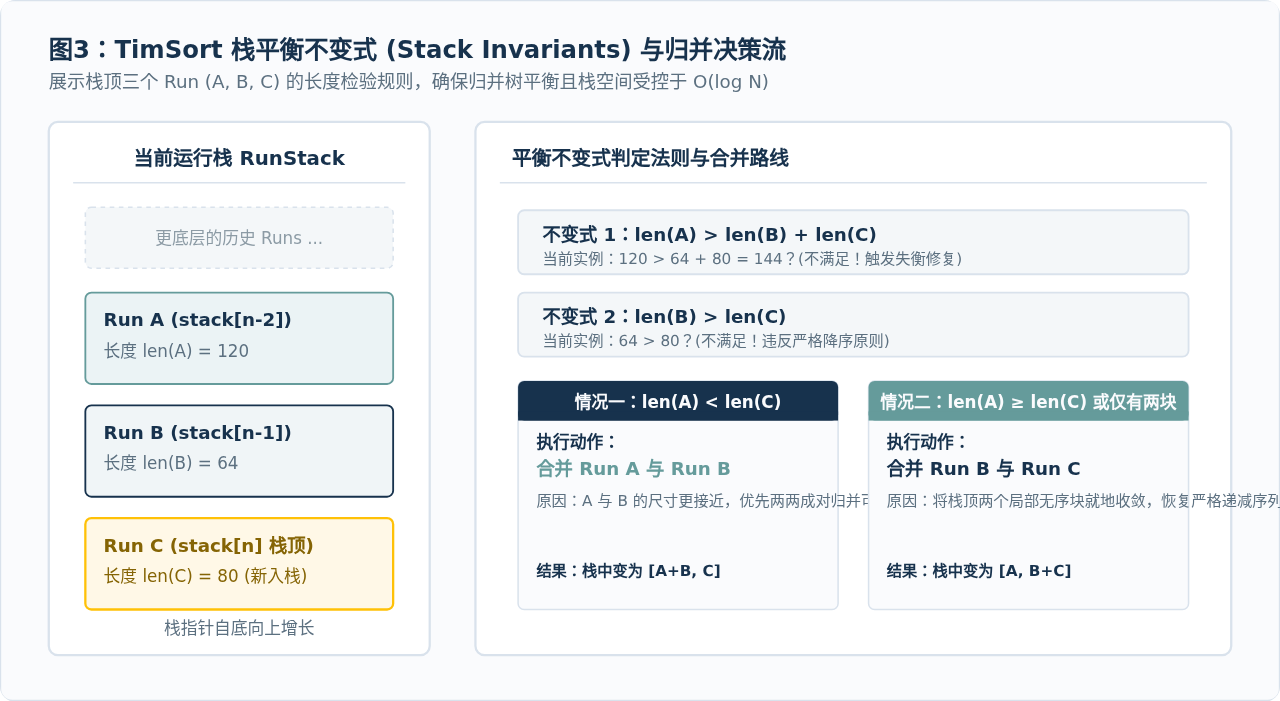
1.
len(A) > len(B) + len(C)2.
len(B) > len(C)
这两个不变式的数学本质极其优美:它强制要求栈内 Run 的长度自底向上呈类似于反向斐波那契数列的超几何增长。只要有任何一个条件被打破,算法就会暂停压栈,立即执行归并:
- 如果
len(A) ≤ len(B) + len(C),且len(A) < len(C),则将 $A$ 与 $B$ 合并;否则将 $B$ 与 $C$ 合并。 - 如果
len(B) ≤ len(C),则将 $B$ 与 $C$ 合并。
通过这套机制,运行栈的最大深度永远不会超过 40(即使针对数以亿计的超大数组),且每次参与归并的两个块大小极其均衡,避免了“大数组吞并单个元素”导致的无谓重复遍历。
步骤 5 & 6:稳定双向归并与飞跃模式(Galloping Mode)
当决定合并两个相邻的 Run(例如 $Run_1$ 和 $Run_2$)时:
- 临时内存节约:算法找出较短的一个 Run,将其拷贝到临时缓冲区。若 $Run_1$ 较短,则从头部向后正向归并(
MergeLo);若 $Run_2$ 较短,则从尾部向前逆向归并(MergeHi)。这样所需的最大临时空间仅为较短块的长度,大幅节省内存。 - 飞跃模式(Galloping Mode):在常规逐个元素比对过程中,如果算法统计发现连续有多个元素(默认阈值为 7 次)全部来自同一个 Run,说明数据存在大段局部块偏置。此时算法立即升级为“飞跃模式”:放弃线性步长,改用指数跳跃(步长 $1, 2, 4, 8, 16 \dots, 2^k$)在另一个 Run 中定位边界,随后用二分查找精确定位,并通过底层内存拷贝(
memmove级别操作)直接成片转移数据。这一优化使高度有序数据的处理速度实现数量级跃升。
四、V8 引擎底层工程落地:Torque 语言与边界处理
算法理论的成熟只是第一步,在 JavaScript 虚拟机这类追求极致性能的工业级环境中,工程落地细节直接决定了代码执行效率与内存安全。在 V8 v7.0 中,团队使用自研的领域特定语言 Torque 全面重构了排序实现。
| 技术维度 | 旧版 V8 实现(JS Builtin) | 新版 V8 实现(Torque TimSort) | 工程收益与影响 |
|---|---|---|---|
| 实现语言 | 自托管 JavaScript (array.js) |
V8 自研 Torque 编译器语言 | 具备强静态类型,直接生成高效机器码,消除 JS 抽象开销 |
| 排序稳定性 | 不保证(长度 > 10 破坏相对位置) | 100% 绝对保证稳定 | 完美遵从 ECMA-262 规范,消除多重排序偶发 Bug |
| 最坏时间复杂度 | $O(n^2)$(快排极端分区恶化) | $O(n \log n)$(严格受控归并树) | 彻底杜绝针对快排 Pivot 的 DoS 算力退化攻击 |
| 最佳时间复杂度 | $O(n \log n)$ | $O(n)$(探测到整段升序) | 针对基本有序数据,单次正向扫描即可直接完成排序 |
| 稀疏数组与 Holes | 逐项检查属性,JIT 容易去优化 | 底层 Fast Elements 紧凑迭代 | 数组空洞自动下沉末尾,执行路径不脱靶 |
1. 空洞(Holes)与 undefined 的特殊下沉规范
ECMA-262 规范明确规定:数组中的 undefined 元素以及稀疏数组的空洞(Holes,即从未赋值的索引项)绝不参与用户自定义比较函数的计算,它们必须被强制排在数组的最终末尾。
Torque 实现的 TimSort 在启动时会首先执行一次快速预处理分区:将实际存在的有效元素与 undefined、稀疏空洞进行分离。空洞在内存中被收集并统一置于底层,所有的 Run 探测与归并计算只在紧凑的有效元素区间内执行。排序结束后,再将对应数量的 undefined 与空洞回填到尾部。这不仅避免了用户 compareFn 频繁处理 undefined 的心智负担,也大幅提升了 CPU 内存预取效率。
2. 用户自定义比较函数异常安全与重入防御
在 JavaScript 中,用户提供的 compareFn 属于不可信的外部执行代码。该回调不仅可能抛出未捕获异常,甚至可能在执行期间利用原型链修改正在排序的原数组。Torque 的 TimSort 实现具备严格的事务与异常安全(Exception Safety)机制:
- 如果用户比较函数在排序中途抛出异常,V8 能够保证数组内部不会遗留损坏的空指针或非法内部对象,所有数据处于安全合法的 JavaScript 对象状态。
- 通过在内部维护元素的只读快照及安全边界校验,防止在比较过程中动态增删元素导致引擎内部内存越界。
五、开发者实战与 compareFn 避坑指南
虽然 V8 引擎在底层确保了算法层面的绝对稳定性,但许多前端开发者依然会在业务代码中写出导致“乱序”的错误比较函数。这是因为排序算法的稳定性保证,严格建立在用户 compareFn 符合数学上的“严格弱序(Strict Weak Ordering)”前提之上。
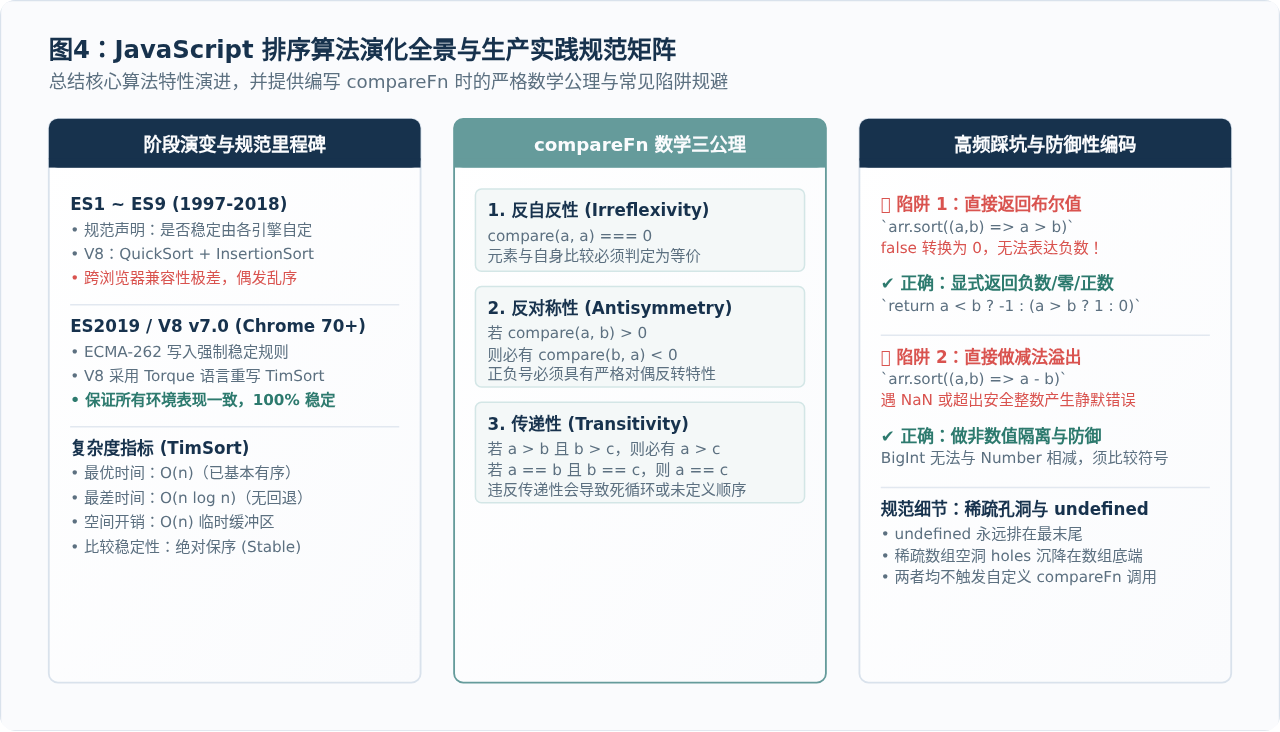
三律公理:严格弱序准则
编写自定义 compareFn(a, b) 时,返回值必须具备严密的符号对称性:
- 反自反性(Irreflexivity):
compareFn(a, a) === 0。一个元素与自己比较,返回值必须为 0。 - 反对称性(Antisymmetry):如果
compareFn(a, b) > 0,那么compareFn(b, a)必须< 0;如果前者为 0,后者也必须为 0。 - 传递性(Transitivity):若 $a > b$ 且 $b > c$,则必须推导出 $a > c$;若 $a \sim b$ 且 $b \sim c$,则必须推导出 $a \sim c$。
高频错误范例排查
许多初学者会写出如下代码:
// ❌ 致命错误写法:返回布尔值
[4, 2, 5, 1, 3].sort((a, b) => a > b);a > b 为真时返回 true(转为数值 1);但当 a <= b 时返回 false(转为数值 0)!它永远无法返回负数,彻底打破了反对称性。在不同引擎或不同长度下,结果将发生完全不可预测的崩塌。
✔ 正确规范写法:
// 正确做法:显式返回三态数值
[4, 2, 5, 1, 3].sort((a, b) => (a < b ? -1 : (a > b ? 1 : 0)));对于数字数组,常见简写为
(a, b) => a - b。这种写法在绝大多数常规整数下运行良好,但包含以下暗坑:
- 如果数组中包含
NaN,a - b结果为NaN,在比较判断中全为 false,破坏传递性。 - 如果涉及超大数值运算或浮点下溢,减法可能发生数值截断。
- 如果是 BigInt 类型,直接与混合类型相减会抛出
TypeError: Cannot mix BigInt and other types。
function safeCompare(a, b) {
  if (Number.isNaN(a)) return 1;  // 将 NaN 统一下沉到末端
  if (Number.isNaN(b)) return -1;
  return a < b ? -1 : (a > b ? 1 : 0);
}
六、全文总结
JavaScript 引擎排序算法从旧版的“快速排序+插入排序双轨混合”向现代“Torque 实现的 TimSort”全面演进,是前端基础设施走向严谨与高性能的重要里程碑:
- 规范与标准的统一:ECMAScript 2019 从根本上消除了跨引擎的实现歧义,强制确立了
Array.prototype.sort的稳定性约束,为复杂业务场景下的多重过滤和级联排序提供了坚实底座。 - 算法与工程的融合:TimSort 兼采插入排序的低常数开销与归并排序的稳定性,通过自适应识别自然 Run、利用栈平衡不变式控制合并倾角,并在高偏置场景下启动飞跃模式,将真实生产环境中的排序性能挖掘到了极致。
- 开发者的规范自觉:引擎底层的稳定性保障必须以合法的比较函数为前提。在日常开发中,始终坚守“严格弱序三律”,拒绝简陋的布尔返回值,才能真正享受现代引擎带来的稳定与极速红利。
怎么用JS正则拒绝01等前导零格式的正整数
2026-11-22 12:19:12
为什么现代开发推荐用Day.js或Temporal替代原生JS Date
2026-11-22 10:08:17
JavaScript数组按时间排序:Date对象与时间戳比较写法
2026-11-22 09:36:51
JavaScript构造函数prototype与实例__proto__的关系解析
2026-11-21 23:21:32
JS闭包会导致内存泄漏吗:原因分析与释放方法
2026-11-21 22:19:43







