

JavaScript快速排序基础实现:递归逻辑与代码详解
详解JavaScript快速排序的基础实现,从基准值选取、数组分区到递归调用栈回溯与边界陷阱,配合完整代码与图解拆解每一步执行逻辑。
快速排序的核心做法是每一轮从数组中选出一个基准值(pivot),把比它小的元素归到左边、其余元素归到右边,再对左右两个子数组重复同样的操作,直到子数组长度不超过 1。下面以一份不修改原数组的基础 JavaScript 实现为主线,完整拆解分区过程、递归调用栈的展开与回溯,以及编写时容易踩中的边界陷阱。
分治思路:一次选定基准值与左右分区
写快速排序之前,先看清单轮操作要完成什么任务:任意挑出一个数当基准值,然后把其他数按大小分成两拨,基准值就会自然落到它最终排序后的正确位置上。左边的所有数都比它小,右边的所有数都不小于它,两边各自内部暂不需要有序,交给下一轮递归去处理即可。
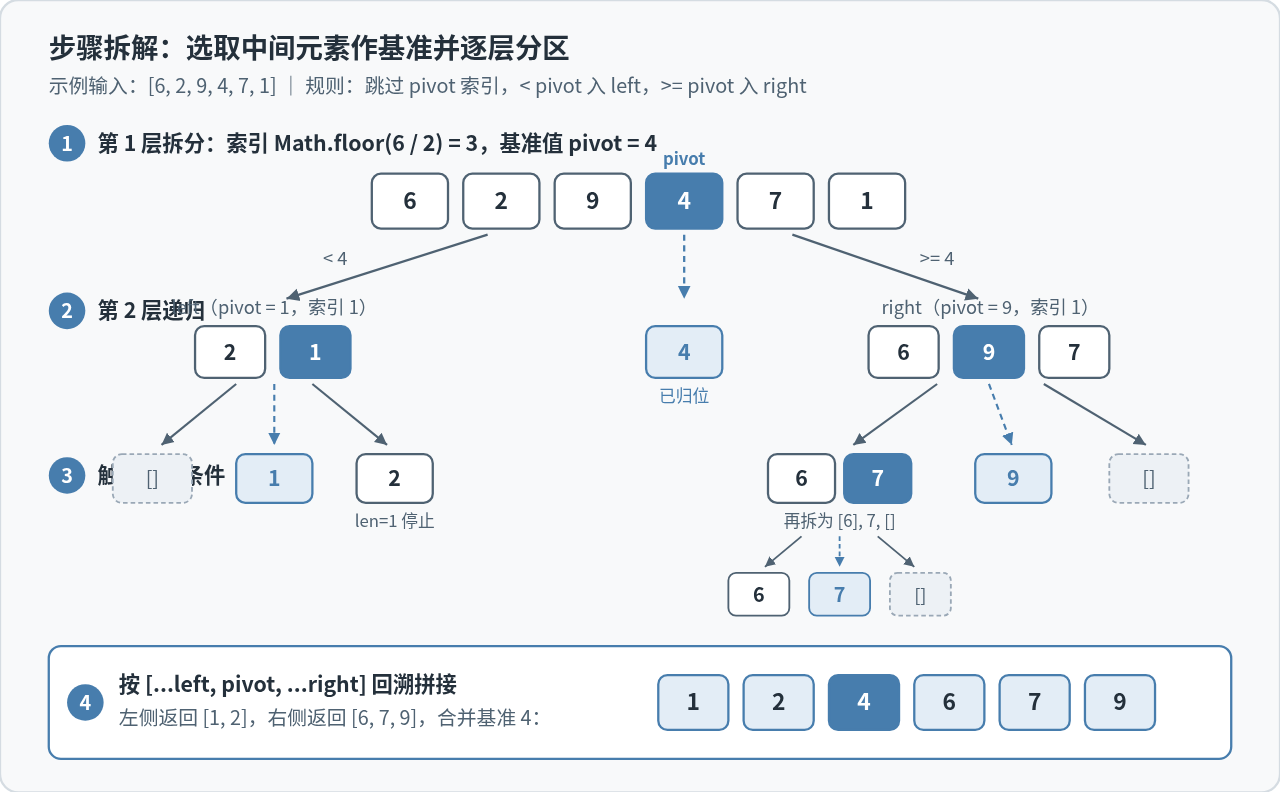
以数组 [6, 2, 9, 4, 7, 1] 为例。如果取中间位置索引 Math.floor(6 / 2) = 3,选出的基准值是 4。跳过索引 3 本身,依次检查剩余元素:2 和 1 小于 4,进入左数组 left = [2, 1];6、9、7 大于或等于 4,进入右数组 right = [6, 9, 7]。
经过这一次分区,问题被拆成两个规模更小的同构子问题:分别排好 [2, 1] 和 [6, 9, 7],再把结果按“左数组 + 基准值 + 右数组”拼在一起。当子数组长度只剩 1 或 0 时,它天然有序,无需继续拆分。
完整基础代码与逐行解析
下面的代码可以直接复制到 Node.js 环境(任意支持 ES6 扩展运算符的版本)或浏览器开发者工具的控制台中运行。它采用“新建左右数组”的纯函数写法,不会改动传入的原始数组。
function quickSort(arr) {
  // 1. 递归终止条件:空数组或单元素数组已经有序
  if (arr.length <= 1) {
    return arr.slice();
  }

  // 2. 选取中间元素作为基准值
  const pivotIndex = Math.floor(arr.length / 2);
  const pivot = arr[pivotIndex];

  // 3. 准备左右分区容器
  const left = [];
  const right = [];

  // 4. 遍历原数组完成分区,注意跳过基准索引本身
  for (let i = 0; i < arr.length; i++) {
    if (i === pivotIndex) {
      continue;
    }
    if (arr[i] < pivot) {
      left.push(arr[i]);
    } else {
      right.push(arr[i]);
    }
  }

  // 5. 递归排序左右两侧,并拼接为新数组返回
  return [...quickSort(left), pivot, ...quickSort(right)];
}

const source = [6, 2, 9, 4, 7, 1];
const sorted = quickSort(source);

console.log("排序结果:", sorted);
console.log("原始数组:", source);排序结果: [ 1, 2, 4, 6, 7, 9 ]
原始数组: [ 6, 2, 9, 4, 7, 1 ]逐段来看这几行代码背后的设计目的:
- 返回
arr.slice()而不是直接return arr:对长度 0 或 1 的数组返回浅拷贝,保证无论数组长度是多少,调用方拿到的始终是一个独立新数组,后续修改sorted不会意外影响source。 - 用
i === pivotIndex跳过基准值:有些教程会用arr.splice(pivotIndex, 1)[0]把基准值从数组里抽出来,但splice会修改传入的arr,导致函数产生副作用。记录索引并在循环中continue跳过,既不破坏原数组,又能确保left和right的长度之和严格等于arr.length - 1。 - 使用扩展运算符
...拼接结果:[...quickSort(left), pivot, ...quickSort(right)]等价于先算出左半部分排序结果、放上基准值、再接上右半部分排序结果。因为 JavaScript 的扩展运算符会按顺序把可迭代对象摊平放进新数组,所以不用再额外写concat。
递归调用栈是如何展开与回溯的
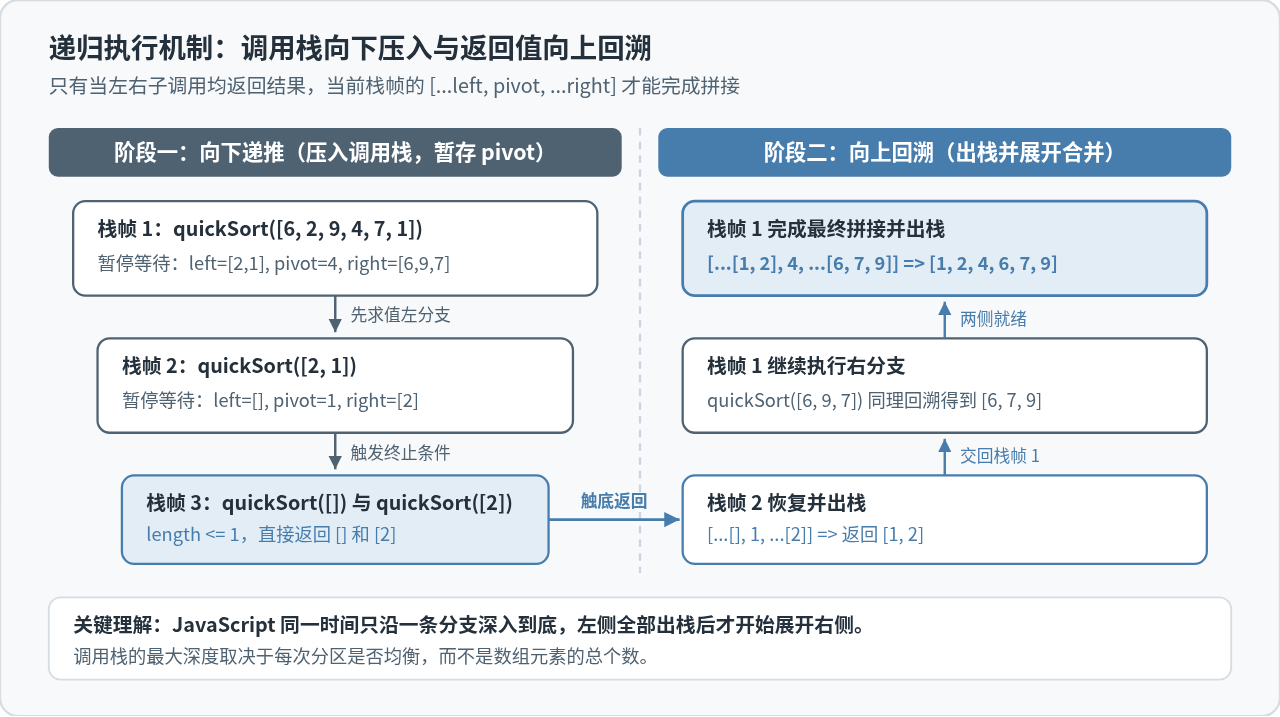
初次读递归代码时,最容易卡住的地方在于最后一行:return [...quickSort(left), pivot, ...quickSort(right)]。在一层函数尚未返回之前,JavaScript 引擎必须先把它的子调用算完,才会把结果交给外层拼接。
具体执行顺序分为“向下压栈”和“向上回溯”两个阶段。还是以 [6, 2, 9, 4, 7, 1] 为例,第 1 层函数计算出 left = [2, 1]、pivot = 4、right = [6, 9, 7] 后,会暂停在 return 语句,先把 quickSort([2, 1]) 压入调用栈。
quickSort([2, 1]) 取索引 1 的元素 1 作基准,拆出 left = [] 和 right = [2]。接下来依次触发两个最底层调用:quickSort([]) 立刻返回 [],quickSort([2]) 立刻返回 [2]。拿到这两个返回值后,第 2 层函数终于可以执行 [...[], 1, ...[2]],算出 [1, 2] 并交还给第 1 层。
第 1 层拿到左侧结果 [1, 2] 之后,才会接着求值右边的 quickSort([6, 9, 7])。右子树按照完全相同的规则向下拆到 [6]、[] 等单元素或空数组,逐层拼出 [6, 7] 和 [6, 7, 9]。最终第 1 层完成 [...[1, 2], 4, ...[6, 7, 9]],整个函数栈清空,得到完整有序数组。
递归终止条件与常见陷阱
快速排序的基础逻辑并不复杂,但写出死循环或性能退化的情况在初学者代码里并不少见。绝大多数问题都集中在下面两个地方。
一、重复元素与未跳过基准索引导致的死循环
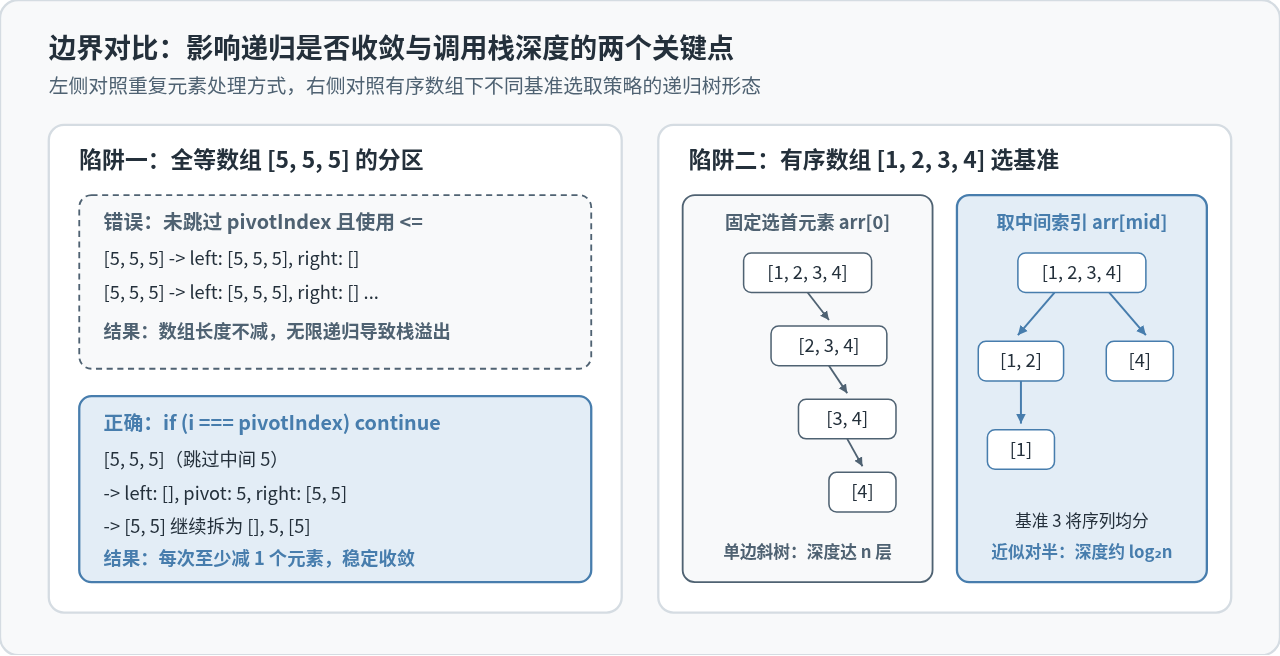
如果在分区循环里忘记写 if (i === pivotIndex) continue,又把判断条件写成 arr[i] <= pivot,当数组里存在重复元素甚至全部元素相等时(例如 [5, 5, 5]),基准值本身也会被塞进 left,导致下一轮传入的子数组长度依然是 3。
因为数组长度永远降不到 1,函数会一直无限递归下去,直到触发 JavaScript 引擎的 RangeError: Maximum call stack size exceeded 报错。确保基准索引被排除在分区之外,才能从数学上保证每次递归的子数组长度至少减少 1。
二、基准值选在端点时,有序数组会拖垮递归深度
有些写法为了省一行计算索引的代码,会直接取第一个元素 arr[0] 或最后一个元素作基准。对于随机打乱的数据,这样做通常没问题;但如果输入恰好是一个已经排好序的数组(如 [1, 2, 3, 4, 5]),每次选 arr[0] 都会成为最小值,导致 left 永远是空数组,right 只少了 1 个元素。
这会让原本平衡的二叉树拆分成一条长度为 n 的单边长链,时间复杂度从平均情况退化到最坏情况,数组稍微大一点(例如数万条有序数据)就可能爆栈。基础实现中取中间位置 Math.floor(arr.length / 2),可以在遇到已排序或逆序数据时依然把数组对半拆开,显著降低爆栈概率。
基础实现与原地分区的差异及适用边界
上面演示的 left / right 写法直观、无副作用,非常适合用来理解快速排序的递归结构,但在真实项目中还有一层空间成本需要心里有数。
| 对比维度 | 新建数组递归版(本文基础实现) | 双指针原地交换版(进阶写法) |
|---|---|---|
| 时间复杂度(平均 / 最坏) | O(n log n) / O(n²) | O(n log n) / O(n²) |
| 额外空间开销 | 较高,每层递归都会创建新的 left、right 和拼接数组,平均 O(n log n) |
较低,直接在原数组内交换元素,仅消耗递归栈空间,平均 O(log n) |
| 是否修改原数组 | 否,返回全新有序数组 | 是,直接原地重排原数组 |
| 代码阅读与调试难度 | 逻辑直观,容易单步跟踪 | 需要维护 low、high 指针与边界交换,细节较多 |
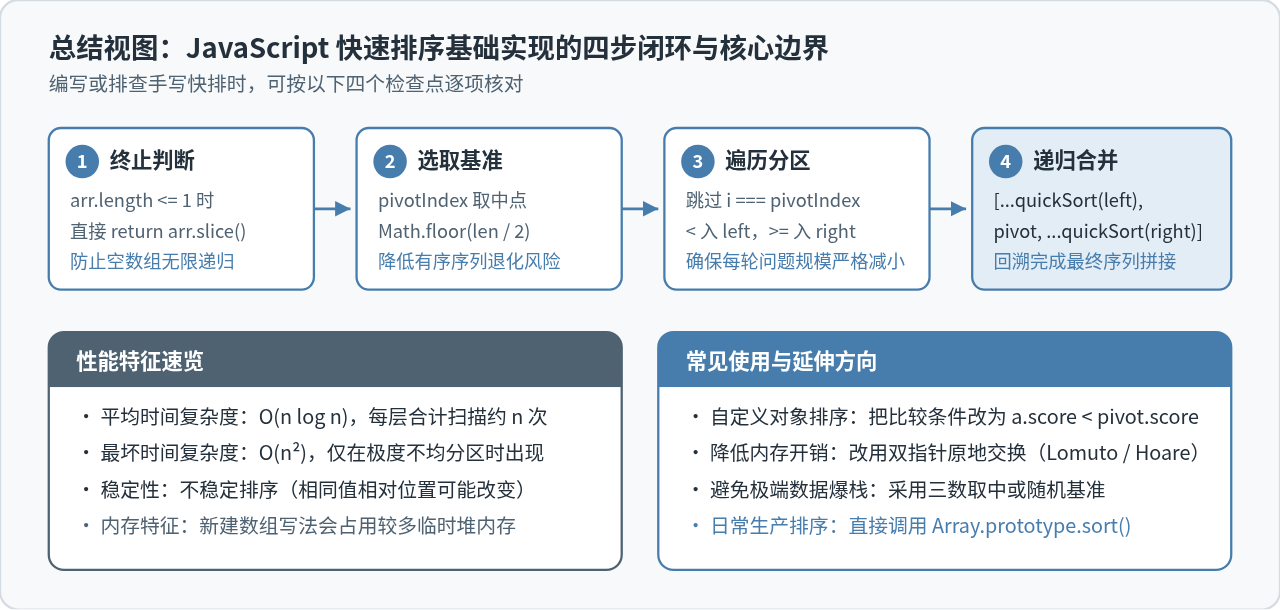
Array.prototype.sort((a, b) => a - b)。现代 JS 引擎对内置排序做了大量底层优化(例如 V8 采用 Timsort,兼顾时间与稳定性),既省去了维护手写排序的成本,也不会因为极端输入轻易爆栈。手写快速排序的价值主要在于理解分治与递归设计,或在面试及特定教学场景下自定义比较与分区过程。
哪些代码写法会触发JavaScript this的默认绑定?
2026-11-22 10:32:03
使用Object.values快速获取JS对象的所有属性值
2026-11-21 23:55:56
JS解析JSON报错SyntaxError的常见原因与调试方法
2026-11-21 23:40:44
OpenLayers与Leaflet离线地图支持对比:JS前端选型建议
2026-11-21 18:11:42
JS防水砂浆施工后出现开裂或空鼓怎么办
2026-11-21 18:10:20







