

JS合并包含对象的数组时怎么避免引用污染
深入解析在 JavaScript 中合并包含对象的数组时产生引用污染的底层机理,提供 structuredClone、映射解构、深克隆等多种实用方案,并附带适用边界与工程验证断言。
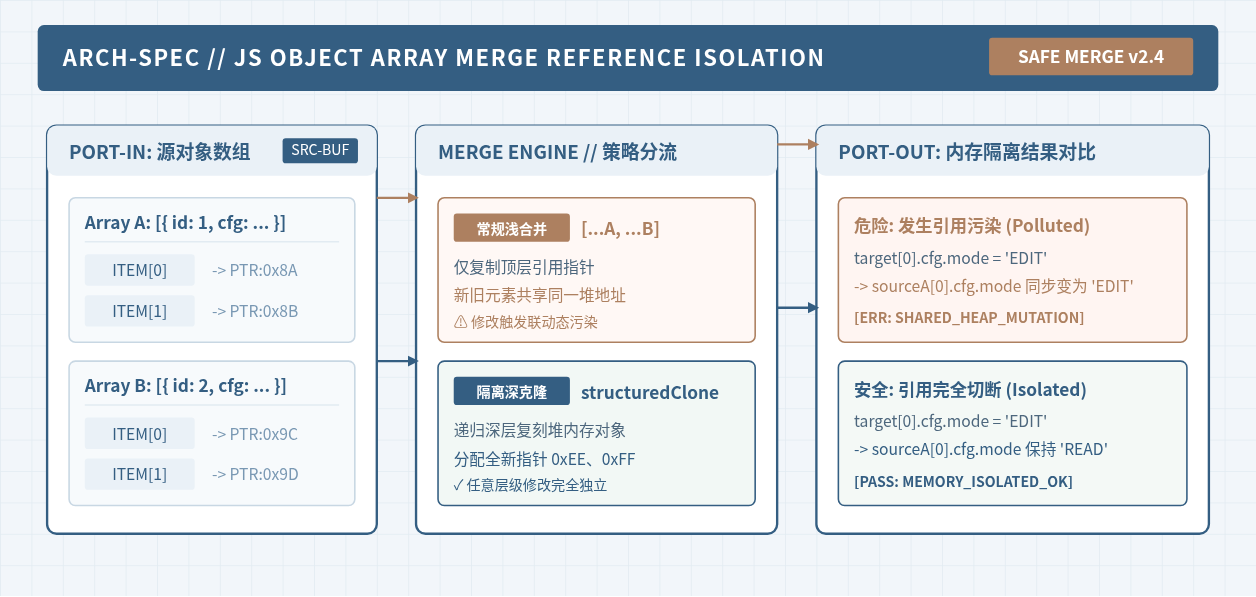
[...arr1, ...arr2] 或 Array.prototype.concat())均为浅拷贝,仅复制数组项的引用地址。当数组元素包含对象或嵌套结构时,新旧数组中的对应项依然指向同一块堆内存。一旦在新数组中修改对象的属性,源数组的数据便会同步发生改变,造成严重的“引用污染”。规避这一问题的核心是在合并过程中切断对象之间的堆引用关系。在现代浏览器和 Node.js 17+ 环境中,优先推荐使用原生全局 structuredClone() API;在单层纯对象的高性能场景下,可采用映射浅克隆 arr.map(item => ({ ...item }));而在具有复杂依赖或特殊环境的场景中,则可通过受控的递归深克隆函数来实现严格的数据隔离。
1. 引用污染的发生机理:浅拷贝与共享堆内存
理解引用污染的前提是分清 JavaScript 运行时的内存分配机制。在 V8 等现代 JavaScript 引擎中,原始值(如 Number、String、Boolean)直接存储在栈内存中,赋值或拷贝时会复制一份独立的值。但对象(Object)、数组(Array)属于引用类型,其实体存储在堆内存(Heap)中,栈内存中保存的仅仅是指向该堆内存区域的指针地址(Memory Address Reference)。
无论是 ES6 引入的展开运算符 [...arr1, ...arr2],还是传统的 arr1.concat(arr2) 方法,其底层规范都只创建了一个新的外层数组容器。在将原数组元素填充至新数组时,引擎执行的是浅拷贝:对于对象元素,引擎直接复制了栈上的指针地址,而没有在堆内存中重新开辟空间分配新对象。
// 两个包含配置对象的源数组
const baseConfigs = [
  { id: 101, env: 'production', options: { retry: 3 } },
  { id: 102, env: 'staging',    options: { retry: 1 } }
];

const customConfigs = [
  { id: 201, env: 'testing',    options: { retry: 5 } }
];

// 使用展开运算符进行合并(浅拷贝)
const mergedConfigs = [...baseConfigs, ...customConfigs];

// 修改合并后数组中第一个元素的属性
mergedConfigs[0].env = 'development';
mergedConfigs[0].options.retry = 99;

// 验证源数组是否被污染
console.log('mergedConfigs[0]:', mergedConfigs[0]);
console.log('baseConfigs[0]:  ', baseConfigs[0]);
console.log('引用严格全等判断:', mergedConfigs[0] === baseConfigs[0]);
baseConfigs[0]: { id: 101, env: 'development', options: { retry: 99 } }
引用严格全等判断: true
从上面的输出可以看到,仅仅修改了 mergedConfigs[0],源数组 baseConfigs[0] 的内容立刻被同步篡改,两者的引用严格全等比较为 true。如果这段逻辑运行在前端状态管理(如 Redux、Pinia)或后端的并发请求处理中,这种隐式污染将直接导致不可预期的状态错乱与幽灵 Bug。
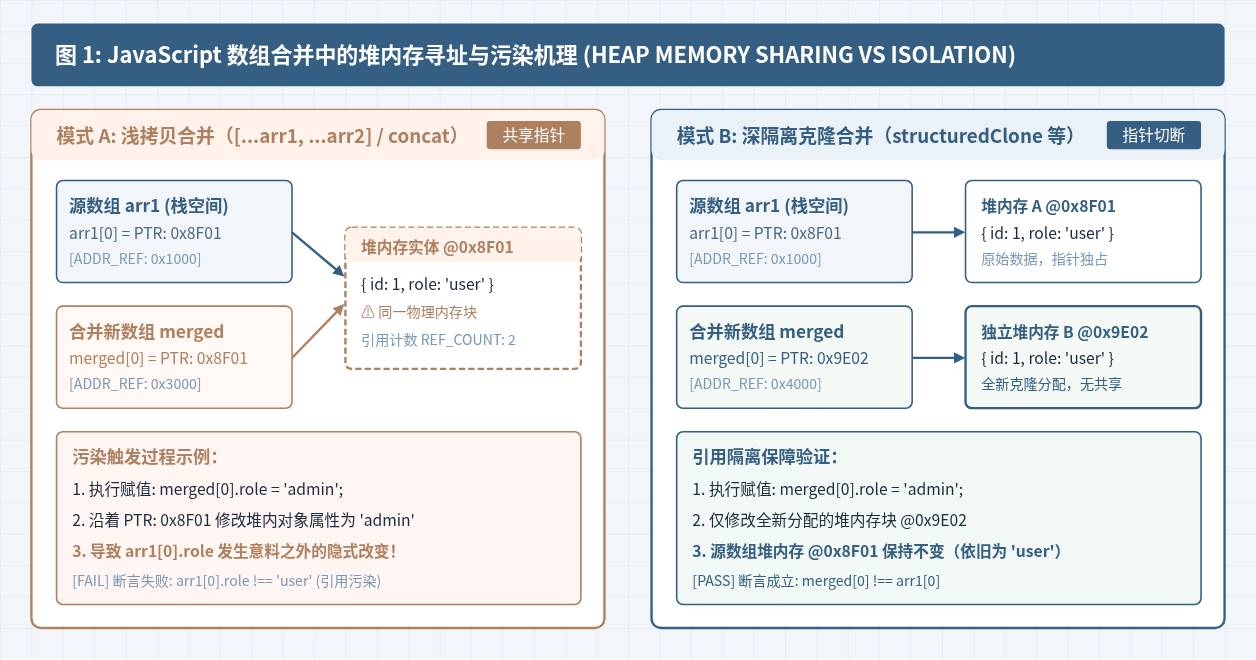
mergedConfigs[0].env 会污染原数据,对内部嵌套对象 mergedConfigs[0].options.retry 的变更同样会沿着指针链穿透到底层源数据。
2. 规避引用污染的 4 步执行管线
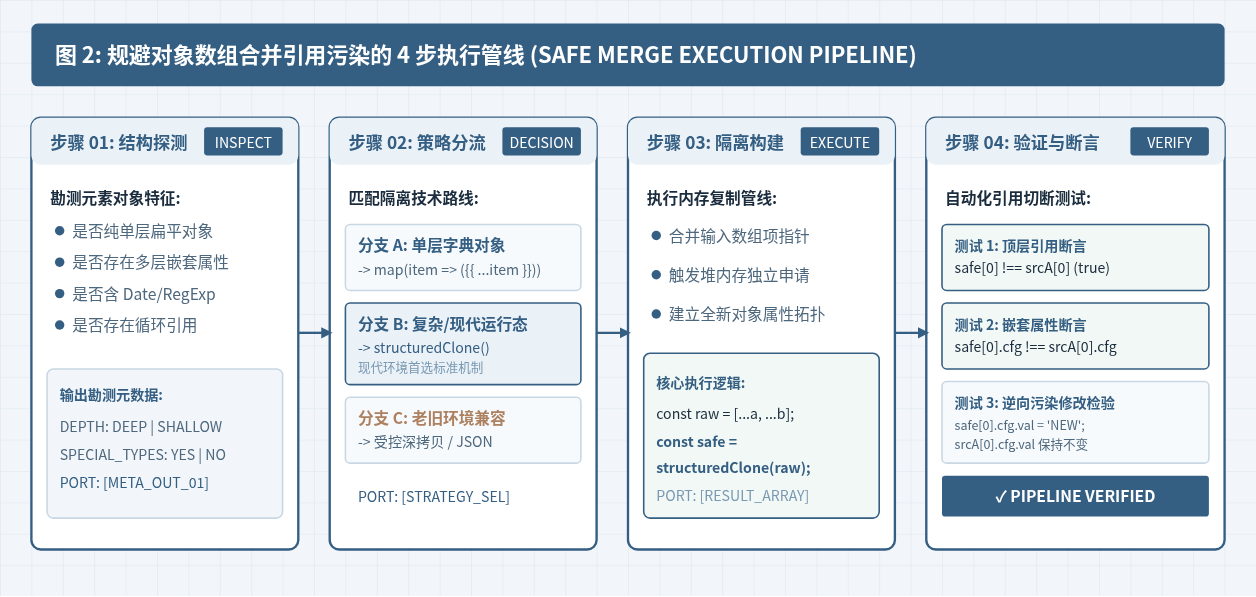
在工程开发中,要确保数组合并的安全性和稳定性,不能随手调用合并语法糖,而应当遵循一套规范化的 4 步处理管线:
-
步骤 01:结构探测(Inspection)
审视合并数组中的对象结构。判定元素是纯单层的扁平对象,还是包含深层嵌套对象、多维数组,或者包含特殊类型(如Date、RegExp、Map、Set、ArrayBuffer)。 -
步骤 02:策略分流(Decision)
依据结构特征和运行环境匹配技术方案。若在现代环境(Node.js 17+ 或现代主流浏览器)处理通用/嵌套数据,选择structuredClone();若元素为确定单层的简单字典,选择映射解构;若需兼容旧版运行时,选择受控深拷贝。 -
步骤 03:隔离构建(Execution)
执行内存隔离克隆与合并,确保新数组中的每一个对象都在堆内存中分配全新物理存储块,彻底切断指针链路。 -
步骤 04:断言检验(Validation)
在核心数据流或单元测试中加入引用独立性断言,通过target[i] !== source[i]验证指针已断开,并通过修改测试验证突变不穿透。
3. 主流解决手段与完整代码实现
方案一:标准原生 API structuredClone()(推荐首选)
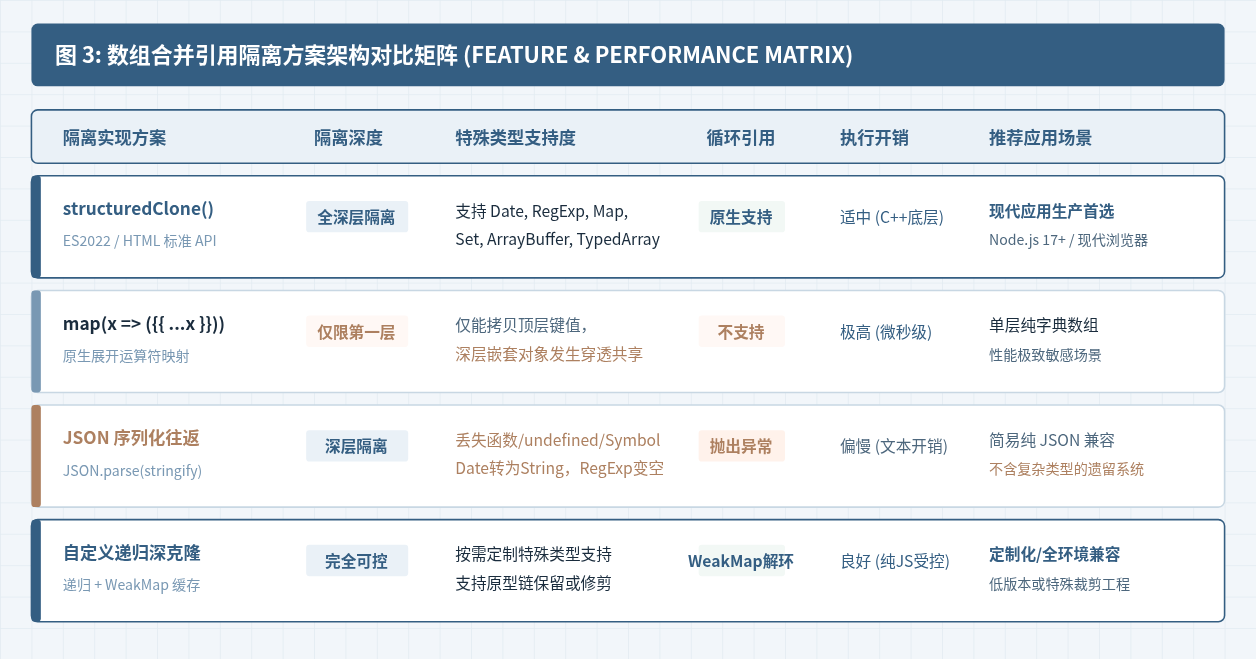
自 HTML 规范将 structuredClone() 纳入全局作用域并在各大主流浏览器与 Node.js 17+ 全面落地后,JavaScript 终于拥有了原生的结构化深克隆标准。它基于 HTML 结构化克隆算法,直接在引擎底层运行,能够安全克隆多层嵌套对象、数组、Map、Set、Date、RegExp、TypedArray,并且天生支持循环引用(Circular References)。
// 包含嵌套对象与循环引用的测试数组
const listA = [
  { id: 1, meta: { title: 'alpha', tags: ['v1', 'web'] }, createdAt: new Date('2026-01-01') }
];

const listB = [
  { id: 2, meta: { title: 'beta', tags: ['v2', 'api'] }, createdAt: new Date('2026-02-01') }
];

// 为 listA 注入循环引用以检验鲁棒性
listA[0].self = listA[0];

// 安全合并函数:先展开合并指针,再进行全量结构化深克隆
function mergeWithStructuredClone(arr1, arr2) {
  return structuredClone([...arr1, ...arr2]);
}

const safeMerged = mergeWithStructuredClone(listA, listB);

// 突变测试
safeMerged[0].meta.title = 'MODIFIED_TITLE';
safeMerged[0].createdAt.setFullYear(2099);

console.log('原数据 title:', listA[0].meta.title);
console.log('新数据 title:', safeMerged[0].meta.title);
console.log('原数据年份: ', listA[0].createdAt.getFullYear());
console.log('新数据年份: ', safeMerged[0].createdAt.getFullYear());
console.log('顶层对象引用是否独立:', safeMerged[0] !== listA[0]);
console.log('嵌套属性引用是否独立:', safeMerged[0].meta !== listA[0].meta);
新数据 title: MODIFIED_TITLE
原数据年份: 2026
新数据年份: 2099
顶层对象引用是否独立: true
嵌套属性引用是否独立: true
structuredClone() 适合绝大多数应用业务数据。但需要注意:结构化克隆算法不支持克隆函数(Function)、DOM 节点以及对象的原型链(Prototype)。如果对象携带有自定义原型方法,克隆后会退化为纯 Object。
方案二:单层解构映射 map(item => ({ ...item }))(轻量单层场景)
如果数组内的对象确定只有单层键值对(例如表格中由数字、字符串组成的纯扁平行数据),不需要递归向下复制深层属性,那么使用 map 结合对象展开运算符是性能最高、代码量最精炼的解决方式。
const usersA = [
  { id: 1, name: 'Alice', score: 92 },
  { id: 2, name: 'Bob',   score: 85 }
];

const usersB = [
  { id: 3, name: 'Charlie', score: 88 }
];

// 在合并时对每个元素解构生成新对象
function mergeFlatObjectArrays(a, b) {
  return [...a, ...b].map(item => ({ ...item }));
}

const mergedUsers = mergeFlatObjectArrays(usersA, usersB);

// 验证独立性
mergedUsers[0].score = 100;

console.log('mergedUsers[0].score:', mergedUsers[0].score);
console.log('usersA[0].score:     ', usersA[0].score);
console.log('引用是否切断:        ', mergedUsers[0] !== usersA[0]);
usersA[0].score: 92
引用是否切断: true
item.profile.avatar),{ ...item } 只会克隆 item 自身,内部的 profile 属性仍然是共享指针!多层结构严禁仅依赖单层展开。
方案三:JSON.parse(JSON.stringify()) 的适用边界与陷阱
在前端开发中,常常能见到使用 JSON 序列化再反序列化进行深拷贝的代码。虽然它能够切断引用并实现深层数据隔离,但在现代工程中应当极其谨慎地使用,必须清楚它的致命边界:
const riskyListA = [
  {
    id: 1,
    date: new Date('2026-05-20T08:00:00Z'),
    regex: /^[a-z]+$/gi,
    emptyVal: undefined,
    compute: function() { return this.id; },
    bigNum: BigInt(9007199254740991) // 会直接报错
  }
];

function jsonCloneMerge(a, b) {
  return JSON.parse(JSON.stringify([...a, ...b]));
}

// 尝试执行(此处移除 BigInt 以便演示后续类型丢失问题)
delete riskyListA[0].bigNum;
const jsonMerged = jsonCloneMerge(riskyListA, []);

console.log('原始 date 类型:', typeof riskyListA[0].date, riskyListA[0].date instanceof Date);
console.log('JSON克隆后 date:', typeof jsonMerged[0].date, jsonMerged[0].date);
console.log('克隆后 regex:   ', jsonMerged[0].regex);
console.log('克隆后 emptyVal:', 'emptyVal' in jsonMerged[0]);
console.log('克隆后 compute: ', jsonMerged[0].compute);
JSON克隆后 date: string 2026-05-20T08:00:00.000Z
克隆后 regex: {}
克隆后 emptyVal: false
克隆后 compute: undefined
通过示例可见:Date 对象被静默转成了 string;RegExp 沦为普通空对象;值为 undefined 的键被整项丢弃;函数被直接抹除;如果遇到循环引用或 BigInt,JSON.stringify 会直接抛出 TypeError 导致程序崩溃。因此,除非明确知道数据是纯粹合法的 JSON 报文子集,否则不推荐使用此方法。
方案四:兼容性通用的递归深克隆合并函数
在需要兼容旧版本运行环境,或者需要精细控制克隆细节的通用工具库中,可以编写一个带有 WeakMap 环形引用缓存的轻量级深拷贝合并函数:
/**
 * 健壮的深拷贝工具函数
 * @param {*} target 需要拷贝的目标对象
 * @param {WeakMap} hash 缓存哈希表,用于解决循环引用
 * @returns {*} 隔离后的全新对象实体
 */
function deepClone(target, hash = new WeakMap()) {
  // 原始类型及 null 直接返回
  if (target === null || typeof target !== 'object') {
    return target;
  }

  // 特殊对象处理
  if (target instanceof Date) return new Date(target);
  if (target instanceof RegExp) return new RegExp(target);
  if (target instanceof Map) {
    const copyMap = new Map();
    target.forEach((val, key) => copyMap.set(key, deepClone(val, hash)));
    return copyMap;
  }
  if (target instanceof Set) {
    const copySet = new Set();
    target.forEach(val => copySet.add(deepClone(val, hash)));
    return copySet;
  }

  // 命中环形引用缓存,直接返回已克隆对象
  if (hash.has(target)) {
    return hash.get(target);
  }

  // 初始化目标数组或对象
  const result = Array.isArray(target) ? [] : Object.create(Object.getPrototypeOf(target));
  hash.set(target, result);

  // 递归处理自身所有可枚举属性
  Reflect.ownKeys(target).forEach(key => {
    result[key] = deepClone(target[key], hash);
  });

  return result;
}

/**
 * 深度隔离安全合并数组
 */
function safeMergeArrays(arr1, arr2) {
  const combined = [...arr1, ...arr2];
  return deepClone(combined);
}

// 验证运行
const origin1 = [{ id: 1, info: { name: 'node-A' } }];
const origin2 = [{ id: 2, info: { name: 'node-B' } }];
const safeResult = safeMergeArrays(origin1, origin2);

safeResult[0].info.name = 'MUTATED';

console.log('safeResult[0].info.name:', safeResult[0].info.name);
console.log('origin1[0].info.name:   ', origin1[0].info.name);
console.log('深层隔离成立:', safeResult[0].info !== origin1[0].info);
origin1[0].info.name: node-A
深层隔离成立: true
4. 容易踩坑的边界与注意事项
1. 警惕 Object.assign 带来的“伪安全”
有些开发者试图通过 [...arr1, ...arr2].map(x => Object.assign({}, x)) 来防御污染。实际上,Object.assign 与展开运算符 { ...x } 的行为完全一致,都只是浅拷贝。一旦对象具有嵌套属性,浅拷贝依然会暴露出指针共享的致命缺陷。
2. 海量数据场景下的性能与内存平衡
深拷贝会遍历对象的整个属性图,并在堆内存中为每个对象开辟全新的存储块。如果数组长度达到上万条,且每个对象层级深厚,全量深克隆可能会导致数百毫秒的 CPU 耗时以及瞬时内存占用陡增。在处理超大数据集时,应当根据业务场景评估:
- 如果只是对合并后的某些特定项进行修改,优先采用“写时复制(Copy-on-Write)”策略:合并时保持浅合并,仅在需要变动具体某个索引项时单独克隆该项。
- 在大型复杂前端应用中,可考虑结合不可变数据方案(如 Immer),在更新层实现结构共享,避免盲目的全量深克隆。
3. 严格区分只读需求与修改需求
如果合并后的数组仅仅用于数据展示、下拉列表渲染或计算总和,而不涉及任何修改操作,直接使用浅拷贝 [...arr1, ...arr2] 是完全安全且性能最优的选择。引用污染发生的充要条件是“指针共享”与“就地写操作(Mutation)”同时存在。只有当明确需要对合并后的新对象进行属性写操作时,才必须执行深层克隆。
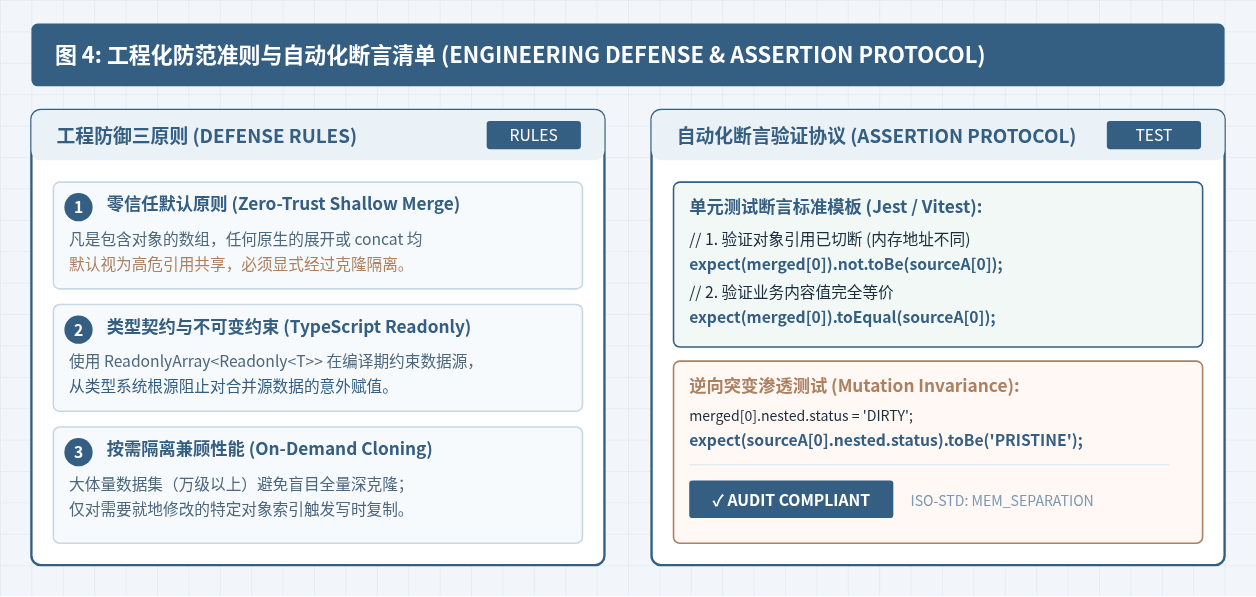
5. 工程化防范与自动化验证清单
在团队协作的大型项目中,单纯依靠开发者的记忆与自律难以完全杜绝引用污染。应当通过静态类型约束与自动化单元测试构建双重防护防线。
静态类型防御:TypeScript 只读修饰
在 TypeScript 环境中,对源数据声明为 ReadonlyArray<Readonly<T>> 或 DeepReadonly<T>,任何试图就地修改对象属性的代码都会在编译阶段被类型检查器直接拦截:
interface UserConfig {
  readonly id: number;
  readonly settings: {
    readonly theme: string;
  };
}

const list1: ReadonlyArray<UserConfig> = [/* ... */];
const list2: ReadonlyArray<UserConfig> = [/* ... */];

const merged = [...list1, ...list2];
// TypeScript 编译错误: 无法为“theme”赋值,因为它是只读属性
// merged[0].settings.theme = 'dark';
动态验证:编写引用独立性断言
在编写针对数组合并工具函数或数据处理管道的单元测试(如使用 Jest、Vitest)时,务必包含以下两个维度的核心断言:
import { describe, it, expect } from 'vitest';

describe('数组安全合并测试', () => {
  it('应当确保合并后的对象与源数据完全切断引用', () => {
    const a = [{ id: 1, conf: { debug: true } }];
    const b = [{ id: 2, conf: { debug: false } }];

    const result = structuredClone([...a, ...b]);

    // 1. 验证对象引用不全等 (确保指向不同堆内存)
    expect(result[0]).not.toBe(a[0]);
    expect(result[0].conf).not.toBe(a[0].conf);

    // 2. 验证内容值等价 (确保克隆数据准确完整)
    expect(result[0]).toEqual(a[0]);

    // 3. 突变渗透验证 (修改结果不应反向影响源数据)
    result[0].conf.debug = 'MUTATED';
    expect(a[0].conf.debug).toBe(true);
  });
});
JS正则表达式匹配正整数的基础写法
2026-11-21 21:08:26
怎么用JavaScript正则验证手机号、邮箱和URL格式
2026-11-21 20:18:35
JS结合setTimeout实现延时自动跳转URL的方法
2026-11-21 19:51:08
JS递归遍历嵌套对象:实现深拷贝与数据清洗
2026-11-21 17:33:21
怎么在Dreamweaver中插入和管理JavaScript代码
2026-11-21 17:25:53







