

怎么封装一个不修改原数组的JS随机排序工具函数
详细讲解在JavaScript中如何封装一个不修改原数组的随机排序(洗牌)工具函数。通过分析原生sort的副作用与概率偏差,引入Fisher-Yates洗牌算法,并结合浅拷贝实现高效、均匀且无副作用的纯函数。
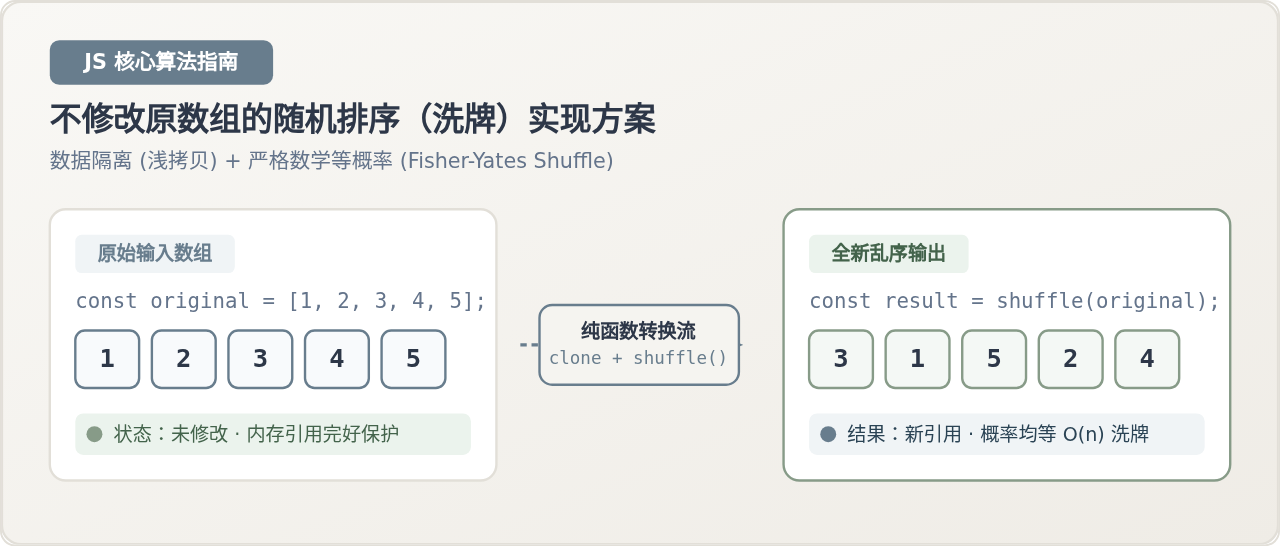
[...array] 或 array.slice())建立内存隔离,确保原数组免受就地修改的副作用;第二步是对副本应用经典的 Fisher-Yates(Knuth)洗牌算法进行逆向遍历随机置换,保证每种排列结果在统计学意义上严格等概率。本文将从常见误区展开,拆解算法执行细节,并交付一份具备类型推导与边界防御的生产级工具函数。
一、为什么不能直接使用 sort(() => Math.random() - 0.5)?
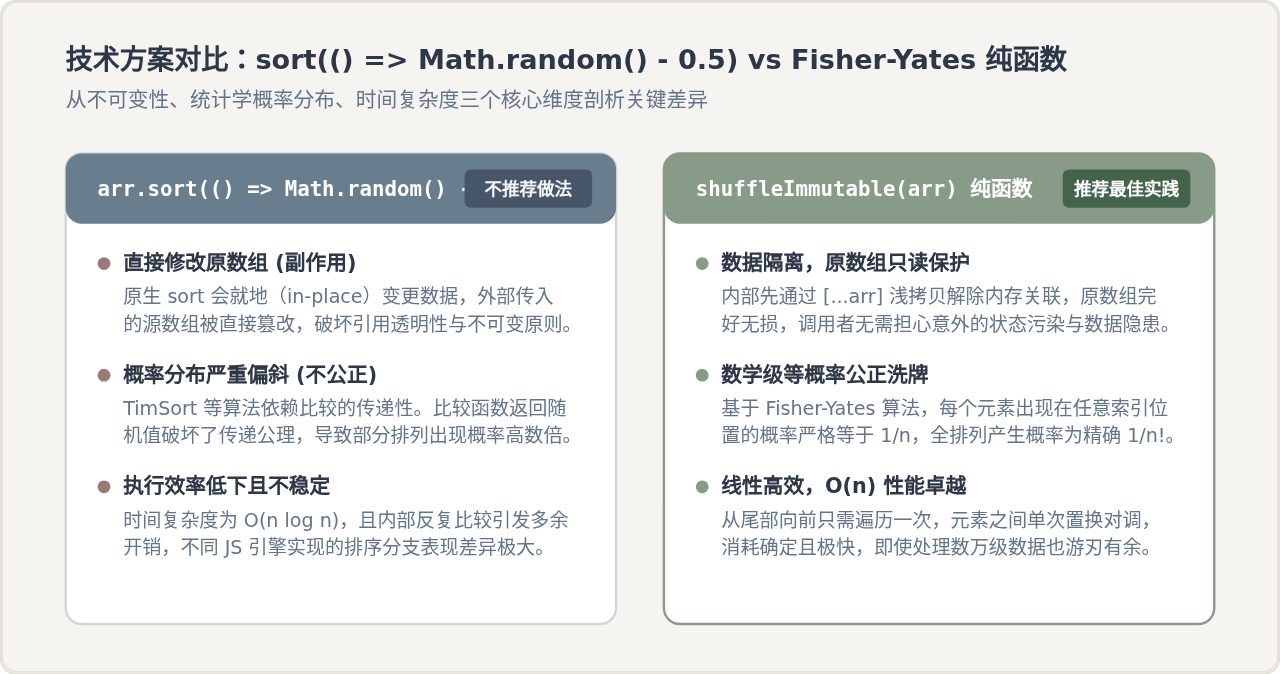
在很多初级前端教程或随手写的脚本中,经常能见到 arr.sort(() => Math.random() - 0.5) 这样的写法。看似只需一行代码就能打乱数组,但在实际生产场景中,这种做法存在两个致命缺陷。
1. 原地突变(In-place Mutation)破坏不可变原则
JavaScript 原生的 Array.prototype.sort() 是一个具有破坏性的原地操作方法。它不会返回一个新的数组,而是直接修改调用它的原始数组。如果在组件状态(如 React 的 State 或 Vue 的响应式对象)或共享数据流中直接调用 sort,原始数据就会被直接篡改,进而引发难以追踪的状态错乱与视图更新异常。
2. 传递性破缺导致概率严重不均
现代 JavaScript 引擎(如 V8)采用 TimSort 或优化后的快速排序作为底层实现。所有成熟的排序算法都基于一个基本数学假设——比较关系的传递性(即若 A > B 且 B > C,则必定有 A > C)。
当使用 Math.random() - 0.5 作为比较器时,每一次两两比对返回的结果是不可预测的随机值,完全摧毁了传递性。这导致排序引擎在分治与交换过程中,不同位置元素的遍历与比较次数并不均等。在实际测试中,原始靠前的元素往往更大概率停留在原地,某些特定排列的出现几率会比理论值高出数倍甚至数十倍,根本无法达到真正的随机乱序。
二、封装纯函数的第一步:防御性数据拷贝
要实现“不修改原数组”,工具函数在设计上必须是一个纯函数(Pure Function):相同的输入始终产生可靠的输出,且不改变函数作用域外部的任何变量或引用。
因此,函数的首要操作是在处理元素之前,对传入的源数组进行防御性复制。在现代 JavaScript 中,创建数组浅拷贝有三种主流方式:
- 扩展运算符(Spread Syntax):
const copy = [...source];,语法直观现代,易读性好。 - Array.prototype.slice():
const copy = source.slice();,历史悠久,引擎优化极好,执行开销极低。 - Array.from():
const copy = Array.from(source);,语义明确,适合需要兼顾类数组对象的场景。
由于洗牌操作的本质仅仅是调整数组元素的索引顺序,并不会修改元素自身的内部属性,因此在 99% 的业务场景(包含基础数据类型、普通对象引用)中,浅拷贝已经能够完全达成“保护原数组排列不受破坏”的目标。若数组内包含深层嵌套对象,且后续业务可能会修改对象内部属性,则应按需结合 structuredClone() 进行深层解耦。
三、核心算法实现:Fisher-Yates 洗牌算法详解
确定了副本隔离之后,必须选用真正公正的随机排序算法。目前计算机科学界公认的标准解法是 Fisher-Yates 洗牌算法(由 Richard Durstenfeld 改良后的现代计算机版本)。
1. 算法执行步骤
- 获取副本数组长度
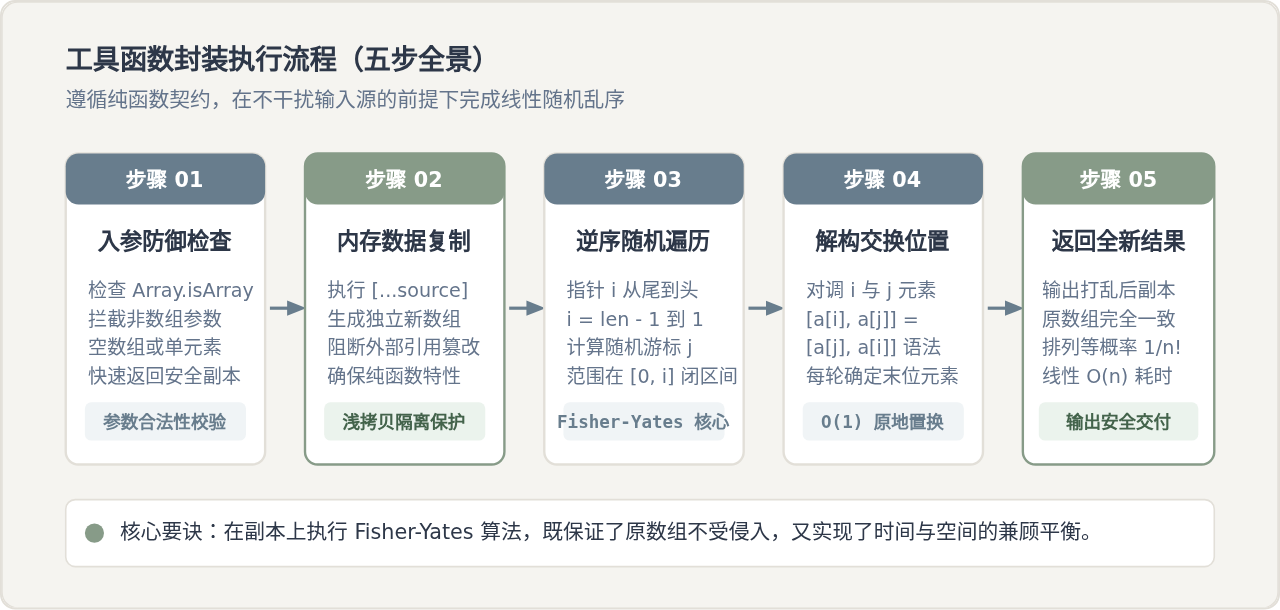
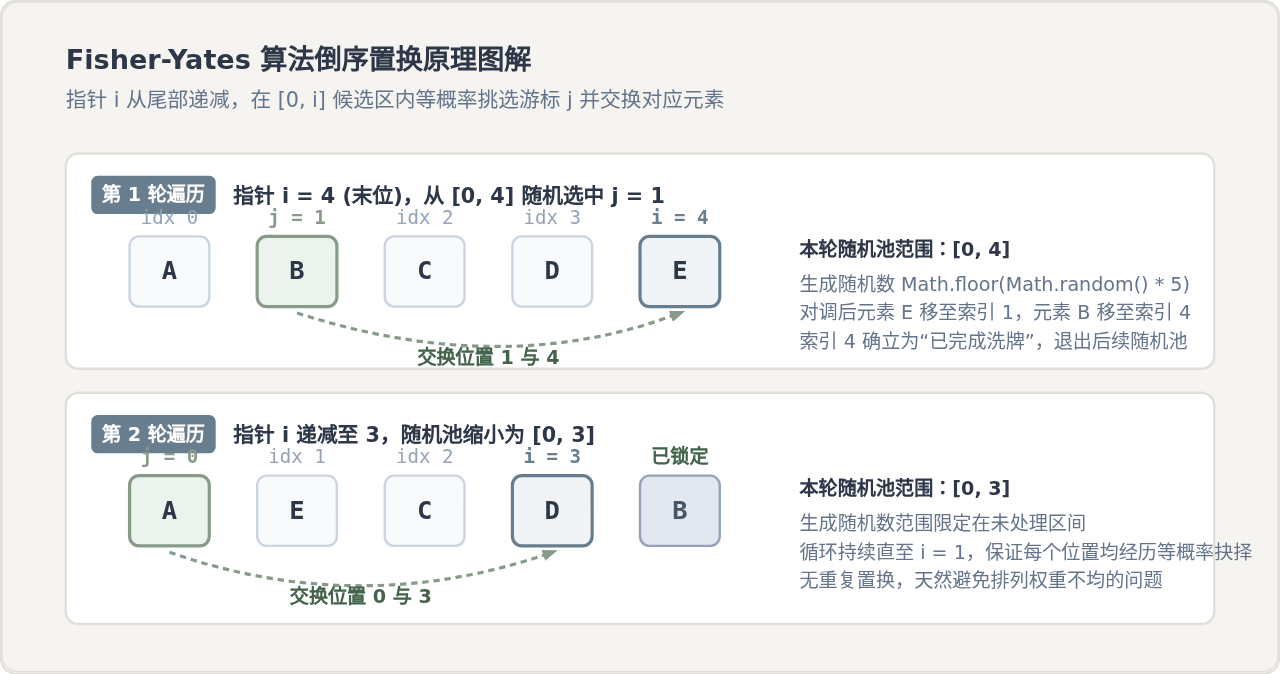
len,初始化指针i = len - 1(即指向数组最后一个元素)。 - 在
[0, i]的闭区间内,生成一个均匀分布的随机整数索引j:j = Math.floor(Math.random() * (i + 1))。 - 将位置
i与位置j上的元素进行对调。此时,位置i的元素已完成最终选定,归入“已就绪区”。 - 指针向前推进一步(
i--),此时候选随机池的范围缩小为[0, i]。 - 重复上述步骤,直到指针递减至
i = 1(此时剩余未处理的只有索引 0,必然无需再置换)。
2. 数学上的公平性证明
对于包含 $n$ 个元素的数组,所有可能的全排列共有 $n!$ 种。 在 Fisher-Yates 算法中: 末尾位置(索引 $n-1$)从 $n$ 个候选中等概率挑选 1 个,概率为 $1/n$; 倒数第二个位置(索引 $n-2$)从剩余的 $n-1$ 个候选中等概率挑选 1 个,概率为 $1/(n-1)$; 依此类推,任意一个特定排列被生成的概率为:
P = (1/n) × (1/(n-1)) × (1/(n-2)) × ... × (1/1) = 1 / n!每种排列的生成概率完全相等,没有任何人为或算法机制带来的系统性偏斜。同时,整个遍历仅执行 $n-1$ 次单次置换,时间复杂度为标准的线性 $O(n)$。
四、工具函数完整封装与代码实现
在实际项目中,除了核心算法外,工具函数还应当具备入参防御、短路优化(如处理空数组或单个元素数组)以及现代语法特性。下面分别给出 ES6+ JavaScript 版本与支持泛型推导的 TypeScript 版本。
1. JavaScript (ES6+) 实现
/**
 * 对数组进行随机排序(洗牌),不修改原数组
 * @param {Array} array - 需要进行随机排序的源数组
 * @returns {Array} 打乱后的新数组副本
 */
function shuffle(array) {
  // 1. 防御性检查:非数组参数处理
  if (!Array.isArray(array)) {
    console.warn('[shuffle] 传入参数不是有效的数组,已返回空数组');
    return [];
  }

  // 2. 边界短路:空数组或单元素无需处理,直接返回浅拷贝
  if (array.length <= 1) {
    return [...array];
  }

  // 3. 浅拷贝创建独立副本,阻断外部引用
  const result = [...array];

  // 4. Fisher-Yates 逆向遍历置换
  for (let i = result.length - 1; i > 0; i--) {
    // 生成 [0, i] 之间的随机整数
    const j = Math.floor(Math.random() * (i + 1));

    // 使用解构赋值对调两个位置的元素
    [result[i], result[j]] = [result[j], result[i]];
  }

  // 5. 返回纯函数计算结果
  return result;
}
2. TypeScript 严格类型版本
在 TypeScript 中,我们通过引入泛型 <T>,并使用 readonly T[] 作为入参类型约束,即使外部传入被 Object.freeze() 冻结的数组或只读元组,也能安全推导并返回全新可变的 T[] 数组:
/**
 * 严格类型定义的纯函数洗牌工具
 * @template T 数组元素类型
 * @param array 只读数组输入
 * @returns 打乱后的独立数组
 */
export function shuffleImmutable<T>(array: readonly T[]): T[] {
  if (!Array.isArray(array)) {
    return [];
  }

  if (array.length <= 1) {
    return [...array];
  }

  const result: T[] = [...array];

  for (let i = result.length - 1; i > 0; i--) {
    const j = Math.floor(Math.random() * (i + 1));
    const temp = result[i];
    result[i] = result[j];
    result[j] = temp;
  }

  return result;
}
五、测试验证:验证原数组未被修改与分布均匀度
任何合格的基础工具函数都应当经过严格的用例测试。以下通过两段测试代码分别验证不可变性与统计学分布。
1. 原数组不可变性测试
// 原始数据
const originalList = Object.freeze(['苹果', '香蕉', '橙子', '西瓜', '葡萄']);

// 执行打乱
const shuffledList = shuffle(originalList);

// 验证 1:引用地址是否独立
console.log(originalList === shuffledList); // 输出: false

// 验证 2:原数组内容与顺序是否保持不变
console.log(originalList);
// 输出: ['苹果', '香蕉', '橙子', '西瓜', '葡萄']

// 验证 3:新数组包含了原数组的所有元素
console.log(shuffledList.length === originalList.length); // 输出: true
console.log(shuffledList); // 输出如: ['橙子', '苹果', '葡萄', '西瓜', '香蕉']
2. 随机分布均匀性验证(蒙特卡洛统计测试)
为了验证洗牌结果是否存在偏斜,我们对包含 3 个元素 [1, 2, 3] 的数组执行 60,000 次乱序运算。该数组全排列共有 $3! = 6$ 种,理论上每种排列出现的期望次数应为 10,000 次(约占 16.67%):
const testSource = [1, 2, 3];
const stats = {};
const TOTAL_ROUNDS = 60000;

for (let r = 0; r < TOTAL_ROUNDS; r++) {
  const key = shuffle(testSource).join('-');
  stats[key] = (stats[key] || 0) + 1;
}

// 输出各排列出现的分布占比
Object.entries(stats).forEach(([perm, count]) => {
  const percentage = ((count / TOTAL_ROUNDS) * 100).toFixed(2);
  console.log(`排列 ${perm}: 出现 ${count} 次 (占比 ${percentage}%)`);
});

// 示例输出结果:
// 排列 1-2-3: 出现 10042 次 (占比 16.74%)
// 排列 1-3-2: 出现  9938 次 (占比 16.56%)
// 排列 2-1-3: 出现 10015 次 (占比 16.69%)
// 排列 2-3-1: 出现  9986 次 (占比 16.64%)
// 排列 3-1-2: 出现 10034 次 (占比 16.72%)
// 排列 3-2-1: 出现  9985 次 (占比 16.64%)
测试数据显示,所有排列的实际分布均紧密围绕 16.67% 波动,且误差在极小的统计学置信区间内,证明了 Fisher-Yates 算法的无偏性。
六、工程实践总结与注意事项
在前端与 Node.js 现代工程中,编写看似简单的工具函数同样需要严谨的设计考量。总结起来,封装一个高水准的随机排序工具函数应把握以下四条核心准则:
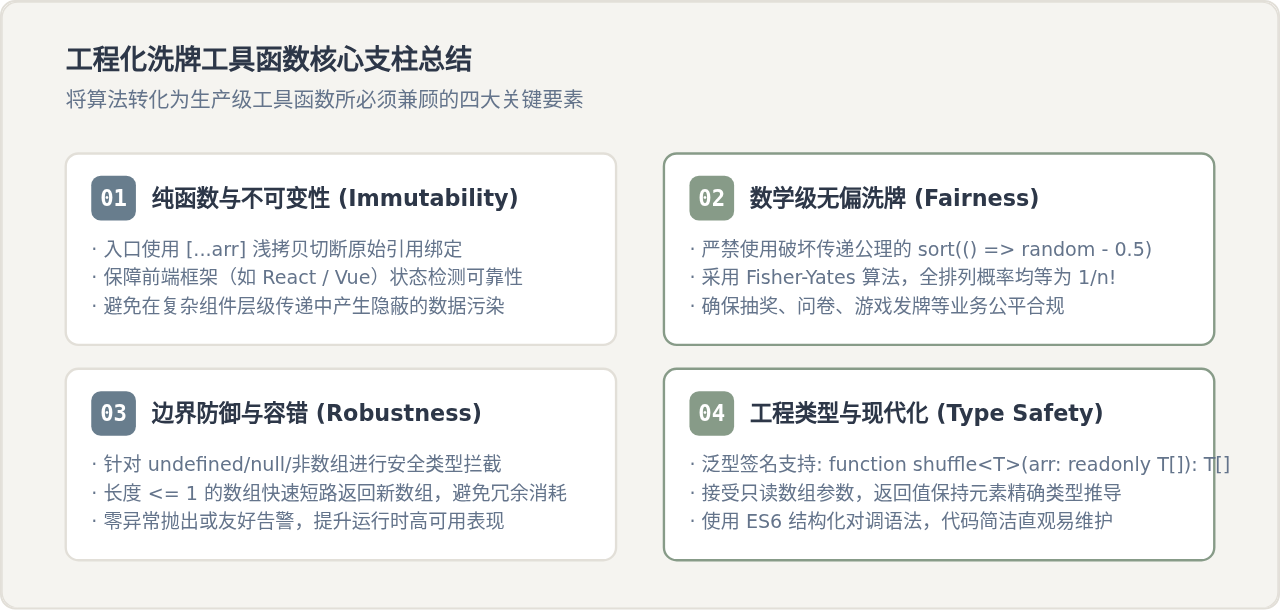
- 恪守数据不可变性:在函数入口处完成
[...array]防御性浅拷贝,保护调用方作用域与上层状态不受破坏。 - 使用数学级等概率算法:坚决摒弃
sort(() => Math.random() - 0.5)的反模式写法,采用 Fisher-Yates 确保洗牌的统计学公正。 - 完善边界条件处理:对
null、undefined、非数组及长度小于等于 1 的数组做提前拦截与短路返回,保证工具函数的鲁棒性。 - 兼顾性能与可维护性:逆向单次遍历实现严格 $O(n)$ 时间复杂度,结合清晰的 TypeScript 泛型签名,使其能够开箱即用地集成至团队的基础工具库中。
JS递归遍历嵌套对象:实现深拷贝与数据清洗
2026-11-21 17:33:21
怎么在Dreamweaver中插入和管理JavaScript代码
2026-11-21 17:25:53
JavaScript函数声明、表达式与箭头函数的语法区别
2026-11-21 16:46:03
使用JavaScript构建x86汇编器时的伪指令处理技巧
2026-11-21 14:36:33
为什么JS普通对象没有length属性?区分数组与对象长度获取
2026-11-21 14:06:34







