

JS数组内置方法map、filter和reduce详解及使用场景
全面解析 JavaScript 中 map、filter 与 reduce 三大数组核心高阶方法的运行机制、参数规范、实战使用场景与常见边界避坑指南。
在 JavaScript 中,处理数组集合数据的核心方式已经从传统的命令式循环全面转向以 map、filter 和 reduce 为代表的声明式高阶方法。这三个方法通过传入回调函数解耦了数据遍历过程与业务转换逻辑,并且天然遵循不可变原则(不改变原数组)。本文直接梳理它们的核心执行原理、参数细节、实操场景与常见认知陷阱,建立清晰且直观的数组转换心智模型。
一、三大内置方法的核心特征与不可变公理
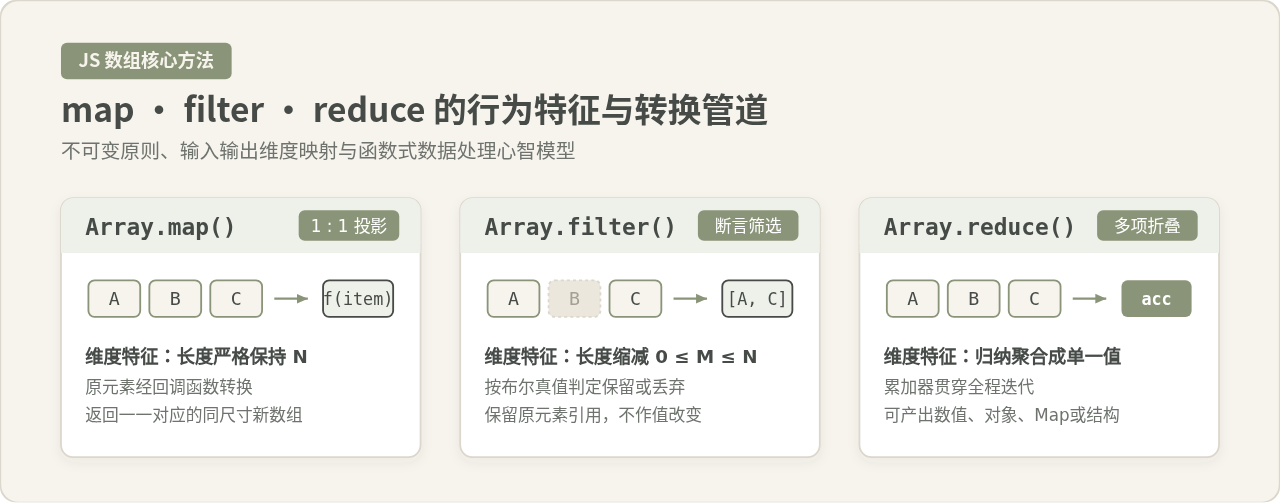
在深入逐个方法前,必须确立它们共同依托的设计原则:它们都是定义在 Array.prototype 上的高阶函数(Higher-Order Functions),即接收一个自定义函数作为参数来主导每一项的计算规则。
与传统的 arr.push()、arr.splice() 或 arr.sort() 等会“原地修改(Mutate)”原数组的方法截然不同,map、filter 和 reduce 遵循函数式编程中的数据不可变性(Immutability)要求:
- 不污染数据源:原数组中的值或索引结构保持原封不动。
- 纯计算派生:操作结果均作为新开辟的数组或全新累加计算值通过函数返回值交付。
- 链式可组装:由于输出结果结构确定,多个方法可以流畅地串联(Chaining),形成如同工业流水线般的声明式数据清洗管道。
二、Array.prototype.map 详解与典型场景
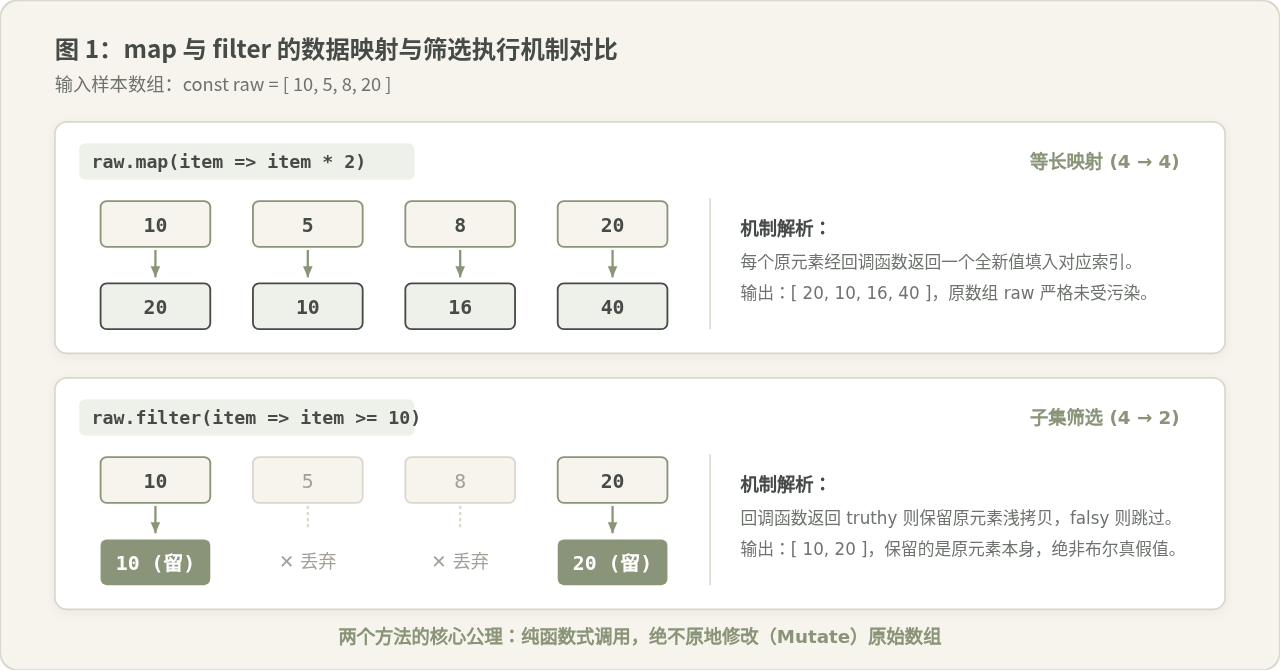
map 的核心使命是“一对一转换(Projection)”。当面对一个长度为 N 的数组,需要对其中每一项执行某种映射并产出严格等长的新数组时,map 是唯一语义精确的标准工具。
1. 完整语法与参数说明
const newArray = arr.map(function(currentValue, index, array) {
  // 必须通过 return 返回转换后的新值
  return transformedValue;
}, thisArg);
参数解析:
currentValue:当前正在处理的数组项。index(可选):当前项在数组中的索引位置(从 0 开始)。array(可选):调用map的原始数组本身。thisArg(可选):执行回调函数时绑定的this上下文。在现代箭头函数中通常不需要传递。
2. 典型使用场景与代码示例
场景 A:提取并重构接口数据模型
后端 API 返回的列表往往包含过多非必要字段或时间戳,前端在传递给表格或图表组件前,通常需要标准化字段名并转换格式:
const rawUsers = [
  { id: 101, name: "张三", created_at: 1700000000000, balance_cents: 5600 },
  { id: 102, name: "李四", created_at: 1700086400000, balance_cents: 12000 }
];

// 提取展示模型:单位换算与时间本地化
const displayUsers = rawUsers.map(user => ({
  userId: user.id,
  userName: user.name,
  balanceYuan: (user.balance_cents / 100).toFixed(2),
  registeredDate: new Date(user.created_at).toLocaleDateString("zh-CN")
}));

// 示例输出:
// [
//   { userId: 101, userName: "张三", balanceYuan: "56.00", registeredDate: "2023/11/15" },
//   { userId: 102, userName: "李四", balanceYuan: "120.00", registeredDate: "2023/11/16" }
// ]
场景 B:提取对象数组中的单一字段生成标识数组
const productList = [
  { id: "p-1", title: "显示器" },
  { id: "p-2", title: "机械键盘" },
  { id: "p-3", title: "无线鼠标" }
];

const productIds = productList.map(p => p.id);
// 示例输出: ["p-1", "p-2", "p-3"]
初学者常以为 parseInt 只接收一个字符串参数,而忽略了 map 传递给回调函数的第二项是 index。这导致实际执行等价于:
parseInt('1', 0):radix 为 0 时默认按十进制解析,返回1;parseInt('2', 1):一进制不存在字符 '2',解析失败返回NaN;parseInt('3', 2):二进制只识别 0 和 1,字符 '3' 非法,返回NaN。
修正方案:避免盲目传递多参数函数,明确封装单参箭头函数:['1', '2', '3'].map(x => parseInt(x, 10)) 或 ['1', '2', '3'].map(Number)。
有的开发者为了让代码“看起来像现代语法”,会写 users.map(u => sendEmail(u)),但没有任何变量接收返回的数组。此时 map 额外分配了一个全是 undefined 的全新数组,白白浪费内存。仅需遍历并产生副作用时,务必使用 forEach 或 for...of。
三、Array.prototype.filter 详解与典型场景
filter 的核心使命是“条件筛选(Selection)”。它通过执行断言(Predicate)函数判断每个元素是否符合保留条件,并返回由符合条件的原元素组成的新数组。新数组长度满足 0 ≤ M ≤ N。
1. 完整语法与参数说明
const filteredArray = arr.filter(function(currentValue, index, array) {
  // 返回真值(truthy)保留该项;返回假值(falsy)剔除该项
  return condition;
}, thisArg);
关键细节:回调函数返回的不必是严格的布尔值 true 或 false。JavaScript 运行时会对返回值进行强制布尔转换(Boolean(returnValue))。只要转换为真(Truthy),该项就会被纳入新数组。
2. 典型使用场景与代码示例
场景 A:清除空值、假值与非法项
直接利用全局构造函数 Boolean 作为断言函数,是 JavaScript 中极其精炼的清理技巧:
const mixedData = ["苹果", "", 0, null, "香蕉", undefined, NaN, "西瓜"];

const validStrings = mixedData.filter(Boolean);
// 示例输出: ["苹果", "香蕉", "西瓜"]
场景 B:多维度复合条件搜索
根据用户在界面上动态选择的多个过滤维度(如分类、价格上限、在售状态)进行联合断言:
const goods = [
  { name: "轻薄笔记本", category: "数码", price: 4899, isOnline: true },
  { name: "办公转椅", category: "家具", price: 350, isOnline: true },
  { name: "降噪耳机", category: "数码", price: 799, isOnline: false },
  { name: "4K显示器", category: "数码", price: 1699, isOnline: true }
];

// 筛选数码品类、在售且价格低于 2000 元的商品
const matchedGoods = goods.filter(item => {
  const matchCategory = item.category === "数码";
  const matchStatus = item.isOnline === true;
  const matchPrice = item.price < 2000;
  return matchCategory && matchStatus && matchPrice;
});

// 示例输出: [ { name: "4K显示器", category: "数码", price: 1699, isOnline: true } ]
场景 C:不可变删除指定 ID 的列表项
在 React、Vue 等前端框架的状态管理中,严禁直接对原状态数组执行 splice,此时 filter 是实现不可变剔除的标准解法:
const currentTodos = [
  { id: 1, text: "撰写报告" },
  { id: 2, text: "整理代码" },
  { id: 3, text: "发送邮件" }
];

const idToDelete = 2;
const remainingTodos = currentTodos.filter(todo => todo.id !== idToDelete);
// 示例输出: 包含 id 为 1 和 3 的新数组实例
filter 返回的是一个全新外层数组,但其内部包含的复合对象元素并没有做深拷贝。如果修改了过滤后数组中的某个对象属性,原数组中对应的对象同样会被改变。若需要完全断开数据引用,必须配合对象展开运算符或克隆工具进行深处理。
四、Array.prototype.reduce 详解与累加器运作机制
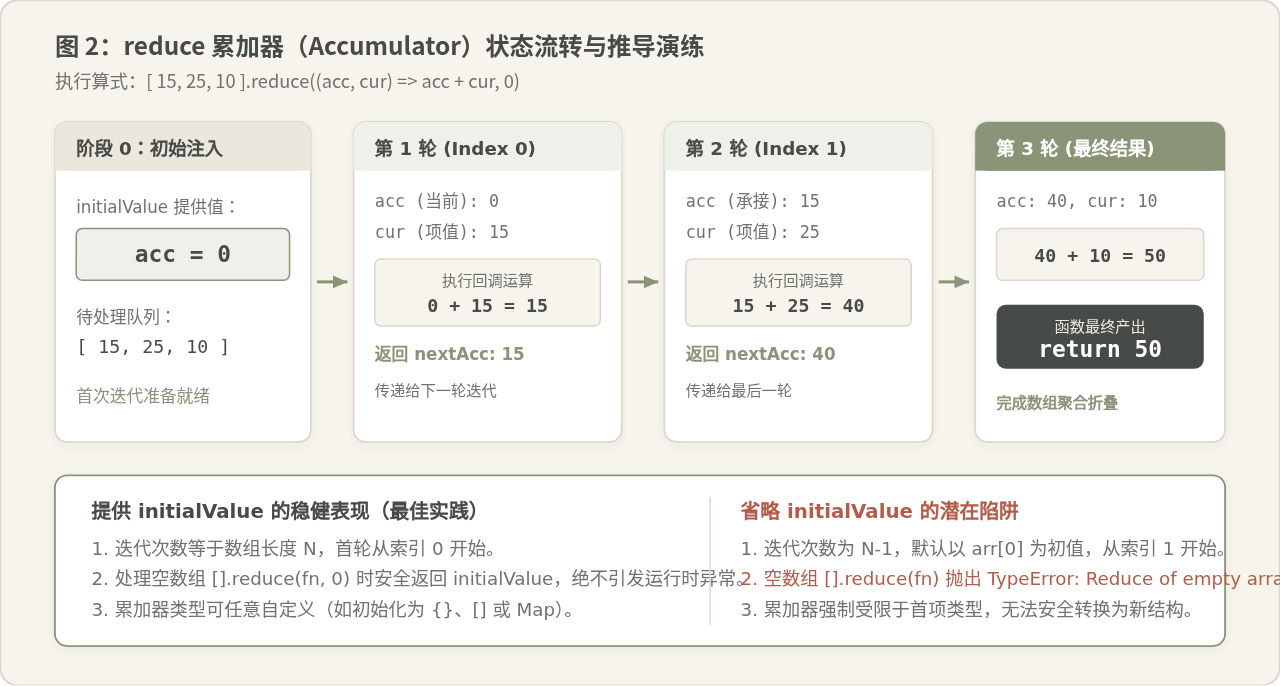
如果说 map 和 filter 是专门用途的锋利手术刀,那么 reduce 就是数组方法中的万能瑞士军刀。它的核心使命是“折叠聚合(Fold / Accumulation)”:沿着数组项依序流转一个累加器(Accumulator),将多项数据归纳折叠为单一目标结构(可以是数值、字符串、对象或嵌套列表)。
1. 完整语法与参数说明
const result = arr.reduce(function(accumulator, currentValue, currentIndex, array) {
  // 必须 return 下一次迭代所需的累加器状态
  return nextAccumulator;
}, initialValue);
参数解析:
accumulator(累加器):承载上一次回调执行的返回结果;在第一次迭代中,如果提供了initialValue,则为其初始值。currentValue:当前处理的数组元素。currentIndex:当前元素的索引。提供initialValue时首轮为 0,未提供时首轮为 1。array:调用reduce的源数组。initialValue(强烈推荐提供):作为累加器的初始注入值。
2. 为什么强烈建议始终显式传递 initialValue?
在很多示例中,初学者常看到不带初始值的简写,如 arr.reduce((a, b) => a + b)。这种写法在实际生产环境中潜藏极高风险:
- 空数组崩溃问题:如果一个空数组在没有传
initialValue的情况下执行reduce,JavaScript 引擎会立即抛出无法捕获的严重运行时错误:TypeError: Reduce of empty array with no initial value。而如果传入了0或[],则安全返回初始值。 - 初始类型受限:若省略初始值,
accumulator的初始值将被强制锁定为数组的第 0 项。如果你想把一个对象数组折叠为一个数值总和或一个汇总对象,省略初始值会导致第一轮计算产生非预期的类型拼接错误(如"[object Object]10")。
3. 典型使用场景与代码示例
场景 A:数值汇总与求加权平均值
const scores = [85, 92, 78, 96];

const sum = scores.reduce((acc, score) => acc + score, 0);
const average = sum / scores.length;
// 示例输出: sum = 351, average = 87.75
场景 B:统计集合中元素或属性出现的频次(Histogram)
const feedbackTags = ["响应快", "设计美观", "响应快", "功能丰富", "响应快", "功能丰富"];

const tagCounts = feedbackTags.reduce((acc, tag) => {
  acc[tag] = (acc[tag] || 0) + 1;
  return acc;
}, {});

// 示例输出: { "响应快": 3, "设计美观": 1, "功能丰富": 2 }
场景 C:将对象数组转换为字典映射(Key-Value Map)
在前端缓存或高频查找场景下,把 $O(N)$ 遍历查找的数组重组为 $O(1)$ 查找的字典对象极其常用:
const employees = [
  { empId: "E01", name: "王经理", dept: "研发部" },
  { empId: "E02", name: "李工", dept: "测试部" },
  { empId: "E03", name: "刘总监", dept: "运维部" }
];

const employeeMap = employees.reduce((acc, emp) => {
  acc[emp.empId] = emp;
  return acc;
}, {});

// 示例输出:
// {
//   "E01": { empId: "E01", name: "王经理", dept: "研发部" },
//   "E02": { empId: "E02", name: "李工", dept: "测试部" },
//   "E03": { empId: "E03", name: "刘总监", dept: "运维部" }
// }在很多追求代码“简短好看”的代码段中,常有人写出类似语句:
// 危险写法:时间复杂度骤升至 O(N²)
arr.reduce((acc, cur) => ({ ...acc, [cur.id]: cur }), {});
每次迭代执行 { ...acc },都会在内存中把此前所有键值对全量浅拷贝一遍。当数组有 10000 项时,拷贝次数高达数千万次,直接导致页面冻结。
正确方案:对于 reduce 的累加器内部局部对象,直接就地修改属性并返回即可(acc[cur.id] = cur; return acc;),时间复杂度稳定为线性 $O(N)$。
五、组合链式调用流水线与性能权衡
在复杂的业务逻辑中,单一方法往往难以独立完成整个数据流转。由于 filter 和 map 均返回标准的新数组实例,我们可以将它们组合成一条声明式数据处理管道。
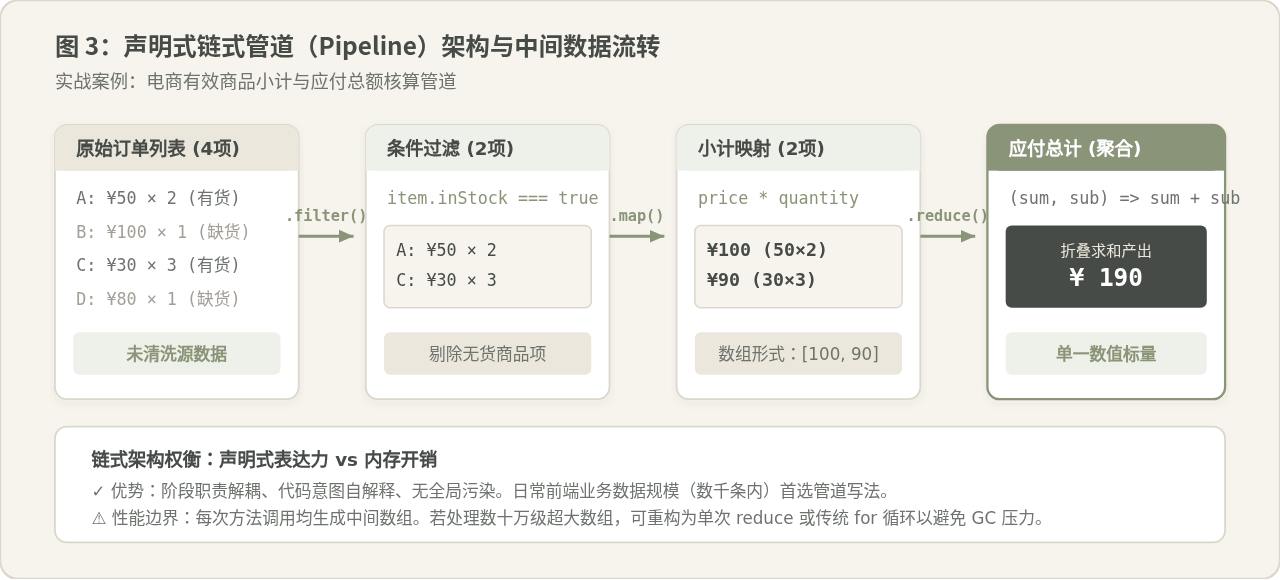
以下为一个典型电商订单结算计算管道:
const cartItems = [
  { title: "有机苹果", price: 25, count: 2, inStock: true },
  { title: "进口车厘子", price: 120, count: 1, inStock: false },
  { title: "高山绿茶", price: 80, count: 2, inStock: true },
  { title: "速冻水饺", price: 30, count: 3, inStock: true }
];

// 声明式链式处理管道:过滤无货 -> 计算每项金额 -> 累加总计
const finalPayAmount = cartItems
  .filter(item => item.inStock)                         // 步骤 1:筛选有效库存
  .map(item => item.price * item.count)                  // 步骤 2:投影各行小计
  .reduce((total, subtotal) => total + subtotal, 0);      // 步骤 3:折叠汇总总额

// 示例输出: 25*2 + 80*2 + 30*3 = 50 + 160 + 90 = 300
性能权衡:链式调用与单次遍历的选型依据
有观点认为:“链式调用每次都会生成中间临时数组并增加遍历次数,因此不如单次循环好。”这种说法看似有理,但需要区分数据规模来客观对待:
- 日常前端与业务逻辑(数组规模在数千条内):现代 V8 等 JavaScript 引擎对短生命周期的小对象垃圾回收(Scavenge)极其高效。链式调用带来的业务意图解耦、代码可读性与易维护性远比微秒级的时间差异重要,推荐坚持使用链式管道。
- 海量数据或动画核心循环(数组规模达数十万级别):多次生成大型中间数组确实会引发显著的内存占用并触发新生代 GC 停顿。此时可重构为单个
reduce或直接使用最基础的for...of循环,仅进行一次单趟线性扫描。
六、三大方法核心维度对比与选型决策指南
为了在日常编码中快速做出准确的技术选型,可以通过下方决策树梳理输入需求,并参考维度对比表快速定位。
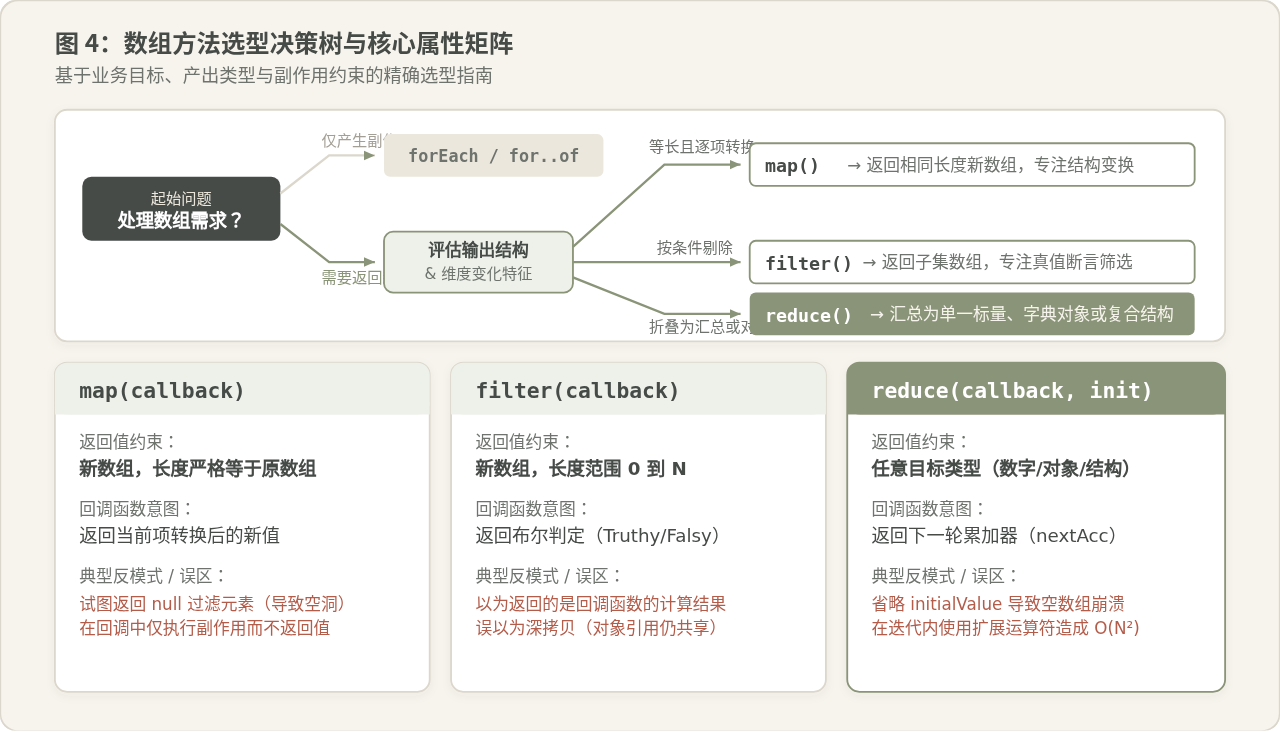
| 核心维度 | Array.prototype.map | Array.prototype.filter | Array.prototype.reduce |
|---|---|---|---|
| 输出结构 | 新数组(长度严格等于原数组) | 新数组(长度 0 ≤ M ≤ N) | 任意类型(数值、对象、数组、Map等) |
| 回调核心目的 | 返回当前项经过映射转换后的新值 | 返回判定条件(通过 Truthy 决定存留) | 返回合并当前项后的下一轮累加器值 |
| 是否改变原数组 | 否(遵循不可变性) | 否(遵循不可变性) | 否(遵循不可变性) |
| 原元素复用情况 | 全新构建,除非显式返回原引用 | 浅拷贝原元素引用(不新建内部对象) | 按需吸收组装到累加器中 |
| 典型应用场景 | 接口模型格式化、单位换算、视图标签渲染 | 剔除空值、关键词检索、按状态过滤 | 汇总求和、聚合聚类(GroupBy)、键值索引化 |
| 高频避坑要点 | 切勿在 map 中只做副作用;注意多参数函数陷阱 | 切勿认为过滤时已深拷贝内部复杂对象 | 务必提供初始值;严禁在循环内展开大对象 |
熟练掌握 map、filter 和 reduce 的行为边界与数学模型,不仅能消除冗长晦涩的临时循环索引变量,更能够构建出逻辑直观、纯粹无副作用、易于单元测试的专业 JavaScript 代码。
JavaScript防止死循环的最佳实践:超时保护与异步替代
2026-11-20 23:53:45
JavaScript Math对象内置函数常用场景
2026-11-20 23:27:56
怎么判断JavaScript代码中的this指向?
2026-11-20 22:49:48
JavaScript class类声明是否存在变量提升
2026-11-20 19:22:37
JS数组初始化的三种常用写法及区别
2026-11-20 18:23:34







