

JavaScript全局内置函数(parseInt,isNaN等)解析
深入解析 JavaScript 顶层全局内置函数的核心运作机制、执行流程、边界条件与工程避坑指南,全面剖析 parseInt、parseFloat、isNaN、isFinite、URI 编解码函数及 eval 的实际使用准则与替代策略。
window 或现代运行时的 globalThis)中直接暴露的一组核心方法。开发者无需通过命名空间或创建对象实例即可直接调用。本文系统剖析数值解析函数(parseInt、parseFloat)、数值校验函数(isNaN、isFinite)、网络 URI 编解码函数以及动态执行函数 eval 的底层运转机制、隐式类型转换陷阱与现代工程替代方案,帮助读者在实际业务中精准选型与安全编码。
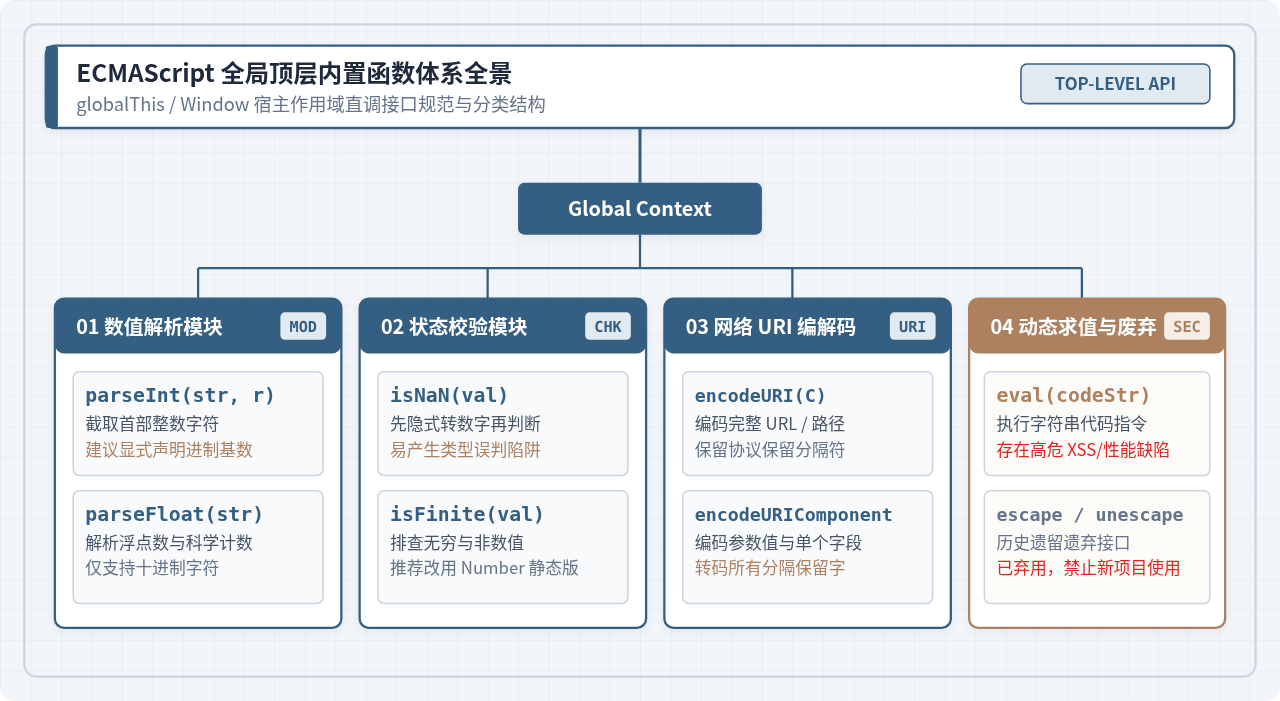
一、JavaScript 全局内置函数的定义与作用域归属
在 ECMAScript 规范中,全局内置函数直接挂载在“全局对象”(Global Object)的原型或属性列表中。在浏览器环境中,全局对象表现为 window;在 Node.js 中表现为 global;而在 ES2020 统一标准之后,统一通过 globalThis 访问。
正因为它们处于作用域链的最顶层,所以在脚本的任何位置均可直接调用,例如直接书写 parseInt("10") 而不需要前缀 Math. 或 Number.。但需要明确的是,这组函数诞生于 JavaScript 早期,部分函数内部设计了宽松的隐式类型转换机制,在现代复杂前端工程中若不了解其底层细节,极易引发难以排查的逻辑缺陷。
二、数值解析函数:parseInt 与 parseFloat 机制详解
数值解析函数的主要职责是从字符串中提取可用的数值,常用于解析带有 CSS 单位的像素值、表单输入文本或混合字符数据。
1. parseInt(string, radix) 的执行机制与基数陷阱
parseInt 接收两个参数:待解析字符串 string 与进制基数 radix(介于 2 至 36 之间)。其内部状态机遵循严格的顺序执行:
- 首部去空与类型转换:若输入参数不是字符串,先隐式执行
ToString(string),随后剔除字符串前端的所有连续空白字符。 - 正负号判定:检查紧随其后的首个非空字符。若是
+或-,记录符号位并将指针后移一位。 - 基数推导规则:若未显式传递
radix(或传入0、undefined),当字符串以"0x"或"0X"开头时推导为 16 进制;在 ECMAScript 5 及之后的标准中,其余常规字符串一律默认为 10 进制(历史版本中以0开头可能被推断为 8 进制,现已彻底废除)。 - 逐字符贪婪扫描与截断:从左至右逐个读取字符。若该字符在当前基数下属于合规数位(例如 10 进制下为
0-9,16 进制下为0-9及a-f/A-F),则继续读取;一旦遇到第一个不合规字符(如小数点、字母或空格),立即终止扫描,将已扫描到的字符序列折算为十进制整数返回。 - 无有效数位回退:若首个有效字符就无法在当前基数下被解析,直接返回
NaN。
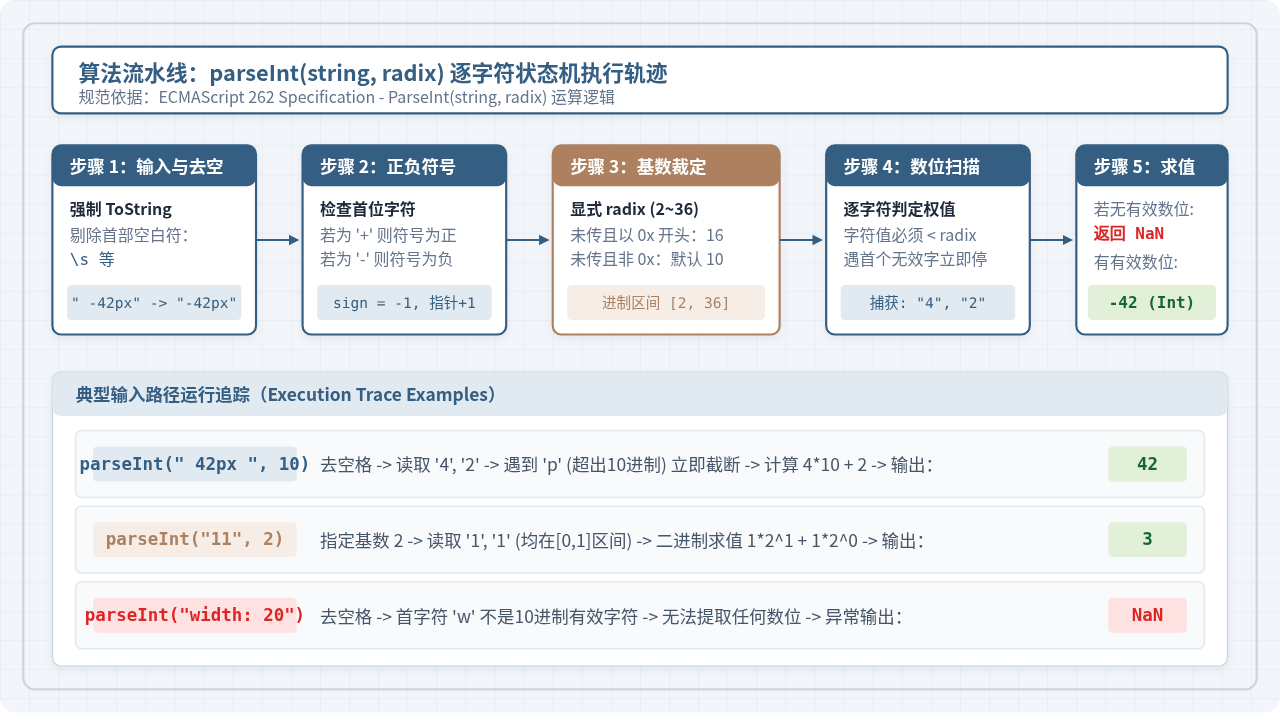
以下代码清晰演示了 parseInt 的截断特性与返回边界:
// 1. 遇到非数字字符立即截断并返回前半部分
parseInt("42px", 10);       // 示例输出: 42
parseInt("  -108.95元", 10); // 示例输出: -108 (遇小数点截断,不四舍五入)

// 2. 首字符即非法,直接返回 NaN
parseInt("width: 100px", 10); // 示例输出: NaN

// 3. 指定不同进制的计算结果
parseInt("11", 2);          // 示例输出: 3 (二进制 1*2 + 1)
parseInt("11", 16);         // 示例输出: 17 (十六进制 1*16 + 1)
parseInt("0x1A"); // 示例输出: 26 (自动推断为 16 进制)很多初学者写出
['1', '7', '11'].map(parseInt),本意是将字符串数组转为数字,但实际得到的是 [1, NaN, 3]。原因在于
Array.prototype.map 向回调函数传递三个参数 (element, index, array)。这导致 parseInt 分别接收到了数组索引作为第二个参数 radix:
parseInt('1', 0):基数为 0 时推断为 10 进制,返回1。parseInt('7', 1):基数为 1,超出 [2, 36] 合法区间,直接返回NaN。parseInt('11', 2):按二进制解析"11",返回3。
list.map(item => parseInt(item, 10)) 或直接使用构造器 list.map(Number)。
2. parseFloat(string) 的解析边界与差异
parseFloat 用于从字符串中提取浮点数。与 parseInt 相比,它的工作模式有以下两个本质区别:
- 不支持 radix 参数:
parseFloat只按十进制规则解析,无法识别十六进制或二进制前缀。如果传入"0x1F",它在读完0后遇到x判定为非法字符,直接返回0。 - 支持小数点与科学计数法:字符串中允许存在一个小数点,同时支持大小写指数表示法
e或E(例如"3.14e-2"将被正确解析为0.0314)。
parseFloat("3.14159rem");    // 示例输出: 3.14159
parseFloat("6.022e23 atoms"); // 示例输出: 6.022e+23
parseFloat("0x1F");           // 示例输出: 0 (遇到 x 截断)
parseFloat("  .85");          // 示例输出: 0.85 (省略前导0合法)
三、状态校验函数:isNaN 与 isFinite 的陷阱与现代演进
在 JavaScript 中,NaN(Not-a-Number)是一个特殊的数值类型,且规范定义 NaN !== NaN,因此无法通过恒等运算符 === 直接判断一个变量是否是 NaN。为此语言早期提供了全局校验函数,但由于历史包袱,它们带有强大的隐式类型转换。
1. 全局 isNaN(value) 的隐式转换缺陷
全局 isNaN(value) 的内部逻辑分为两步:第一步调用抽象操作 ToNumber(value) 强制将入参转为数字;第二步检查转换结果是否为 NaN。这就导致大量非数字类型的普通值被判定为 true:
// 隐式转换引发的反直觉结果
isNaN("hello world"); // true (因为 Number("hello world") 转换失败得到 NaN)
isNaN(undefined);     // true (因为 Number(undefined) 结果为 NaN)
isNaN({});            // true (对象转数字得到 NaN)
isNaN("");            // false (空字符串隐式转为数字 0)
isNaN(false);         // false (布尔值 false 隐式转为 0)
在业务逻辑中,如果编写 if (isNaN(data)) 来校验用户输入是否为空或未定义,就会因为隐式转换产生严重的业务判断偏差。
2. ES6 严格模式:Number.isNaN(value)
为了彻底解决此问题,ECMAScript 2015(ES6)在 Number 构造器上新增了静态方法 Number.isNaN()。它不执行任何类型转换,只有当且仅当传入的值本身就是 Number 类型且其值为 NaN 时才返回 true。
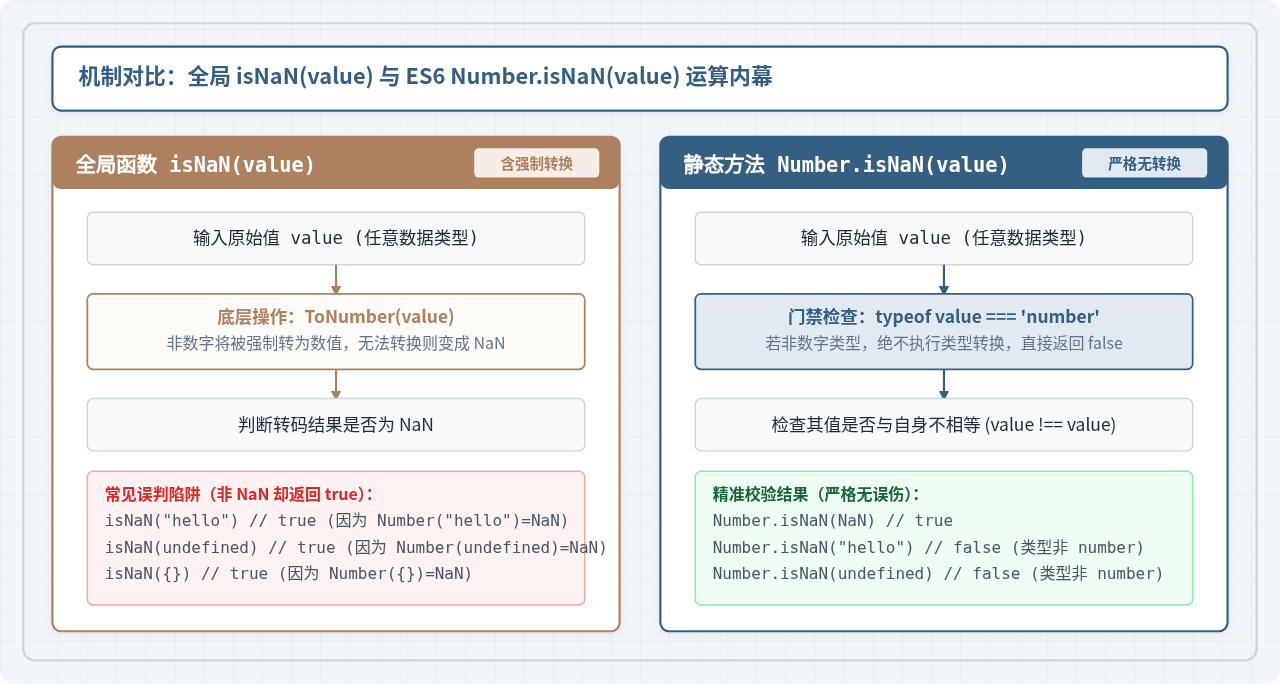
两者的对照关系如表 1 所示:
| 测试输入参数 | 全局 isNaN(val) | Number.isNaN(val) | 判定原因差异说明 |
|---|---|---|---|
NaN |
true |
true |
数值本身就是 NaN,两者一致 |
"123" |
false |
false |
转数字为 123 不是 NaN / 严格类型不为 number |
"abc" |
true (易误判) | false (精准) | 全局方法将其强转为 NaN;Number.isNaN 判定其为 string 直接返回 false |
undefined |
true (易误判) | false (精准) | Number(undefined) 为 NaN;严格方法直接过滤非数值 |
null |
false |
false |
Number(null) 为 0 不是 NaN / 严格类型不为 number |
3. isFinite 与 Number.isFinite 的异同
isFinite(value) 用于校验一个值是否属于有限数值。在 JavaScript 中,Infinity、-Infinity 和 NaN 均属于“非有限数”。
与 isNaN 类似,全局的 isFinite(value) 也会执行 ToNumber 强制类型转换,例如 isFinite("200") 会返回 true,isFinite(null) 也会返回 true(因为 Number(null) === 0)。而 ES6 引入的 Number.isFinite() 严禁隐式转换,只有真正的有限数字才会返回 true。现代工程代码中,推荐优先选用 Number.isFinite()。
四、网络 URI 编解码函数:encodeURI 与 encodeURIComponent
Web 开发中常需要在前端拼接带有参数的 URL 发起请求,或者从地址栏中解析参数。全局提供了两对对称的 URI 编解码函数:encodeURI / decodeURI 与 encodeURIComponent / decodeURIComponent。
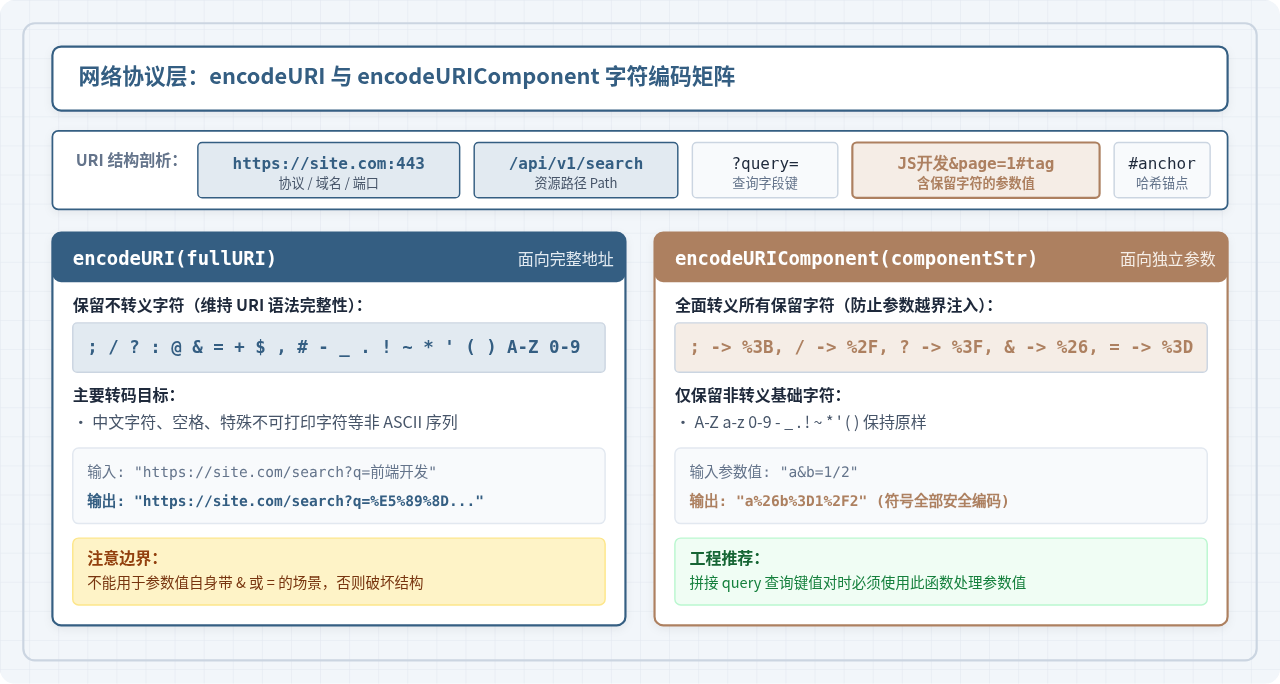
1. encodeURI 与 encodeURIComponent 的作用域界定
很多开发者混淆这两者的核心原因在于没有区分“完整 URI”与“URI 组成部分(Component)”的语意差异:
- encodeURI(uriString):用于编码一个完整的 URL。为了保证编码后的字符串仍然是一个可以被网络协议合法解析的 URL,它不会对 URI 中的保留分隔符进行转义。保留字符包括:
; , / ? : @ & = + $ #。它仅对中文字符、空格、特殊未保留字符进行百分号十六进制编码。 - encodeURIComponent(componentString):用于编码 URI 的某个组成片段(通常是 query 查询参数的值)。如果参数值内部包含了
&、=、/等字符,若不转义,浏览器会将它们误判为新的参数或路径层级。因此,它会转义所有保留分隔符,将其编码为%26、%3D、%2F等。
通过下方代码可以清晰看出二者编码结果的差别:
const rawParam = "vue&react=good/fast";

// 1. 使用 encodeURI(保留符号未转义,拼入 URL 会破坏参数键值结构)
const wrongUrl = "https://api.com/search?keyword=" + encodeURI(rawParam);
// 结果: "https://api.com/search?keyword=vue&react=good/fast"
// 后端会将 react 误判为一个独立的查询参数!

// 2. 使用 encodeURIComponent(符号均被安全转义)
const safeUrl = "https://api.com/search?keyword=" + encodeURIComponent(rawParam);
// 结果: "https://api.com/search?keyword=vue%26react%3Dgood%2Ffast"
// 后端能完整还原出原始字符串 "vue&react=good/fast"
2. 逆向解码与 URIError 异常防御
与编码相对应,decodeURI 与 decodeURIComponent 分别用于反向解码。在处理外部传入或用户手输的 URL 时,必须注意防御畸形编码:如果待解码字符串中含有不合法的百分号转义序列(例如结尾处存在单个无法配对的 "%" 或非法十六进制位 "%ZZ"),解码函数会直接抛出 URIError: malformed URI sequence 运行时异常。
function safeDecodeParam(encodedStr) {
  try {
    return decodeURIComponent(encodedStr);
  } catch (err) {
    // 捕获畸形 URI 序列异常,避免页面崩溃
    console.warn("解码参数失败,回退原始值:", err.message);
    return encodedStr;
  }
}
五、代码执行与废弃函数:eval 与 escape 风险剖析
1. eval(codeString) 的运行机理与安全性能禁忌
eval 接收一段包含 JavaScript 代码的字符串,并同步将其交给底层 JS 引擎进行解析与执行。虽然其能力强大,但在现代工程规范中被明确列为严禁滥用的高危函数:
- XSS 代码注入隐患:如果
eval执行的内容包含不可信的用户输入或第三方数据,攻击者可直接构造恶意代码窃取 Cookie、敏感 Token 或操纵 DOM。 - 破坏引擎编译优化:现代 V8 等 JavaScript 引擎依赖静态词法作用域做内联缓存(Inline Cache)和即时编译(JIT)优化。直接调用
eval会在运行时动态注入变量,导致引擎不得不禁用针对该作用域的作用域查找加速与变量逃逸分析,导致整体性能急剧下滑。 - 替代方案:
- 若需求是解析 JSON 字符串,必须使用
JSON.parse(),它具备专用的词法分析器,既安全又高效。 - 若确实需要动态计算数学表达式,可使用受限的表达式解析库或通过
new Function("a", "b", "return a + b")将动态代码隔离在局部函数作用域中,降低作用域污染。
- 若需求是解析 JSON 字符串,必须使用
2. 历史废弃函数提示:escape 与 unescape
escape() 与 unescape() 是早期的字符编码函数。它们对非 ASCII 字符采用 %uXXXX 的 UTF-16 格式编码,不符合标准的网络传输协议(RFC 3986 规定 URI 必须使用 UTF-8 百分号编码)。ECMAScript 规范早将其移至 Annex B(废弃兼容附录),官方标准明确要求禁止在现代项目中使用 escape 和 unescape,其所有功能均由 encodeURIComponent 和 decodeURIComponent 完全取代。
六、全局内置函数工程选型与最佳实践总结
为了在实际开发中写出健壮、清晰且无安全隐患的代码,针对不同业务诉求,推荐遵循下述选型决策路径:
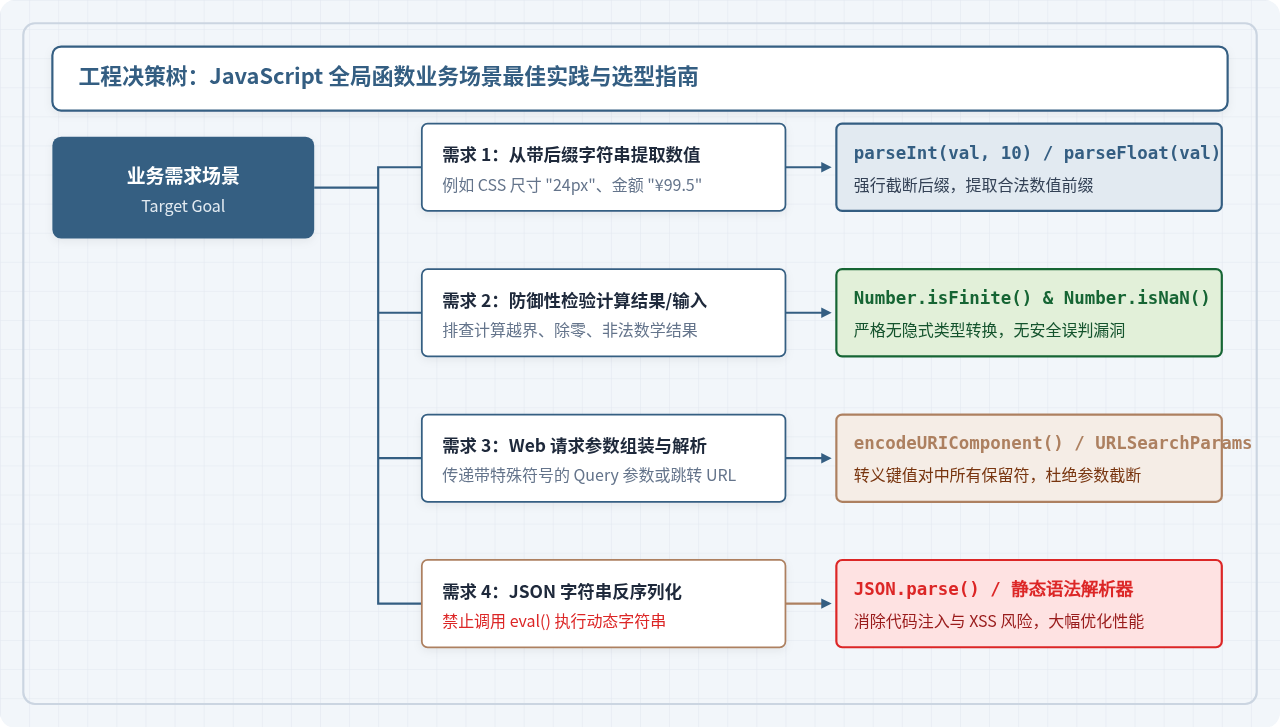
- 提取带有单位的数字:优先选用
parseInt(str, 10)(必须显式传入基数 10,避免进制误判)或parseFloat(str)。 - 严格转换纯数值:如果字符串必须完全是合规数字(例如身份证号、纯数字验证码),不要使用
parseInt,而应使用Number(str)或一元加号+str,因为它们一旦包含字母就会严谨地产生NaN,不会被截断吞掉。 - 数值合法性校验:全面弃用全局
isNaN()与isFinite(),统一迁移至 ES6 的Number.isNaN()与Number.isFinite(),阻断因隐式类型转换导致的误判漏洞。 - URL 参数组装与解析:拼接 Query 参数值时统一调用
encodeURIComponent,或者在现代浏览器中直接使用URLSearchParamsAPI;解码时必须包裹try...catch规避URIError。 - 动态数据解析:坚决杜绝
eval(),所有结构化数据解析统一使用JSON.parse()。
SheetJS (xlsx) 基础教程:JS 实现数据导出 Excel
2026-11-21 09:19:44
jsPDF与pdfmake对比:前端生成PDF该选哪个库
2026-11-20 23:34:35
JS遍历含Emoji字符串乱码怎么办?
2026-11-20 23:22:48
JS数组简单倒序与sort降序排列有什么区别?
2026-11-20 21:17:36
JavaScript函数定义实例:声明式、表达式与箭头函数的代码对比
2026-11-20 19:08:47







