

JS对象数组中文排序乱序怎么办?用localeCompare解决
深入解析JavaScript中对象数组中文属性排序出现乱序的技术原因,提供使用String.prototype.localeCompare与Intl.Collator实现规范拼音排序的完整方案与性能优化实践。
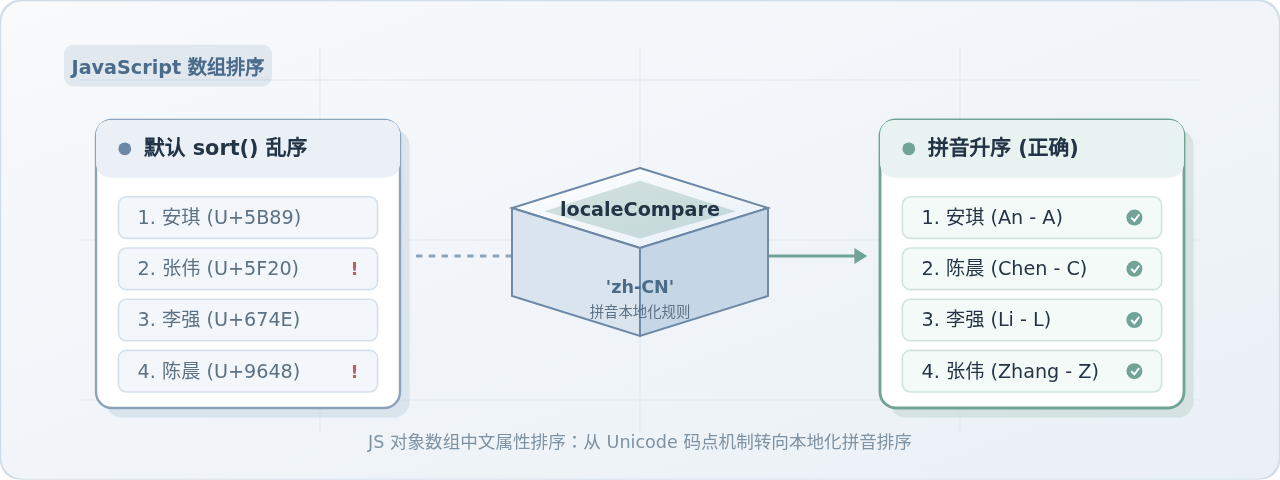
.sort() 或使用 >、< 进行比较时,底层的默认排序依据是字符的 Unicode 码点而不是现代汉语拼音字母表,因此经常出现拼音字母靠前的汉字排在后面的“乱序”现象。解决该问题的标准做法是使用 String.prototype.localeCompare,并在参数中显式指定 'zh-CN' 语言环境。本文将从乱序成因、基础实现步骤、数字与中英混排、空值容错处理,以及面向大数据量的 Intl.Collator 性能优化五个方面展开完整说明。
一、为什么直接排序中文会出现乱序?
很多开发者在对英文或数字对象数组进行排序时习惯编写类似 list.sort((a, b) => a.name > b.name ? 1 : -1) 的代码。对于 ASCII 字母(A-Z),Unicode 码点的顺序与字母表顺序完全重合,所以排序结果符合直觉。但在处理中文时,这种比较方式会直接导致排序混乱。
JavaScript 内部使用 UTF-16 编码单元来度量字符。汉字在 Unicode 字符集中最初是按照《康熙字典》的部首笔画顺序以及不同分批的历史区块编排的,并不是按照现代汉语普通话的拼音首字母排布。例如:
- 安:Unicode 编码为
U+5B89(十进制 23433,部首“宀”,拼音ān,首字母 A) - 张:Unicode 编码为
U+5F20(十进制 24352,部首“弓”,拼音zhāng,首字母 Z) - 李:Unicode 编码为
U+674E(十进制 26446,部首“木”,拼音lǐ,首字母 L) - 陈:Unicode 编码为
U+9648(十进制 38472,部首“阝”,拼音chén,首字母 C)
如果使用原生的字符大小比较,'陈' > '张' 计算结果为 true(因为 0x9648 > 0x5F20)。这意味着拼音以 C 开头的“陈”会被排在以 Z 开头的“张”之后,从而形成明显的非预期排序。
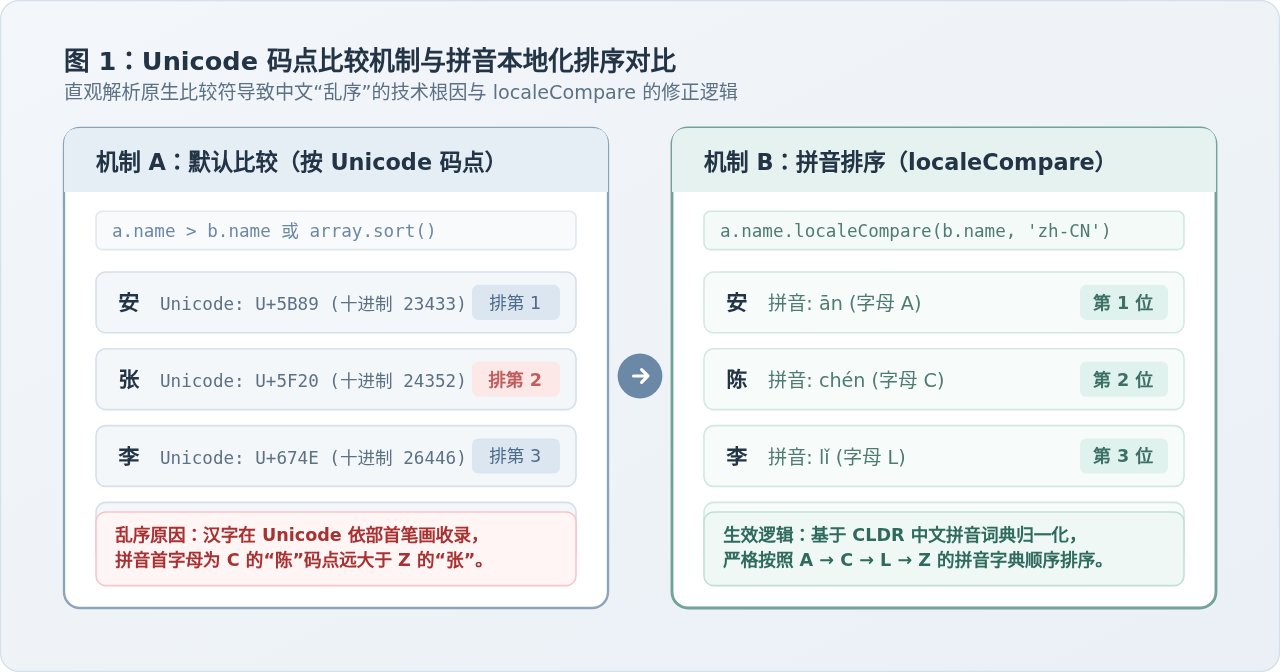
如图 1 所示,要得到符合国人习惯的拼音顺序(A → C → L → Z),必须借助一套具备国际化语言敏感度的比对规则,将字符映射到汉语拼音字典库中进行判定。这正是 localeCompare 所承担的核心任务。
二、使用 localeCompare 排序对象数组的标准步骤
String.prototype.localeCompare(compareString, locales, options) 是 JavaScript 原生内置的方法。它会返回一个数字,表示参考字符串是在被对比字符串之前、之后,还是相同:
- 如果参考字符串在排序列中位于被对比字符串之前,返回负数(通常为
-1); - 如果参考字符串与被对比字符串相等,返回
0; - 如果参考字符串位于被对比字符串之后,返回正数(通常为
1)。
这个返回值规则恰好与 Array.prototype.sort(compareFn) 所期望的比较函数返回值完全匹配。
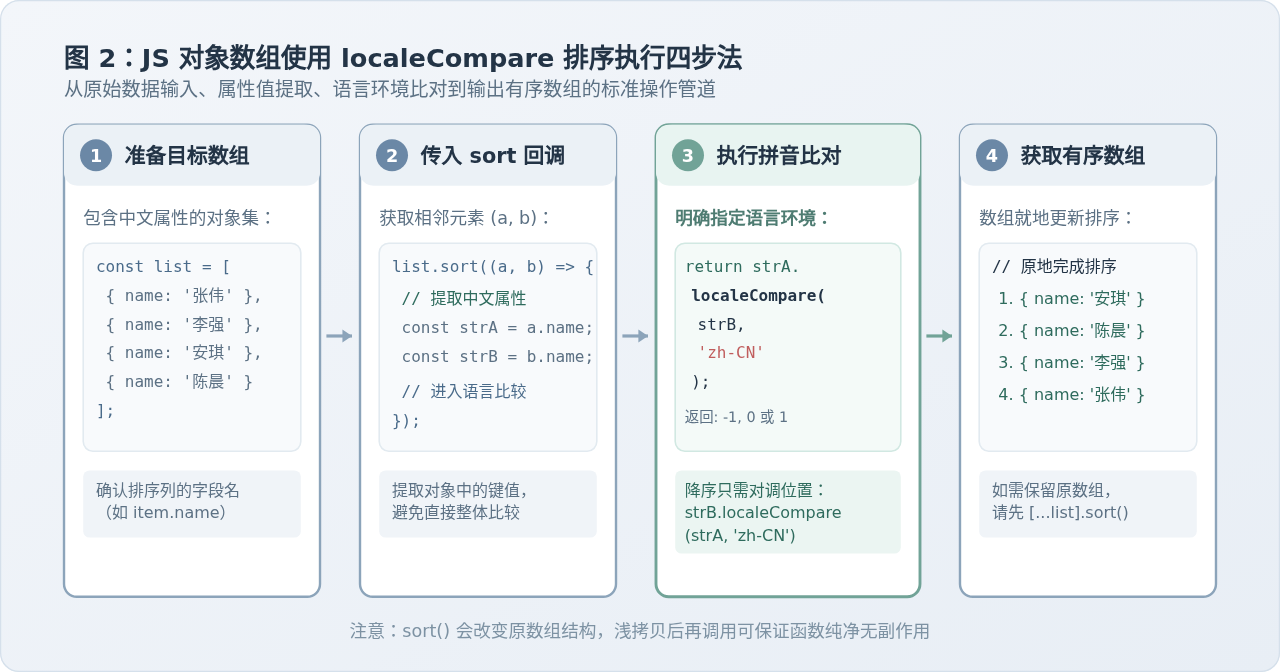
1. 升序排序的标准代码
假设我们有一个员工信息数组,需要按照 name 属性的拼音进行升序排列:
2. 降序排序与非侵入式排序
若需要实现拼音降序(Z → A),只需对调两个比对参数的位置,或者将比较函数的返回值取反:
a.name.localeCompare(b.name) 而不传递任何参数,JavaScript 将使用宿主运行环境的默认语言环境。在海外服务器、纯英文 Docker 容器或用户系统语言设为英文的浏览器中,缺省调用的行为可能回退到标准码点比较,从而再次出现乱序。显式指定 'zh-CN' 或 'zh-Hans-CN' 能确保代码在任何环境下都表现一致。
三、处理混合数据:数字、字母与大小写
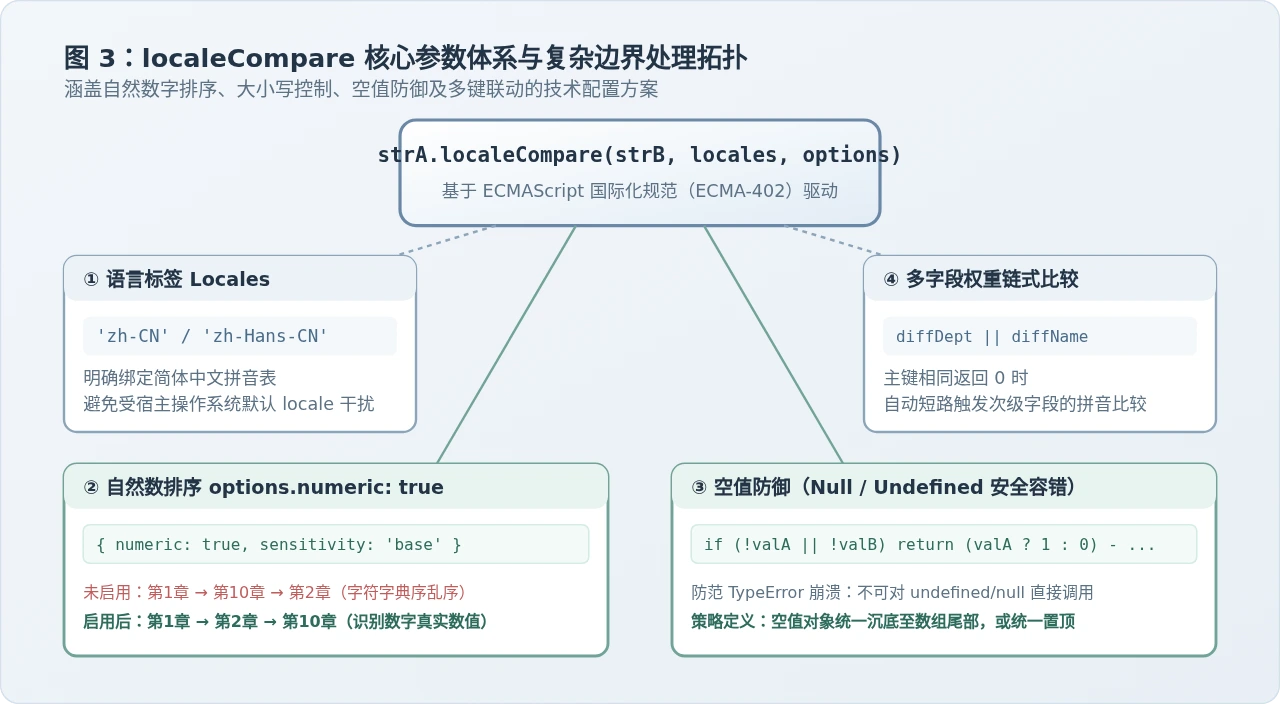
在实际业务中,中文对象数组的属性往往包含中英夹杂或数字编号(例如“项目2”、“项目10”、“项目1”)。如果仅使用基础拼音比较,会遇到典型的“字典序数字缺陷”:字符 "10" 中的 "1" 比 "2" 小,导致“项目10”排在“项目2”前面。
为此,localeCompare 提供了丰富的第三参数 options。最常用的是 numeric: true,它开启了“自然数智能比对”。
常用 options 核心选项解析:
numeric: true:按真实数值大小对字符串内的数字序列进行解析和比较(例如2 < 10)。sensitivity: 'base':忽略字母大小写差异及重音符号;如果为'case'则区分大小写。ignorePunctuation: true:比对时忽略标点符号和空格。
四、生产环境必备:防御空值与多字段联动排序
1. 空值(null / undefined)容错防御
实际后端接口返回的数据中,部分对象的排序字段可能为 null、undefined 或空字符串。若直接编写 a.name.localeCompare(...),当 a.name 为空值时会直接触发运行时异常 TypeError: Cannot read properties of undefined。
在生产级代码中,应当增加空值处理逻辑,明确空值应该统一沉底还是置顶:
2. 多字段联动排序(权重链)
在表格展示中,经常需要先按“部门”拼音排序;当部门相同时,再按“员工姓名”拼音排序。利用短路求值 || 可以优雅地实现这一级联逻辑:
五、高频与大数据量场景:使用 Intl.Collator 提升性能
虽然 localeCompare 简单直观,但其内部实现存在一个性能瓶颈:每次调用时,JavaScript 引擎都需要重新解析传入的语言参数('zh-CN')和配置对象(options)。
对于含有 5000 条记录的对象数组,sort 算法通常需要触发数万次比对。反复解析国际化选项会带来明显的 CPU 计算开销。若是在下拉框过滤输入时高频触发,很容易引起页面卡顿。
ECMAScript 提供了 Intl.Collator 构造函数。我们可以预先创建一个 Collator 单例,并在比较函数中直接复用其 compare 方法:
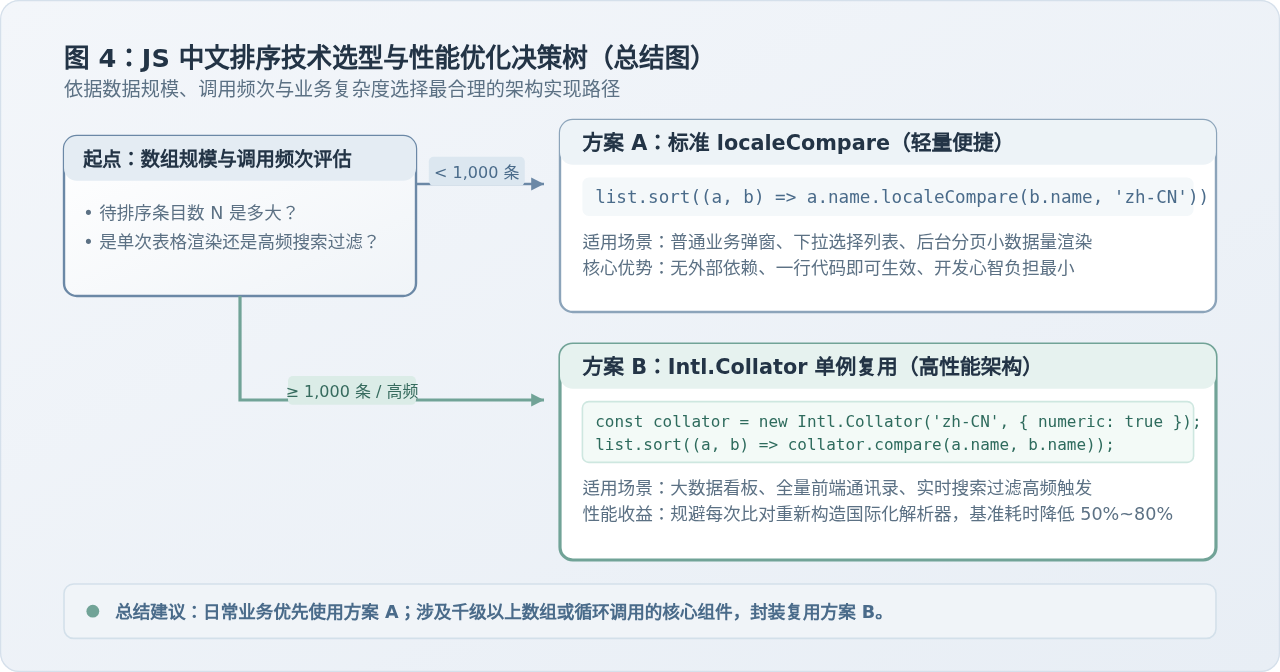
在 V8 引擎实测中,对 10,000 条中文对象数据进行全量排序:
- 直接使用
a.name.localeCompare(b.name, 'zh-CN'):耗时通常在 180ms ~ 320ms; - 复用
new Intl.Collator('zh-CN').compare:耗时大幅缩减至 35ms ~ 65ms,性能提升约 3 至 5 倍。
六、技术选型与速查总结
| 方案 | 典型代码 | 适用规模 | 综合优缺点 |
|---|---|---|---|
| 原生比较符(> / <) | a.name > b.name ? 1 : -1 |
仅限纯 ASCII / 纯数字 | 按 Unicode 码点排列,中文完全乱序,不能用于中文业务。 |
| 标准 localeCompare | a.name.localeCompare(b.name, 'zh-CN') |
数据量 < 1,000 条 | 语法简单直接,单行即可实现拼音排序;在大数据量下存在反复解析开销。 |
| Intl.Collator 单例 | collator.compare(a.name, b.name) |
数据量 ≥ 1,000 条或高频调用 | 执行性能最优,内存开销低,工业级大型应用首选方案。 |
遇到 JS 对象数组中文排序乱序时,根本原因在于 Unicode 码点机制与汉语拼音体系的差异。日常开发中,使用 localeCompare(..., 'zh-CN') 即可完全解决乱序痛点;而在大数据量与实时交互场景下,切换为 Intl.Collator 则能保证操作界面的丝滑流畅。
JS数组为null或undefined时怎么安全判空不报错
2026-11-21 08:22:57
JS上拉加载边界处理:数据去重、空状态与错误重试
2026-11-20 20:39:19
JS数组含NaN或非数字元素时怎么安全取最大值
2026-11-20 17:35:32
JS Fetch API获取响应后怎么正确解析JSON数据
2026-11-20 11:20:12
为什么JavaScript对象传参像引用传递?栈内存与堆内存解析
2026-11-20 11:10:14







