JavaScript数组sort()默认按字符串排序的陷阱与修正
深入解析JavaScript中Array.prototype.sort()方法默认将元素转换为字符串按UTF-16码元排序的底层机制与经典陷阱,并提供比较函数、数值排序、多语言排序及现代不可变排序的完整修正方案。
在 JavaScript 中对数组调用 sort() 方法时,如果不传入任何比较函数,引擎并不会按照数值大小进行排序,而是先将所有数组元素强制转换为字符串,再按照字符的 UTF-16 码元顺序升序排列。这种默认行为常常导致类似 [10, 2, 5].sort() 输出为 [10, 2, 5] 的经典逻辑错误。要正确解决这一问题,核心方案是为 sort() 传递显式的比较函数 (a, b) => a - b,并在涉及不可变数据流与本地化多语言时选用更稳妥的工程化写法。
一、现象与陷阱:为什么默认 sort() 会把数字排错?
在编写 JavaScript 代码时,对一组数字进行排序是非常基础的操作。初学者通常会写出如下代码:
const numbers = [10, 2, 5, 1, 20];
numbers.sort();

console.log(numbers);
// 预期结果: [1, 2, 5, 10, 20]
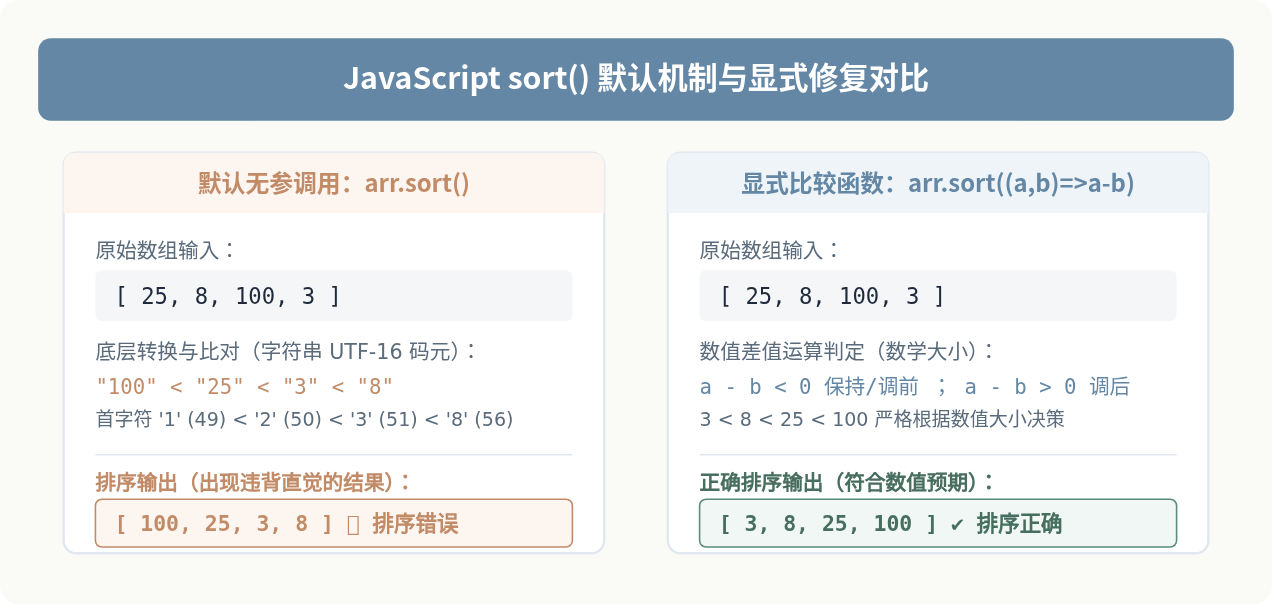
// 实际输出: [1, 10, 2, 20, 5]从输出结果可以看到,10 被排在了 2 的前面,20 也被排在 5 的前面。这种行为不仅出现在正整数中,在处理浮点数或负数时同样会产生混乱,例如 [10.5, 2.1, 100, 3].sort() 输出为 [10.5, 100, 2.1, 3]。
这种现象并非 JavaScript 运行环境的 Bug,而是 ECMAScript 规范明确规定的标准行为:当 Array.prototype.sort(compareFn) 没有提供参数 compareFn 时,其默认比较机制会将待比较的元素通过内置抽象操作 ToString() 转换为字符串,随后逐字符根据 UTF-16 码元(Code Unit)的数值大小决定先后次序。
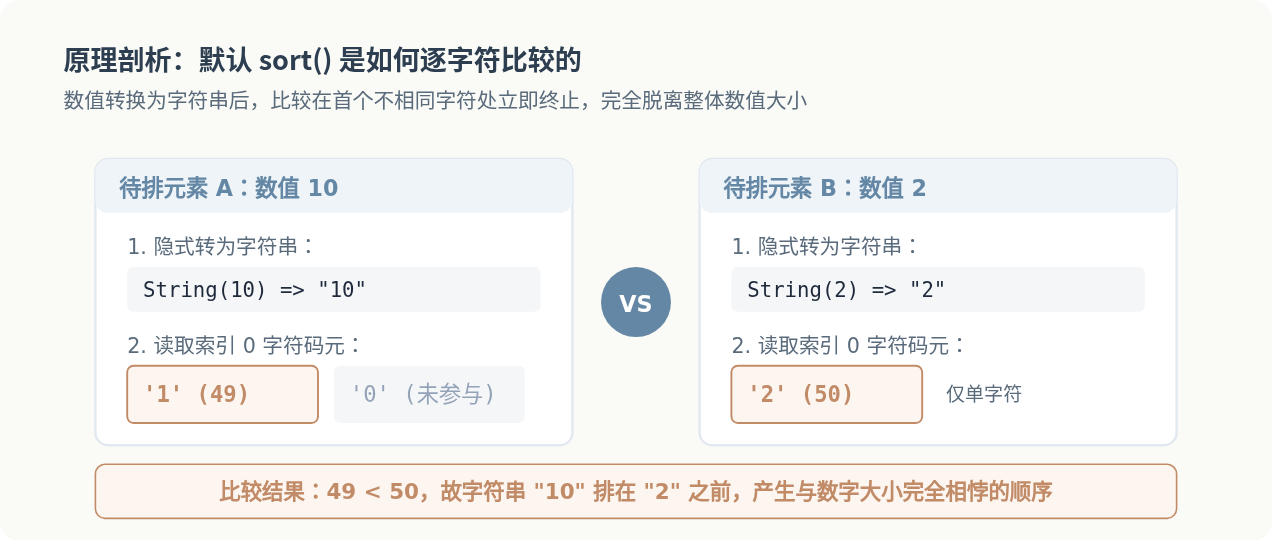
如图 1 所示,字符 '1' 对应的 UTF-16 编码值为 49,而字符 '2' 的编码值为 50。由于比较操作在发现第一个字符不同时就得出了 49 < 50 的结论,因此字符串 "10" 被直接判定为小于 "2"。后面的字符 '0' 根本没有机会影响比较结果。这就好比在字典中查找单词,“apple”必然排在“banana”之前,不论“apple”这个单词本身有多长。
二、核心机制:比较函数 compareFn 的运作规则
为了让数组按照真实的业务逻辑(例如数值大小、自定义属性等)排序,必须向 sort() 传递自定义的比较函数 compareFn(a, b)。
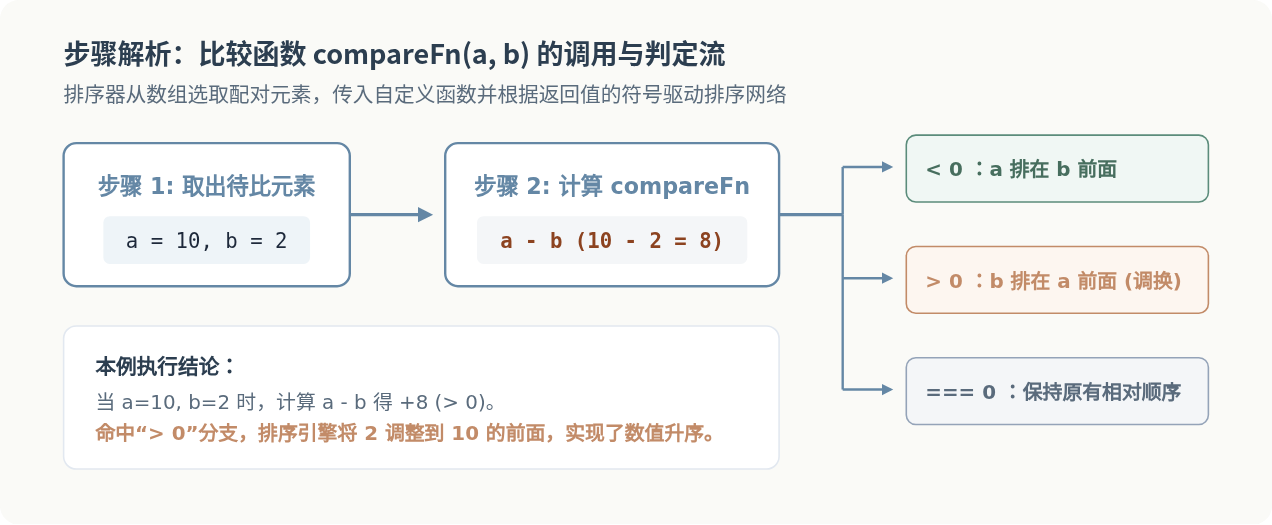
比较函数接收两个参数 a 和 b,分别代表数组中参与对比的两个相邻元素。排序算法会根据 compareFn(a, b) 的返回值正负,决定元素在最终序列中的相对顺序:
- 返回值小于 0(< 0):认为
a应该排在b之前(在升序排列中,意味着a比b小)。 - 返回值大于 0(> 0):认为
b应该排在a之前(交换两者的相对位置)。 - 返回值等于 0(=== 0):认为
a与b在排序权重上完全等价,保持原有相对顺序(ECMAScript 2019 起规范要求Array.prototype.sort必须具备稳定性 Stable Sort)。
三、常见场景与标准修正方案
明确了比较函数的运作逻辑后,在日常业务开发中,可以针对不同数据类型和结构,采用以下标准写法进行修正。
1. 基础数字数组排序:升序与降序
对于常规的有限数值数组,直接使用箭头函数返回两数差值是最简明、最常见的写法:
const scores = [25, 8, 100, 3, 42];

// 数值升序 (从小到大)
scores.sort((a, b) => a - b);
console.log(scores); // [3, 8, 25, 42, 100]

// 数值降序 (从大到小)
scores.sort((a, b) => b - a);
console.log(scores); // [100, 42, 25, 8, 3]a - b 是升序(如果 a < b,差为负,a 留/排在前面,即小的在前面);b - a 是降序(如果 b > a,差为正,b 排在前面,即大的在前面)。
2. 防御性排序:避免数值溢出与 NaN 陷阱
在绝大多数前端业务中,a - b 足够高效可靠。但在特定边界场景下,直接相减存在潜在隐患:
- 如果数组中混入了
NaN、undefined或无法转换为数字的对象,减法运算会返回NaN。在规范中,如果比较函数返回NaN,其排序结果是未定义的(可能会打乱顺序或产生不一致行为)。 - 如果数值跨度极大,达到极值的上下界(例如
Number.MAX_VALUE与-Number.MAX_VALUE相减),可能发生浮点溢出得到Infinity。
在需要极端严谨或处理不可控数据的底层工具库中,更稳妥的做法是使用明确的关系运算符进行比较:
function safeAscending(a, b) {
  if (a < b) return -1;
  if (a > b) return 1;
  return 0;
}

const rawData = [5, 2, 8, 1];
rawData.sort(safeAscending);
3. 对象数组按指定属性排序
实际开发中,表格列表或商品列表的数据多为对象数组。我们可以在比较函数中提取具体的属性值进行比对:
const userList = [
  { id: 101, name: "Alice", age: 28, score: 95 },
  { id: 102, name: "Bob",   age: 22, score: 95 },
  { id: 103, name: "Carol", age: 31, score: 88 }
];

// 单字段:按 age 升序
userList.sort((a, b) => a.age - b.age);

// 多字段联合排序:先按 score 降序;分数相同时,按 age 升序
userList.sort((a, b) => {
  const scoreDiff = b.score - a.score;
  if (scoreDiff !== 0) {
    return scoreDiff;
  }
  return a.age - b.age;
});
4. 字符串与中文拼音的本地化排序:localeCompare
虽然默认的 sort() 是按字符串处理的,但它遵循的是原始的 ASCII/Unicode 码表,这会导致:大写字母全排在小写字母前面(例如 'Z' < 'a'),而中文字符则按 Unicode 汉字内码排列,并非人们习惯的拼音字母表顺序。
对于字符串或中文字符的排序,应当借助 String.prototype.localeCompare():
const cities = ["北京", "上海", "广州", "深圳", "杭州"];

// 错误做法(默认字典码):可能出现与拼音不符的生硬排序
// cities.sort();

// 正确做法:显式指定 zh-Hans-CN 语言环境,按汉语拼音升序排列
cities.sort((a, b) => a.localeCompare(b, "zh-Hans-CN"));
console.log(cities);
// 输出: ["北京", "广州", "杭州", "上海", "深圳"] (B, G, H, S, S 拼音序)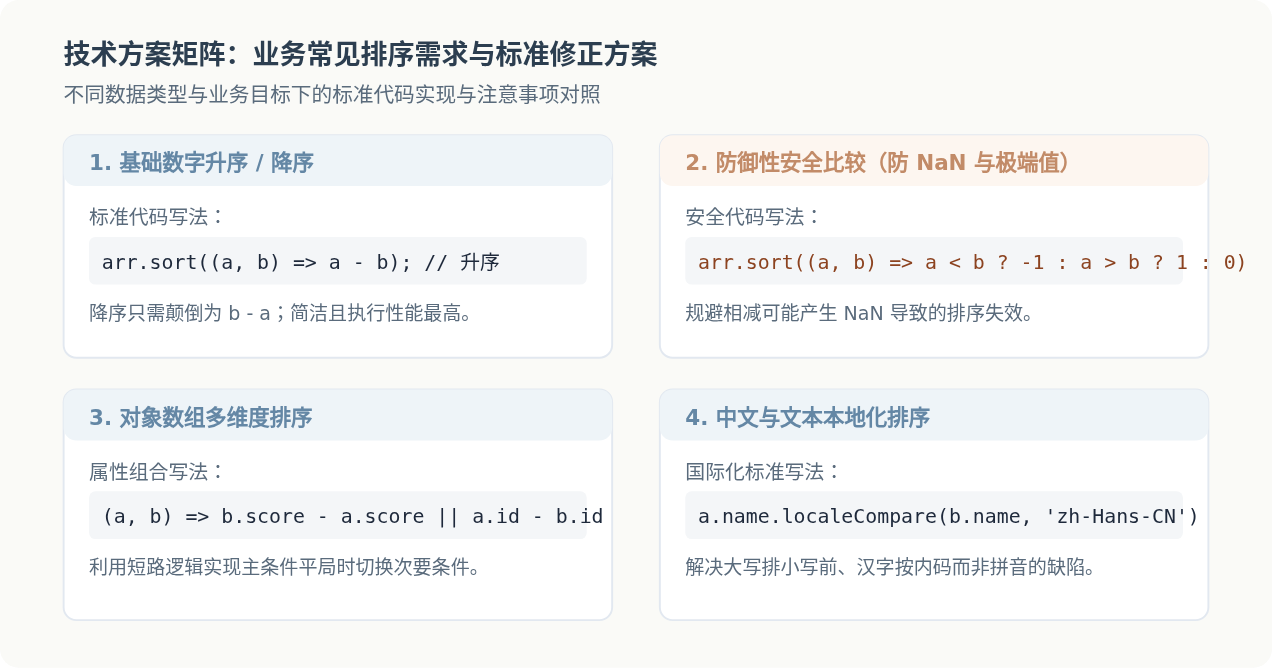
四、避坑注意事项:原地修改与现代替代方案
除了默认按字符串排序这一核心陷阱之外,Array.prototype.sort() 还有一个极其重要且容易引发 Bug 的设计特性:原地修改(In-place Mutation)。
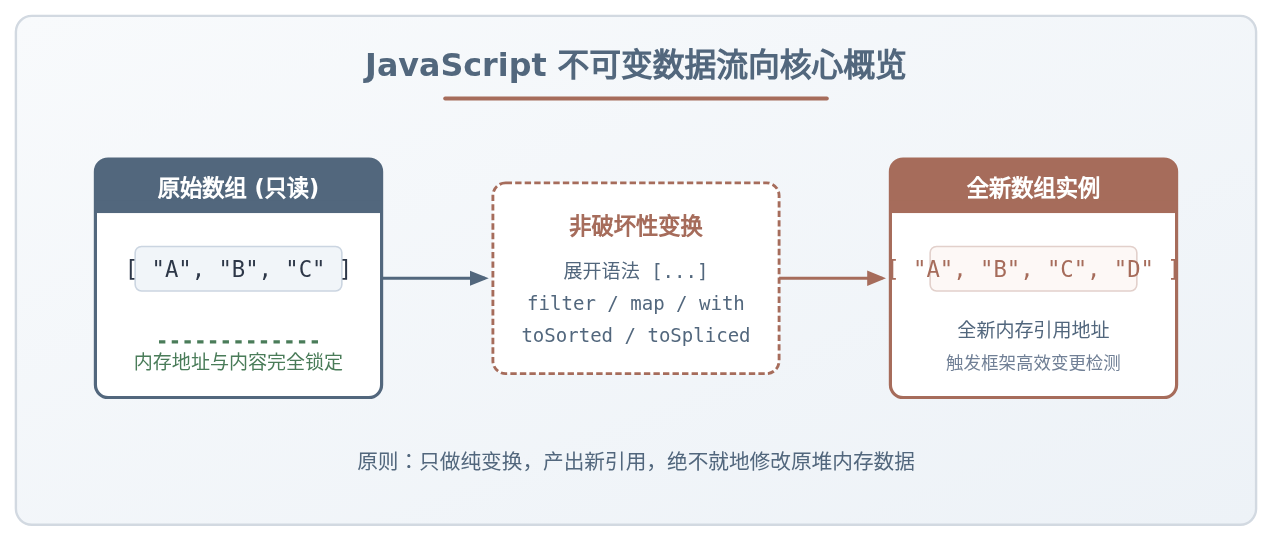
调用 arr.sort() 时,它直接修改原数组中的元素指针和顺序,同时返回对该原数组的同一引用。如果直接在 Vue、React 的响应式状态或 Redux Store 等状态管理器中对原始 Props/State 进行排序,就会造成不可预测的状态突变(State Mutation),进而引发页面不重新渲染、数据追踪混乱或历史回退失效等疑难问题。
sort()。必须先克隆副本,或直接使用现代 ES2023 提供的非破坏性 API。
1. 现代化方案:使用 ES2023 的 toSorted()
ECMAScript 2023 引入了专门的非破坏性排序方法 Array.prototype.toSorted()。它与 sort() 接收完全一致的 compareFn 参数,区别在于它绝不修改原数组,而是返回一个全新的已排序数组:
const original = [20, 3, 50, 1];

// 现代写法 (Node.js 20+, 现代浏览器全面支持)
const sorted = original.toSorted((a, b) => a - b);

console.log(original); // [20, 3, 50, 1] (原数组完好无损)
console.log(sorted);   // [1, 3, 20, 50] (返回全新排好序的数组)
2. 兼容性方案:浅拷贝后再 sort()
若项目运行环境需要兼容较老的浏览器或旧版本 Node.js,可以使用展开运算符或 slice() 创建浅拷贝后再排序:
const originalList = [30, 2, 8];

// 方案 A: 展开运算符浅拷贝后排序
const safeListA = [...originalList].sort((a, b) => a - b);

// 方案 B: slice() 浅拷贝后排序
const safeListB = originalList.slice().sort((a, b) => a - b);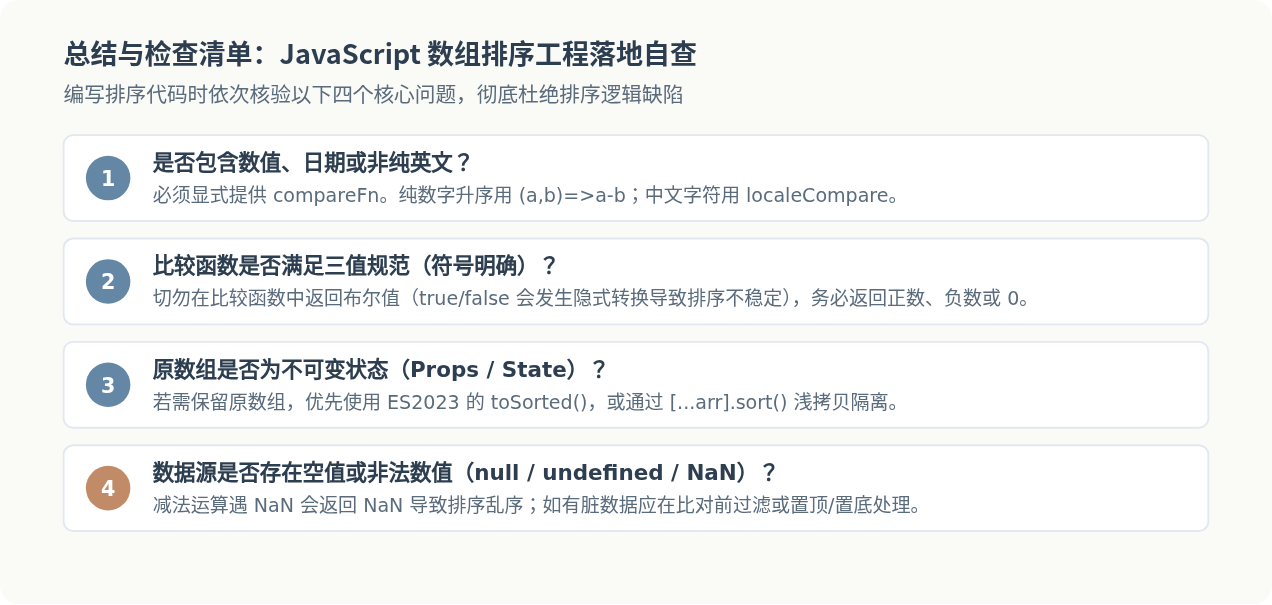
五、快速结论与核心回顾
| 使用场景 | 默认错误/潜在问题 | 推荐修正方案 |
|---|---|---|
| 普通纯数字升序 | [10, 2].sort() => [10, 2] |
arr.sort((a, b) => a - b) |
| 普通纯数字降序 | 无法通过无参实现 | arr.sort((a, b) => b - a) |
| 包含中文/多语言文本 | 按 Unicode 字符编码排列,非拼音 | arr.sort((a, b) => a.localeCompare(b, 'zh-Hans-CN')) |
| 不可变状态(React / Vue) | arr.sort() 原地篡改原数组触发异常 |
arr.toSorted((a, b) => a - b) 或 [...arr].sort(...) |
掌握 JavaScript 中 sort() 的底层行为,关键在于牢记“无参默认转字符串按字符序比较”这一底层规范。在编写任何涉及数字、对象属性或多语言文本的排序逻辑时,始终养成显式传入 compareFn 的编码习惯,并在现代框架中优先结合 toSorted() 保护数据原样,即可彻底规避这一经典陷阱。
JS添加数组元素时怎么不修改原数组
2026-11-18 23:47:34
JS数组末尾追加元素:push方法与展开运算符用法
2026-11-18 23:30:12
JS手动解析自定义格式日期字符串的方法
2026-11-18 22:59:25
从执行上下文看JS变量提升的底层原理
2026-11-18 22:00:22
JS怎么获取对象的不可枚举属性及Symbol属性
2026-11-18 21:01:38