

怎么用JS正则实现“必须包含”某类字符的密码校验?
在JavaScript中实现“必须包含某类字符”密码校验的核心在于使用正向肯定预查(Positive Lookahead)。本文深度解析零宽断言原理、分步推导组装完整密码正则,并对比单一大正则与规则拆分函数在不同场景下的优劣与安全实践。
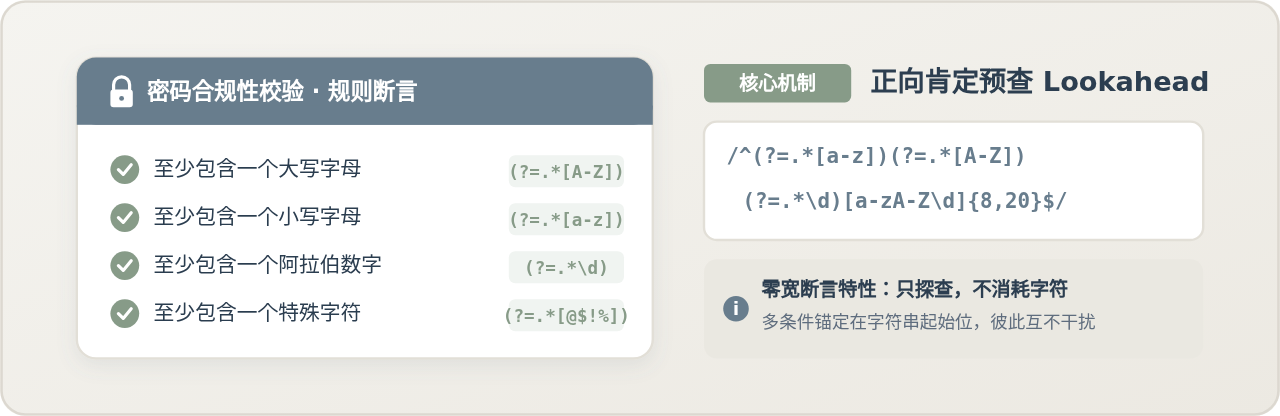
(?=...))。普通正则在匹配字符时会顺序消耗字符,强制要求字符出现的前后顺序;而正向预查是一种零宽断言(Zero-width Assertion),它在不移动匹配指针的前提下向右探查目标字符是否存在。结合起始锚点 ^,开发者可以连续堆叠多个独立的预查条件(例如同时要求包含小写字母、大写字母、数字及特殊符号),从而在一次正则判定中无序且严密地完成多重复杂度校验。
一、核心机制:为什么普通正则难以胜任,必须使用正向预查?
许多初学者在尝试编写“密码必须同时包含字母和数字”的正则时,最容易写出类似 /^[a-zA-Z]+[0-9]+$/ 的表达式。这种写法的致命缺陷在于它强行规定了先后顺序:密码必须是字母在前、数字在后。一旦用户输入数字在前或字母数字穿插的密码(例如 9527abc 或 p9a8s7s),校验便会错误地判定为失败。
如果要用普通字符集列举所有排列组合,当规则扩展为“大写字母、小写字母、数字、特殊符号四选四”时,可能的出现次序高达 4 的阶乘(24 种顺序组合),正则表达式的体积将膨胀到完全不可维护。这就引出了正向预查的核心价值。
1. 零宽断言(Zero-width)与不消耗字符
正向肯定预查语法为 (?=pattern),属于零宽断言的一种。其工作机制可以概括为两点:
- 只探查、不占用:当引擎遇到
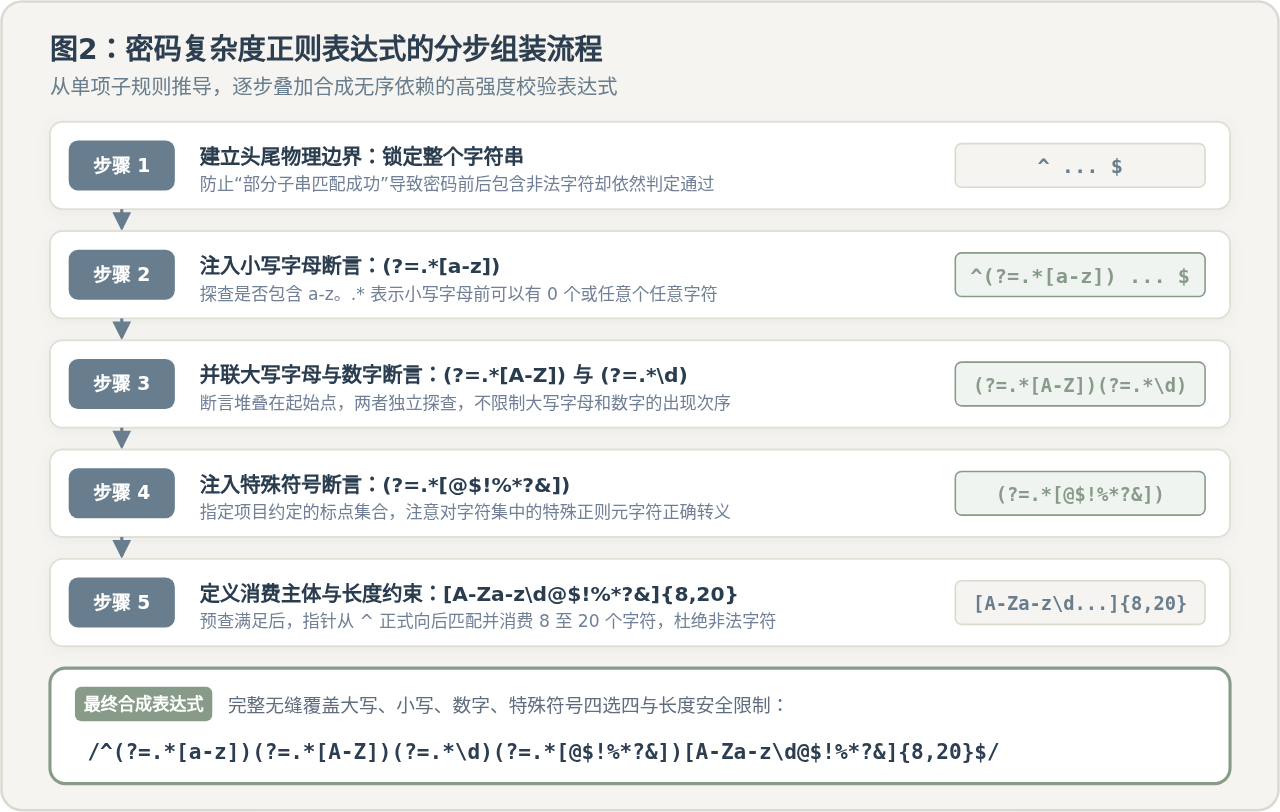
(?=.*[a-z])时,会从当前位置向后扫描整个字符串,寻找是否存在满足[a-z]的字符; - 指针归位:无论在哪个位置找到了目标字符,匹配成功后,引擎内部的匹配光标(Index Pointer)都会退回到断言开始前的位置,不消耗任何实际字符。
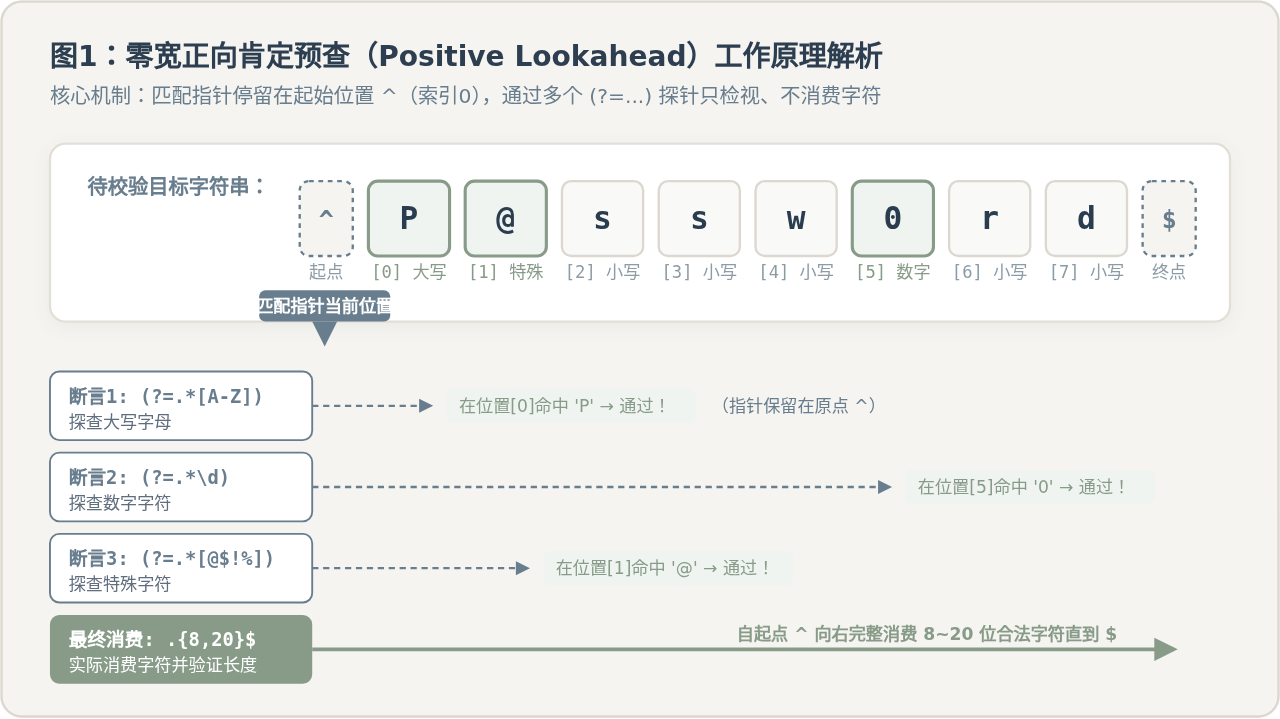
因为指针没有移动,我们就可以在同一个起点(通常是字符串开头 ^)紧接着挂载第二个、第三个乃至更多个 (?=...)。各个断言分别从起点向右探查,彼此独立、互不干扰,从而天然实现了“所有条件必须同时满足,且出现顺序完全任意”的逻辑效果。
二、分步构建:从单一条件到完整密码校验表达式
为了让正则表达式易于理解与调试,我们按照逻辑递进的方式逐步拼装。假设业务要求密码必须满足:长度为 8 到 20 位,且必须同时包含小写字母、大写字母、数字以及指定的特殊符号。
步骤 1:固定起始与结束锚点
密码校验必须是整串校验,遗漏头尾锚点会导致只匹配到合法局部,因此先写出骨架:
/^...$/步骤 2:添加“必须包含小写字母”断言
在起始锚点 ^ 后加入第一个预查探针:
/^(?=.*[a-z]).*$/这里的 .*[a-z] 含义为:在当前位置之后,允许跨过 0 个或任意个字符,但其后必须紧随至少一个小写英文字母。
步骤 3:并联大写字母与数字断言
由于上一步完成后指针依然停在 ^ 之后,我们可以直接在后面紧跟另外两个预查模块:
/^(?=.*[a-z])(?=.*[A-Z])(?=.*\d).*$/步骤 4:添加特殊符号断言
指定允许的常用特殊符号集合(例如 @$!%*?&):
/^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[@$!%*?&]).*$/步骤 5:替换末尾消费主体,限定白名单与长度
目前表达式末尾的 .*$ 会匹配任意字符且不限长度,这是不安全的。我们需要用明确的字符白名单与量词替代它,作为实际“消耗”字符的主体:
/^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[@$!%*?&])[A-Za-z\d@$!%*?&]{8,20}$/当四个 (?=...) 全部判定通过后,引擎的光标依然停在起始位置 ^;此时引擎开始执行末尾的 [A-Za-z\d@$!%*?&]{8,20}$,正式逐个消费字符并确保整串字符都在安全白名单内、总长度在 8 到 20 之间。
完整的 JavaScript 校验函数与测试用例
以下是将上述正则封装为标准 JS 校验函数的完整代码:
/**
 * 校验密码复杂度(大写、小写、数字、特殊符号各至少一个,长度 8~20 位)
 * @param {string} password - 待检测的密码
 * @returns {boolean} - 是否符合规则
 */
function validatePassword(password) {
  if (typeof password !== 'string') return false;

  // 单一大正则:集合了4个前瞻断言及长度约束
  const passwordRegex = /^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[@$!%*?&])[A-Za-z\d@$!%*?&]{8,20}$/;

  return passwordRegex.test(password);
}

// 示例运行测试
console.log(validatePassword("P@ssw0rd"));       // true  (包含大写P、特殊@、小写sswrd、数字0,长度8)
console.log(validatePassword("password123"));    // false (缺少大写字母和特殊字符)
console.log(validatePassword("PASSWORD@123"));   // false (缺少小写字母)
console.log(validatePassword("Pass@1"));         // false (长度不足8位)
console.log(validatePassword("Pass@123456789012345678")); // false (超过20位)
console.log(validatePassword("Pass@123 "));      // false (包含末尾非法空格)
三、对比剖析:单一大正则 vs 规则拆分函数
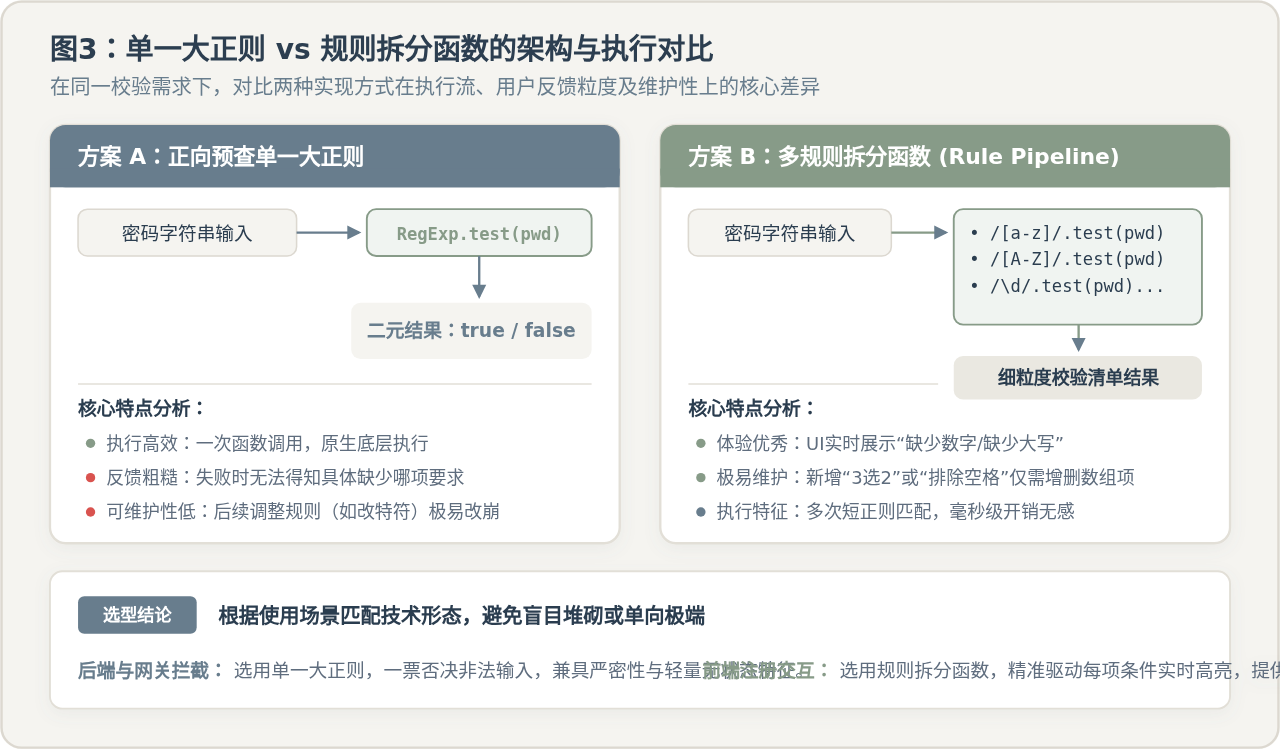
在实际生产环境中,除了使用单一大正则外,还有另一种极具代表性的方案:将每条校验要求拆分成独立的规则数组,通过 JavaScript 代码逻辑逐项校验。这两种做法在一致的业务要求下存在明显的定位差异。
1. 关键差异对比
为了帮助开发者根据业务阶段合理选型,我们将两种方案的关键维度归纳如下:
| 对比维度 | 方案 A:正向预查单一大正则 | 方案 B:多规则拆分函数 (Rule Pipeline) |
|---|---|---|
| 语法结构 | 一条复合正则表达式,高度紧凑 | 多个简单正则对象的数组或函数集合 |
| 错误反馈粒度 | 仅返回 true 或 false,无法定位具体哪项缺失 |
可精准返回“缺少大写字母”、“长度不足”等具体原因 |
| 前端 UI 契合度 | 难以驱动交互式“打勾提示清单” | 完美契合实时动态点亮合格要求的交互设计 |
| 扩展与维护成本 | 较高,增减条件或修改特殊字符容易引入语法错误 | 极低,直接增删数组项即可,无关联耦合风险 |
| 执行性能特征 | 底层原生单次执行,耗时极短,轻量无额外对象 | 多次短正则执行,毫秒级开销对用户完全无感 |
2. 规则拆分函数的完整实现示例
在面向终端用户的注册界面中,用户体验至关重要。规则拆分函数不仅能够得出整体校验结论,还能输出细粒度的未达标项列表:
/**
 * 细粒度密码规则校验器
 * @param {string} pwd
 * @returns {{ isValid: boolean, passed: string[], failed: string[] }}
 */
function checkPasswordDetail(pwd) {
  if (!pwd || typeof pwd !== 'string') {
    return { isValid: false, passed: [], failed: ['密码不能为空'] };
  }

  const rules = [
    { id: 'length', label: '长度必须在 8-20 位之间', check: s => s.length >= 8 && s.length <= 20 },
    { id: 'lowercase', label: '必须包含至少一个小写字母', check: s => /[a-z]/.test(s) },
    { id: 'uppercase', label: '必须包含至少一个大写字母', check: s => /[A-Z]/.test(s) },
    { id: 'number', label: '必须包含至少一个数字', check: s => /\d/.test(s) },
    { id: 'special', label: '必须包含至少一个特殊字符 (@$!%*?&)', check: s => /[@$!%*?&]/.test(s) },
    { id: 'allowedOnly', label: '不能包含未许可的非法字符', check: s => /^[A-Za-z\d@$!%*?&]+$/.test(s) }
  ];

  const passed = [];
  const failed = [];

  for (const rule of rules) {
    if (rule.check(pwd)) {
      passed.push(rule.label);
    } else {
      failed.push(rule.label);
    }
  }

  return {
    isValid: failed.length === 0,
    passed,
    failed
  };
}

// 示例运行输出
const result = checkPasswordDetail("Secure2026");
console.log(result.isValid); // false
console.log(result.failed);  // ["必须包含至少一个特殊字符 (@$!%*?&)"]
// 前端可直接利用 result.failed 数组将对应输入框下方的错误红字精准渲染出来!
四、常见陷阱与工程优化建议
在正则表达式的字符集合
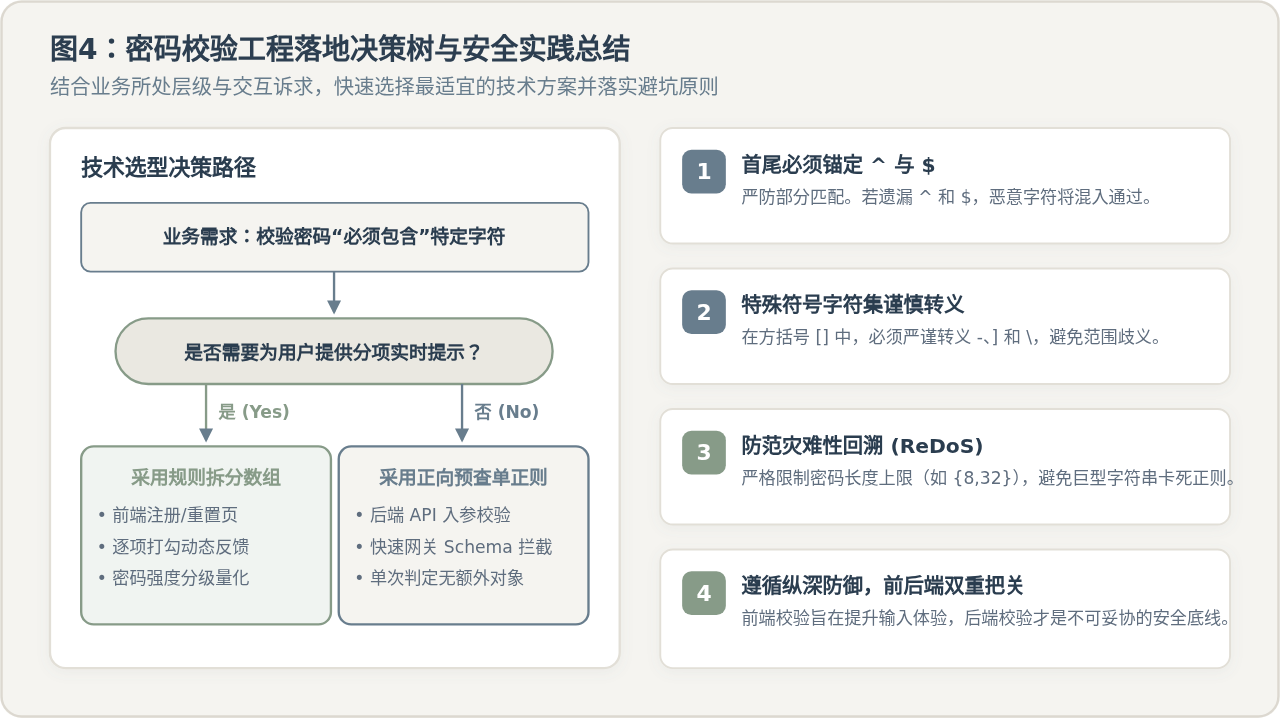
[...] 中,连字符 - 具有“范围连接”的特殊语义(例如 0-9)。如果你的特殊字符包含减号,务必将其放在首位、末位或进行转义(如 [\-_@$!] 或 [@$!\-]),否则会意外构成跨字符编码的区间匹配,导致不可预测的校验行为。
在极长字符串被恶意注入时,连续使用
(?=.*[a-z]) 中的 .* 可能会引发多次贪婪回溯。若追求极高吞吐量,可将其优化为“排除型字符集”:(?=[^a-z]*[a-z])。这明确告诉引擎:“跳过所有非小写字母,直接定位到第一个小写字母”,大幅缩短无效回溯路径。
3. 前后端双重门禁原则
前端的密码校验主要是为了给用户提供友好的实时提示,降低输入阻碍;但千万不要将前端校验视为绝对安全屏障。由于浏览器控制台可随时绕过 JavaScript,后端接口(Node.js / Go / Java)必须使用相同的强规则进行再次门禁验证,二者采用的特殊字符集定义必须保持严格一致。
五、总结与选型决策指南
要用 JavaScript 实现“必须包含某类字符”的密码校验,本质是解决无序条件的并发判定问题:
- 如果你是在编写后端 API 入参拦截器、微服务网关或自动化测试脚本,追求极致的简洁与单行判定,请使用
/^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)...$/的正向肯定预查单一大正则; - 如果你是在开发Web 客户端的注册与密码重置表单,需要向用户直观展示每个条件是否打勾达标,请果断使用规则拆分函数,以换取极佳的交互友好度与后期维护弹性。
JS离线地图数据准备:从QGIS导出到本地切片流程
2026-11-18 15:17:37
JS获取文件名但不包含扩展名的实现代码
2026-11-18 12:58:51
JS怎么打印对象的Symbol属性和不可枚举属性
2026-11-18 12:45:48
JavaScript默认参数对arguments对象的影响及避坑指南
2026-11-18 12:41:54
JavaScript匿名函数是什么?与命名函数的区别
2026-11-18 10:51:47







