

JS生成Excel中文乱码原因及BOM头修复方案
深入解析前端JavaScript导出CSV/Excel文件时中文出现乱码的底层原因,剖析Windows Excel的编码推断机制,并提供多种添加UTF-8 BOM头的完整解决方案、底层内存分析与避坑核验清单。
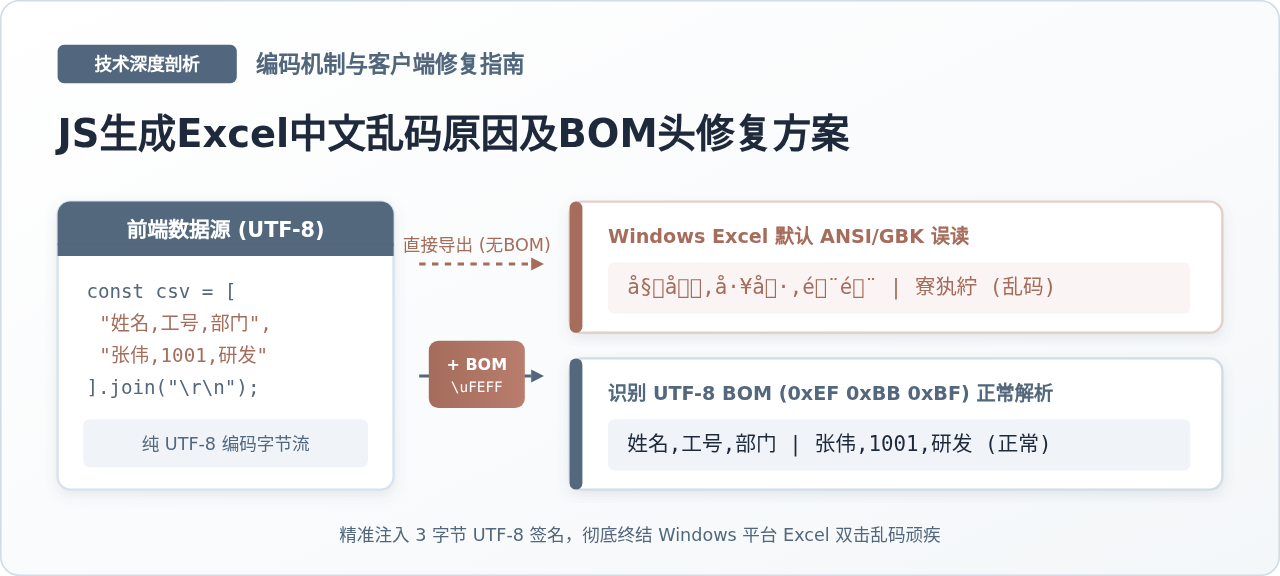
\uFEFF 或字节 0xEF, 0xBB, 0xBF),即可驱动 Excel 自动切换为 UTF-8 引擎正常显示中文。
一、Excel 中文乱码的底层机制解析
很多开发者初次遇到乱码时会产生困惑:导出的 CSV 文件若用 VS Code、Sublime Text 或 Windows 自带记事本打开,中文显示完全正常;唯独使用 Microsoft Excel 双击打开时发生乱码。这并非 JavaScript 导出的内容本身损坏,而是软件之间的编码判定策略差异所致。
现代文本编辑器通常具备“字符集概率探测算法”。当一个无签名文件被读入时,编辑器会快速扫描整个字节流。由于 UTF-8 编码具有严格的高位字节特征(例如标准汉字通常以 1110xxxx 10xxxxxx 10xxxxxx 格式连续排布),编辑器能以极高概率推断其为 UTF-8 并准确渲染。
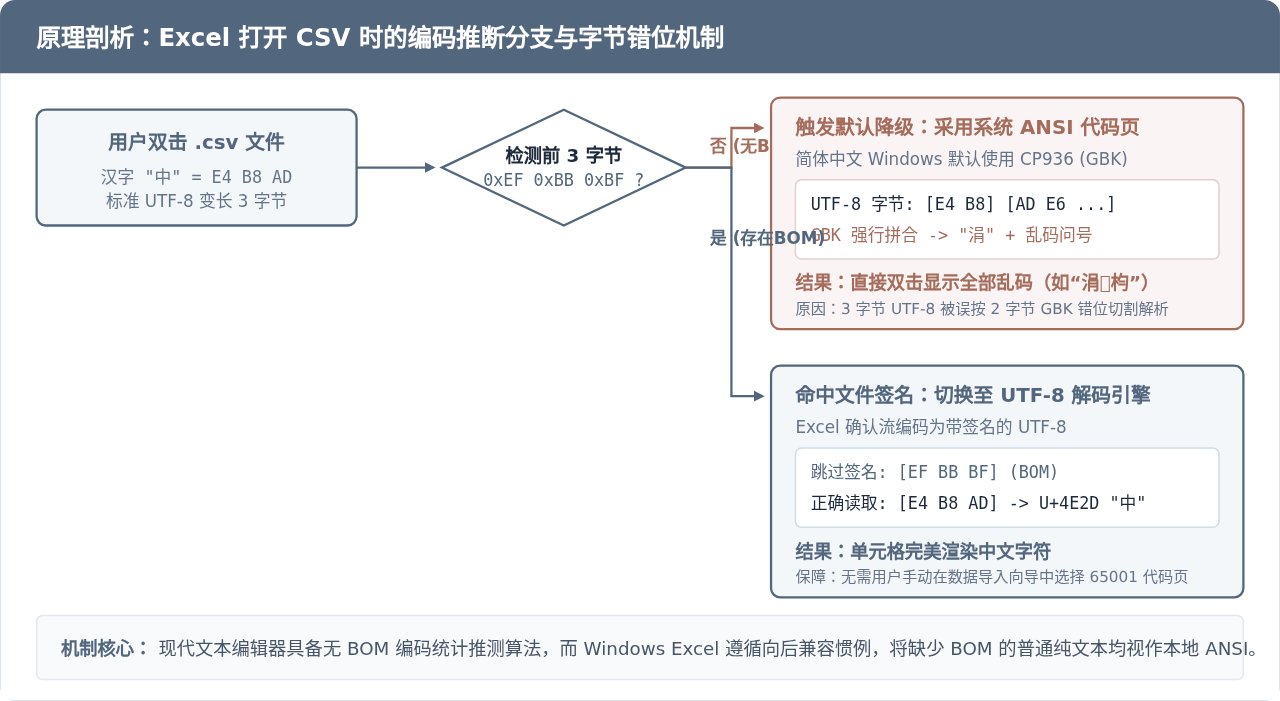
但 Microsoft Excel 在处理通过文件关联双击直接启动的 .csv 文本文件时,出于对历史版本的向后兼容考虑,执行的是一套刚性的编码决策链:
- 第一优先级(签名判定):检查文件开头前 3 个字节。若完全匹配十六进制
0xEF, 0xBB, 0xBF,立即判定该文件为标准 UTF-8 格式,自动启用 UTF-8 解码引擎。 - 第二优先级(默认降级):若文件开头未检测到该特定签名,Excel 不会对后续正文进行 UTF-8 启发式推测,而是直接降级使用当前 Windows 系统的默认 ANSI 代码页。
在中文简体版 Windows 操作系统中,系统默认的 ANSI 代码页是 CP936(兼容 GBK 编码)。GBK 采用双字节表示一个汉字,而 UTF-8 采用三字节表示一个常用汉字。
举例说明:汉字“中”在 UTF-8 下的字节序列为 E4 B8 AD。当 Excel 强行以 GBK 解析时,会贪婪抓取前两个字节 E4 B8,在 GBK 码表中查找对应的汉字,结果恰好映射为“涓”;剩余的单字节 AD 无法独立成字,只能与紧随其后的下一字符首字节强行拼合,从而造成整个文档后续所有文字发生“多米诺骨牌式”错位,产生诸如“涓枃”的典型乱码。
二、什么是 BOM 头及其在 UTF-8 中的作用
BOM 全称为 Byte Order Mark(字节顺序标记)。在 Unicode 早期设计中,UTF-16 和 UTF-32 编码存在大端序(Big-Endian)与小端序(Little-Endian)之分。为了让接收端明确读取顺序,规范规定在文件最开头放置一个特殊的 Unicode 字符 U+FEFF(零宽不换行空格,Zero Width No-Break Space)。根据该字符存储时的字节序列,解析器即可获知大小端方向。
而 UTF-8 规范是以单字节为基本单位进行传输的变长编码,其字节排布顺序在物理上是唯一确定的,在网络传输与 Linux/POSIX 系统中本来并不需要也不推荐 BOM。但在 Windows 生态中,微软将 U+FEFF 在 UTF-8 下编码后的 3 个字节——0xEF, 0xBB, 0xBF——作为识别该文本属于 UTF-8 文件的“魔法标记”(Magic Number)。
因此,给前端生成的 CSV 数据加上这 3 个字节的“BOM 头”,本质上是为 Windows Excel 提供明确的元数据标识,迫使其绕过本地 GBK 默认代码页。
三、JavaScript 注入 BOM 头的四步实现全流程
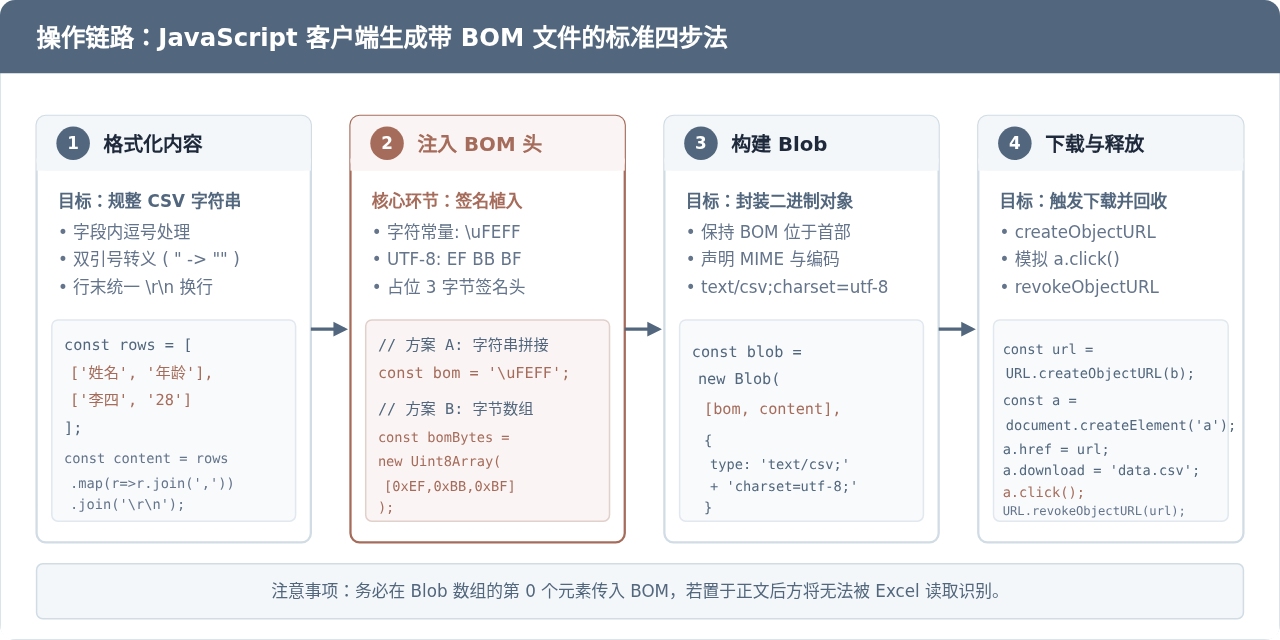
在浏览器端生成并触发下载文件的流程可以总结为四个标准步骤:组织文本数据、前置注入 BOM、封装 Blob 对象、触发静默下载。
完整且可执行的前端导出函数
以下为工业级无依赖导出实现,内建了双引号转义、换行符规整以及 BOM 注入处理:
/**
 * 将二维数据数组导出为带 BOM 的 CSV 文件并在浏览器中下载
 * @param {Array<Array<string|number>>} rows 二维数据表格
 * @param {string} filename 导出的文件名 (如: export.csv)
 */
function exportCSVWithBOM(rows, filename = 'export.csv') {
  // 第一步:格式化 CSV 内容,处理内部逗号与双引号
  const csvContent = rows.map(row => {
    return row.map(field => {
      const str = String(field ?? '');
      // 若字段包含逗号、双引号或换行符,需用双引号包裹,并将内部原有双引号替换为连续双引号
      if (/[",\r\n]/.test(str)) {
        return `"${str.replace(/"/g, '""')}"`;
      }
      return str;
    }).join(',');
  }).join('\r\n'); // 遵循 RFC 4180 标准,使用 \r\n 作为行分隔符

  // 第二步与第三步:在 Blob 构造器数组的首项置入 UTF-8 BOM 字符 \uFEFF
  // 浏览器在将 DOMString 编码为 UTF-8 字节流时,会自动将 \uFEFF 转换为 EF BB BF
  const blob = new Blob(['\uFEFF', csvContent], {
    type: 'text/csv;charset=utf-8;'
  });

  // 第四步:创建临时 ObjectURL 并通过模拟点击触发下载
  const downloadUrl = URL.createObjectURL(blob);
  const anchor = document.createElement('a');
  anchor.href = downloadUrl;
  anchor.download = filename;

  // 兼容部分特定浏览器的挂载点击要求
  document.body.appendChild(anchor);
  anchor.click();
  document.body.removeChild(anchor);

  // 释放 ObjectURL 占用的浏览器内存
  setTimeout(() => {
    URL.revokeObjectURL(downloadUrl);
  }, 1000);
}

// 调用示例
const tableData = [
  ['员工编号', '姓名', '所属部门', '岗位名称'],
  ['1001', '张伟', '技术研发中心', '前端架构师'],
  ['1002', '李静', '产品设计部', '高级交互设计师'],
  ['1003', '王芳', '数据智能平台', '算法工程师']
];
exportCSVWithBOM(tableData, '员工花名册_2026.csv');
四、底层内存排布与三种 BOM 注入方案对比
在具体代码实现时,开发者常会见到字符串拼接、Blob 数组传参或 TypedArray 三种不同的注入形式。理解它们在内存中的字节排布,有助于在不同场景下做出正确选型。
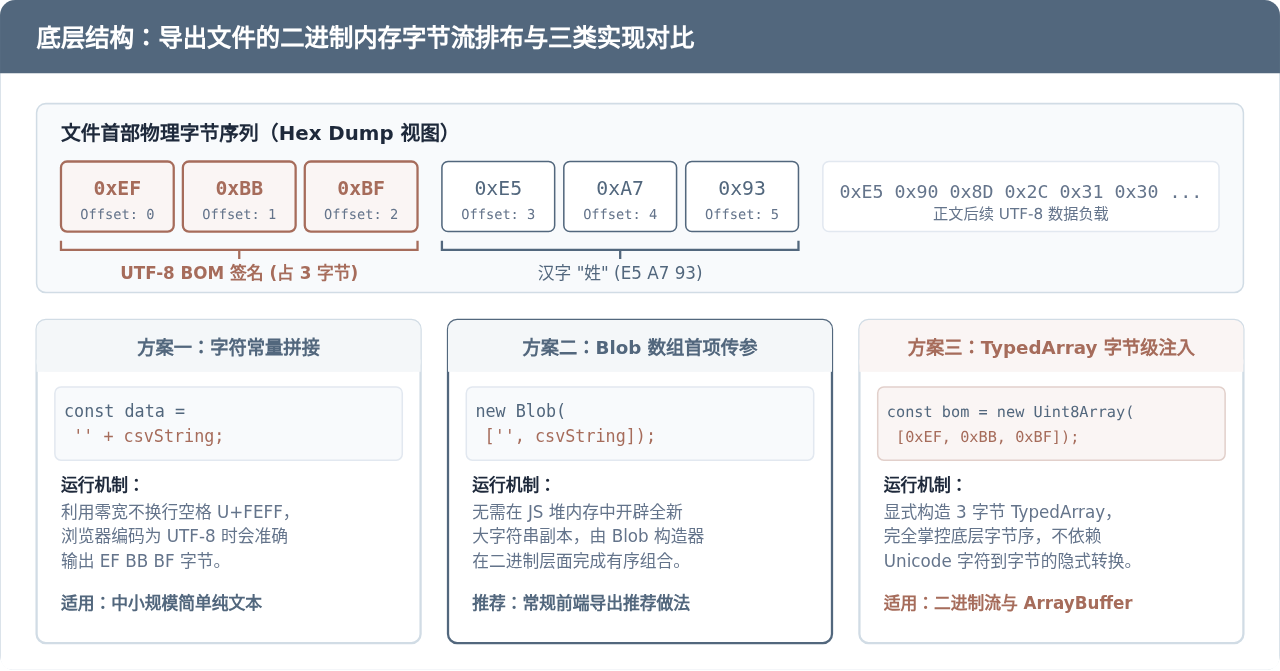
| 方案名称 | 实现代码核心 | 内存行为分析 | 优缺点与适用场景 |
|---|---|---|---|
| 方案一:字符串拼接 | const data = '' + csvStr; |
在 JavaScript 堆区开辟全新的字符串对象并发生内存拷贝。 | 语法简单直观,但数据量大时(如数十万行)会产生双倍字符串内存压力,易触发 GC 顿挫。 |
| 方案二:Blob 数组分段(推荐) | new Blob(['', csvStr], ...) |
直接传递多段片段引用,Blob 底层进行零拷贝流式包装。 | 综合最优。无需拷贝大字符串,首片段自动对齐为前 3 字节,适合绝大多数常规前端导出。 |
| 方案三:Uint8Array 字节注入 | new Blob([new Uint8Array([0xEF, 0xBB, 0xBF]), payload]) |
显式在内存中开辟 3 字节 TypedArray 缓冲区,精确控制原始物理字节。 | 不依赖字符转码环境。当 payload 本身就是 ArrayBuffer、Uint8Array 或来自 WebWorker 流时尤为适合。 |
五、实战排查与常见踩坑边界
即使添加了 BOM 头,在实际生产交付中依然可能遇到其它衍生问题。结合常见故障现象,可通过以下决策树逐步排查:
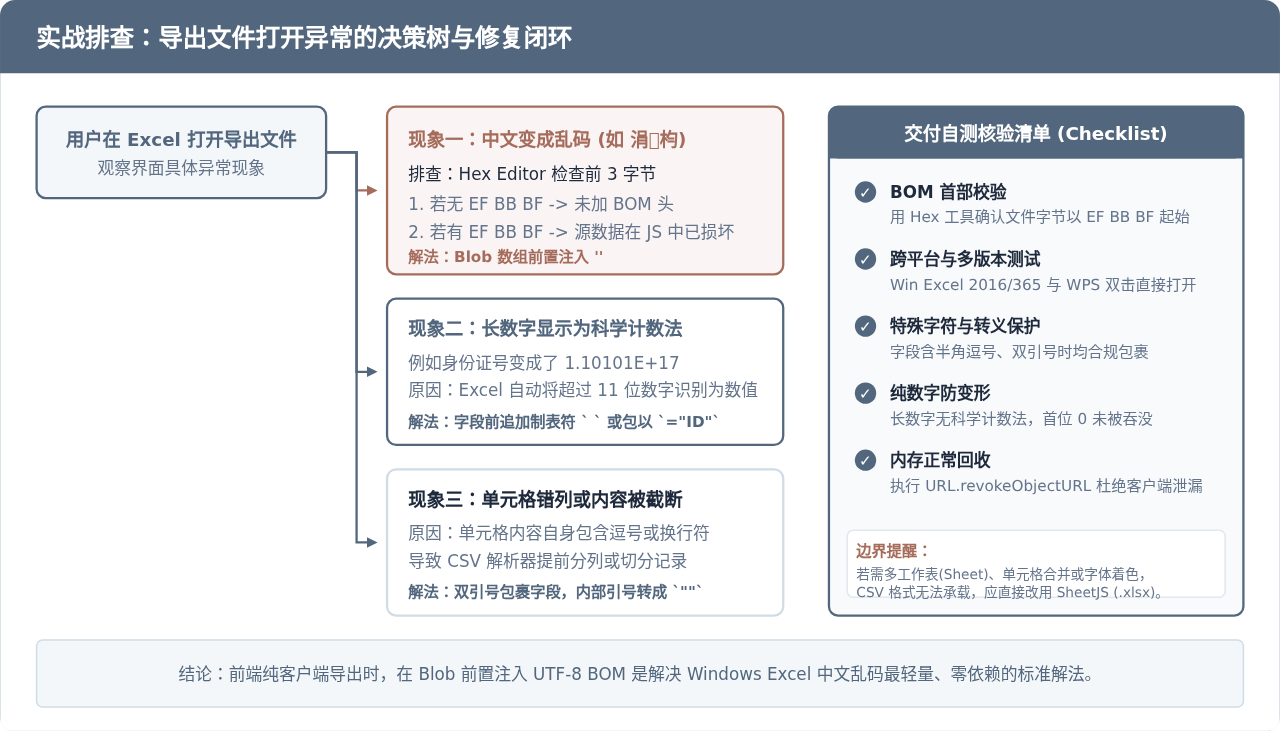
常见陷阱与解决要点
-
长数字变科学计数法(如身份证号、银行卡号):
Excel 会默认将超过 11 位的纯数字串自动格式化为科学计数法(例如110101199003072345变成1.10101E+17),且 15 位之后的数字精度会被置 0。
修复方案:在拼接该列数据时,可将其格式化为公式文本`="${id}"`,或在字段内容前追加一个制表符` ${id}`,强制 Excel 将其视作纯文本。 -
多余或重复的 BOM 导致文件损坏:
若后端返回的接口字符串本身已经携带了 BOM 头,前端若再次无条件拼接'',会导致文件开头出现 6 个字节(EF BB BF EF BB BF)。Excel 解析时虽然仍认出 UTF-8,但第一个单元格的首字前会多出一个不可见乱码符号。
检查方法:在添加前判断首字符是否已为:const safeContent = csvContent.startsWith('\uFEFF') ? csvContent : ('\uFEFF' + csvContent); -
误将文件保存为 .xlsx 后缀:
由 JavaScript 拼接生成的文本文件本质是纯文本 CSV。如果直接将下载文件名命名为data.xlsx,用户双击时 Excel 会将其当作 OpenXML 压缩包读取,进而抛出“文件格式或扩展名无效”的崩溃提示。若必须输出多 Sheet、包含单元格颜色或公式计算的真正.xlsx格式,应引入专门的二进制生成库(如 SheetJS / xlsx)。
EF BB BF。
JavaScript实现页面跳转与URL参数传递:location与History API用法
2026-11-18 14:26:27
JS动态创建div后怎么添加到页面指定位置
2026-11-18 14:06:57
JS实现局部禁止复制:特定区域允许复制而其他区域禁止
2026-11-18 13:30:19
JavaScript获取原生input[type="time"]时间控件的值
2026-11-18 10:27:59
怎么解决JS鼠标移出时因子元素导致的频繁触发问题
2026-11-18 09:38:14







