

Open Code Review 1.13.12 如何限制长行文件并保留失败信号?
Open Code Review 1.13.12 给文件读取加入单行与正文总字节边界,并让操作性部分失败返回非零状态。
Open Code Review 1.13.12 处理构建产物时,不再只靠行数约束文件读取;它还限制单行字节与结果正文总量。与此同时,包含操作性失败的部分评审会反馈非零状态,方便脚本识别未完整执行的审查。
压缩脚本只有一行,为什么仍需限制?
对前端项目而言,压缩 JavaScript、生成文件和单行 JSON 都可能出现“行数少、字节多”的情况。v1.13.12 固定标签的 file_read 源码保留 500 行限制,同时设定单行 2048 字节及渲染正文 256 KiB 的边界,补上单纯按行截取的缺口。
长行截断保持 UTF-8 字符边界,并带有省略提示;正文预算统计行号前缀、内容与换行。这个 256 KiB 预算不等同于整个文件、内存或全部模型输入的限制。IS_TRUNCATED 现在也反映字节截断,LINE_RANGE 按真正展示的行计算,不能据此推断整份文件已被完整读取。
当结果有截断提示时,分析结论应限制在可见内容内。缩小行范围可以定位后续行,但对于一行本身超长的情况,单纯缩窄行范围不会找回该行全部省略内容。
在自动化前确认版本与命令
终端已安装 OCR 时,可先运行以下命令,核对是否为目标 1.13.12 构建,并查看当前评审参数。仓库出现新版本,不等于本机或包管理器已更新。
ocr version
ocr review --help
怎样让评审脚本保留失败信号?
下面的 POSIX shell 示例适用于已配置 provider 的 Git 仓库;HEAD 是当前提交。它按官方 CLI 参数保存标准输出、错误诊断与原退出状态,运行会调用所配置的模型。实际输出取决于项目和模型配置。
#!/bin/sh
# 在已配置 provider 的 Git 仓库中执行;HEAD 表示当前提交。
# 以 1.13.12 的 ocr 为前提,保存标准输出与诊断。
review_status=0
ocr review --commit HEAD --format json > review.json 2> review.stderr || review_status=$?
printf 'OCR exit status: %s\n' "$review_status"
exit "$review_status"
预期能留下输出文件并打印原状态;遇到无效或空报告时,应先看诊断。1.13.12 对超时、provider 错误和配置错误等操作性部分失败返回 1,返回前保留已有输出,因此自动化可以识别未完整执行,同时继续利用已完成结果。
所有 partial 都应该让任务变红吗?
官方文档给出的边界是:完成或跳过返回 0,仅由配置预算限制造成的部分评审也返回 0。不能把所有 partial 都当作同一种操作故障,也不能只看零退出码就认为覆盖完整。JSON 的 warnings 与 manifest.coverage.failed 提供受影响文件和失败分类,流水线可据此制定覆盖要求。
这还意味着退出状态和发现的代码问题属于不同信号。进程成功退出不能用来证明不存在缺陷,反过来,非零退出也不意味着已经完成的所有发现都没有价值。
正式发布的证据到哪里为止?
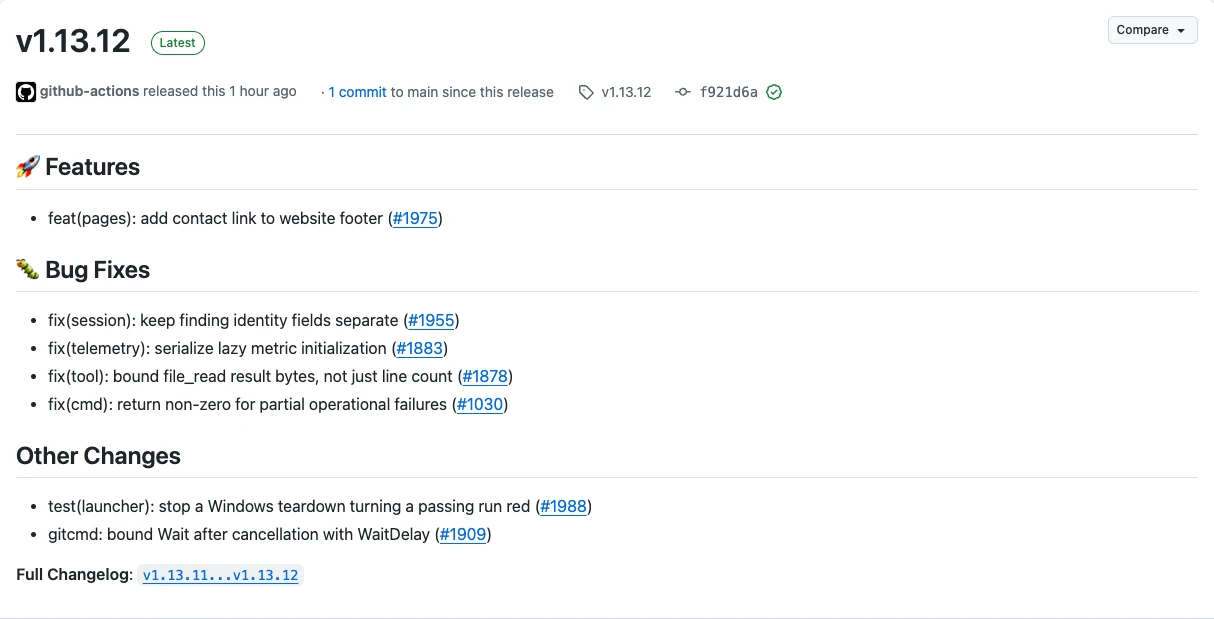
1.13.12 被官方标记为非预发布,具有 macOS、Linux、Windows 的 amd64/arm64 下载资产。发布说明还列出 finding 身份字段分离、遥测惰性初始化串行化、git 子进程取消后的等待约束,以及 Windows 测试清理修复。
发布记录和该标签源码提供的是版本与实现依据,各平台资产仍需在实际部署环境运行确认。Windows 测试条目也不能推广成全部 Windows 问题的修复承诺。升级评估可优先关注处理长行生成文件、保存部分结果及依赖命令退出码的任务。
Codex 0.170.0 的 WebSocket 回退和 Cloud 重连修复如何理解?
2026-11-18 13:43:44
EGM Lite 的规格复核与代码差异复核有什么区别?
2026-11-18 13:37:15
Python和JavaScript哪个更适合零基础入门
2026-11-18 12:32:48
原生JS Date对象解析失败返回NaN的原因及修复
2026-11-18 08:54:10
SkillEvaluator 1.0.1 在 Python 3.12–3.14 下怎样理解 HarnessCheck 结果?
2026-11-18 08:46:04