

JS验证中国大陆手机号的标准正则表达式
详细解析在 JavaScript 中验证中国大陆 11 位手机号码的标准正则表达式 /^1[3-9]\d9$/。涵盖手机号结构推导、数据清洗与容错处理、宽松匹配与号段穷举选型、lastIndex 状态陷阱以及完整的工程化代码实现。
一、大陆手机号码结构与正则推导
中国大陆公众移动通信网的电话号码由中华人民共和国工业和信息化部统一分配规划,遵循国际电信联盟(ITU-T)E.164 编码体系,标准长度为固定的 11 位十进制数字。这一结构可以从左至右切分为三段:前 3 位为网络识别码(对应具体运营商及号段类型),中间 4 位为地区编码(HLR,归属地查询基础),后 4 位为用户流水号(SN)。
在前端编写验证规则时,最核心的约束在于号码的首位与次位取值特征:
- 首位数字固定为 1:大陆移动网络全部划拨在“1”字头下,固话、特服与应急电话分别占据 0、2~9 或特殊开头,因此首位为 1 属于绝对硬性限制。
- 第二位数字必须在 3~9 之间:工业和信息化部将 10x 规划为电信业务客服服务号(如 10086、10010),11x 与 12x 规划为警务应急、火警与特种政务热线(如 110、119、120、12345),目前所有公众移动网络号段均分布于 13x、14x、15x、16x、17x、18x、19x 中。
- 后续 9 位为数字序列:每一位均可取 0 到 9 的任意数字,与前两位叠加形成 11 位总长度。
基于上述物理规律,我们推导出标准正则表达式 /^1[3-9]\d{9}$/。其内部各元字符的具体职责如下图所示:
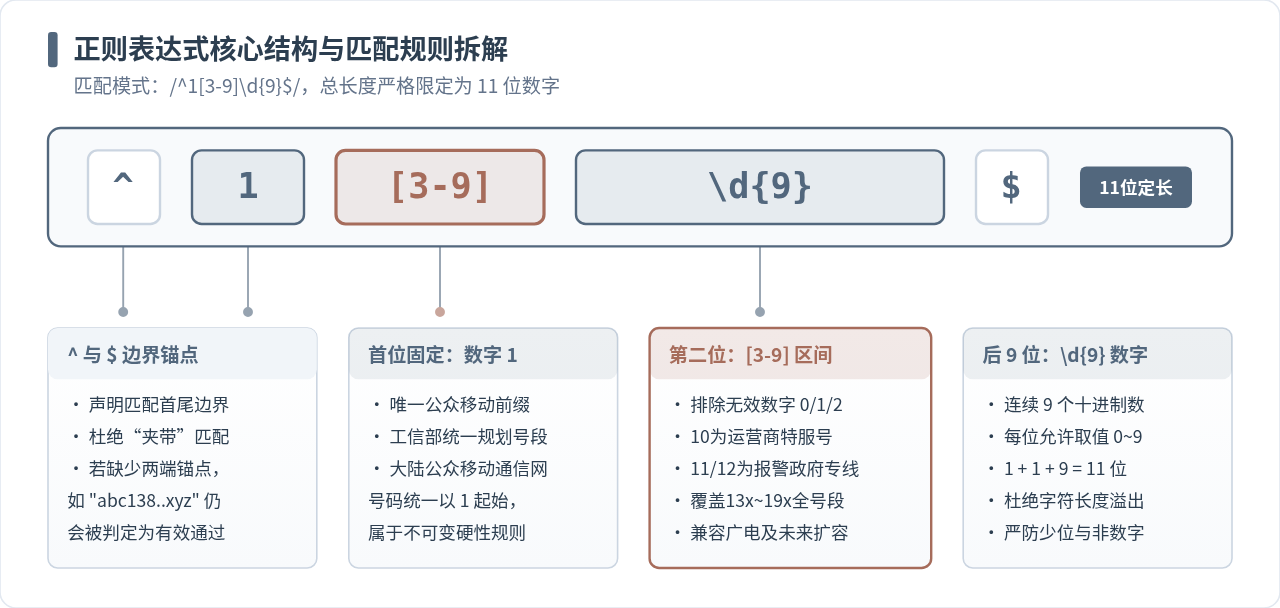
值得特别强调的是两端的锚点符号:^ 表示匹配输入字符串的起始位置,$ 表示匹配输入字符串的结束位置。若忽略这两个边界符号,仅写成 /1[3-9]\d{9}/,则输入 "abc13800138000def" 时,正则的 test() 仍会返回 true,导致非法脏数据成功绕过前端校验。
二、JavaScript 生产级验证实现与输入清洗
在真实的 Web 或小程序表单交互场景中,直接拿用户在 <input> 中录入的原生字符串进行正则比对往往是不够严谨的。用户可能会通过复制粘贴带入首尾空格、连字符(例如常见的 138-0013-8000 分隔),甚至在某些国际化表单中输入带有国际区号前缀的 +86 或 0086。
一个合格的生产级验证流程应当包括三个顺序环节:类型前置防护、格式容错清洗,以及标准正则表达式判定。
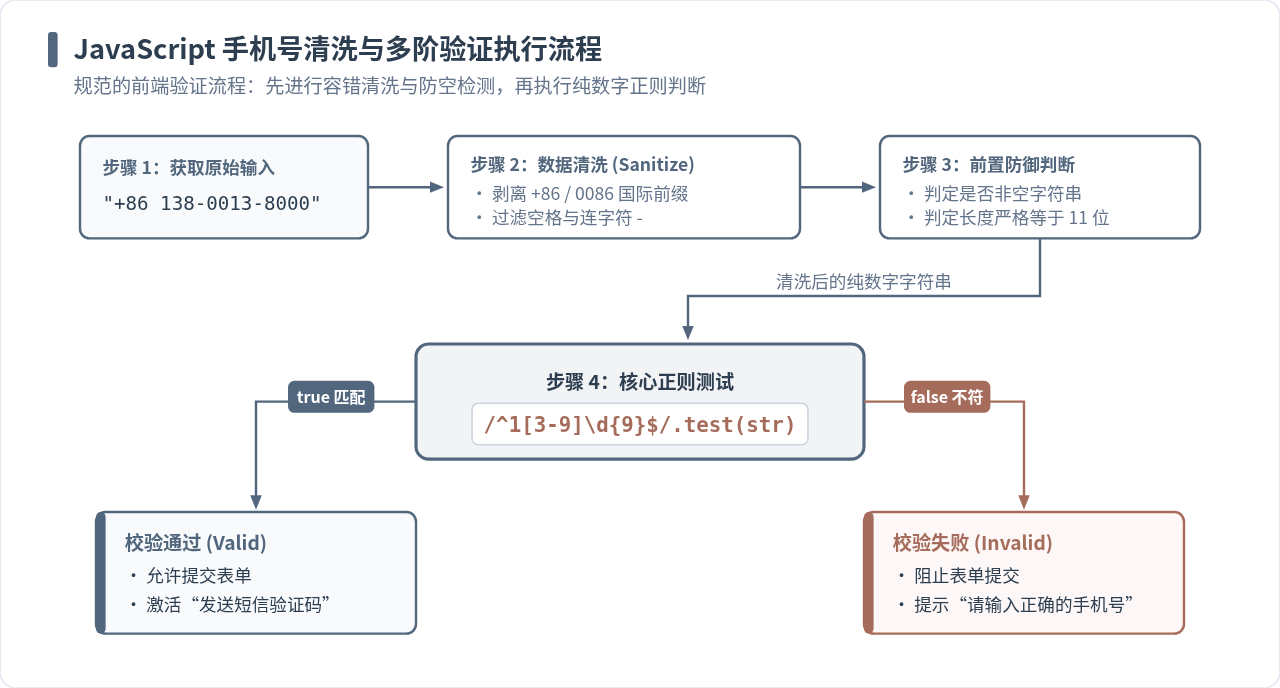
以下是按照此规范编写的纯函数实现,具备良好的鲁棒性与空指针保护能力:
/**
 * 校验中国大陆 11 位手机号码
 * @param {string|number} rawPhone - 待校验的原始输入
 * @param {Object} options - 配置项
 * @param {boolean} [options.strict=false] - 是否禁止前缀容错清洗(若为 true 则必须是纯11位)
 * @returns {{ isValid: boolean, cleaned: string, message: string }}
 */
function validateChineseMobile(rawPhone, options = {}) {
  const { strict = false } = options;

  // 1. 空值及类型安全校验
  if (rawPhone === null || rawPhone === undefined) {
    return { isValid: false, cleaned: '', message: '手机号码不能为空' };
  }

  let phoneStr = String(rawPhone).trim();
  if (phoneStr.length === 0) {
    return { isValid: false, cleaned: '', message: '手机号码不能为空' };
  }

  // 2. 格式容错清洗:剥离国际区号前缀与常见分隔符
  if (!strict) {
    // 移除 +86、0086 或 86 开头(允许前缀后紧跟空格或连字符)
    phoneStr = phoneStr.replace(/^(?:\+?86|0086)[\s-]*/, '');
    // 移除数字之间的空格与短横线
    phoneStr = phoneStr.replace(/[\s-]+/g, '');
  }

  // 3. 基础长度快速筛查
  if (phoneStr.length !== 11) {
    return { isValid: false, cleaned: phoneStr, message: '手机号码长度必须为11位数字' };
  }

  // 4. 标准正则表达式测试
  // 注意:此处正则严禁添加 /g 全局标志
  const MOBILE_REGEXP = /^1[3-9]\d{9}$/;
  const isMatch = MOBILE_REGEXP.test(phoneStr);

  return {
    isValid: isMatch,
    cleaned: phoneStr,
    message: isMatch ? '校验通过' : '手机号码格式不正确'
  };
}

// === 使用示例 ===
console.log(validateChineseMobile('13800138000'));
// 输出: { isValid: true, cleaned: '13800138000', message: '校验通过' }

console.log(validateChineseMobile('+86 138-0013-8000'));
// 输出: { isValid: true, cleaned: '13800138000', message: '校验通过' }

console.log(validateChineseMobile('12012345678'));
// 输出: { isValid: false, cleaned: '12012345678', message: '手机号码格式不正确' }
三、“宽松验证”与“号段穷举”的权衡分析
在日常开发与网络教程中,常能见到类似下方这样长达数行的“精确号段匹配”正则表达式:
// 不推荐在前端维护的号段穷举式正则示例:
const STRICT_REGEXP = /^1(3[0-9]|4[5-9]|5[0-35-9]|6[5-7]|7[0-8]|8[0-9]|9[189])\d{8}$/;
这种试图将中国移动、中国联通、中国电信以及虚拟运营商的所有已发售号段硬编码在前端的做法,在软件工程中被称为典型的“维护债务陷阱”。之所以强烈推荐使用 /^1[3-9]\d{9}$/ 宽松匹配,原因在于两者的体系分工存在根本差异。
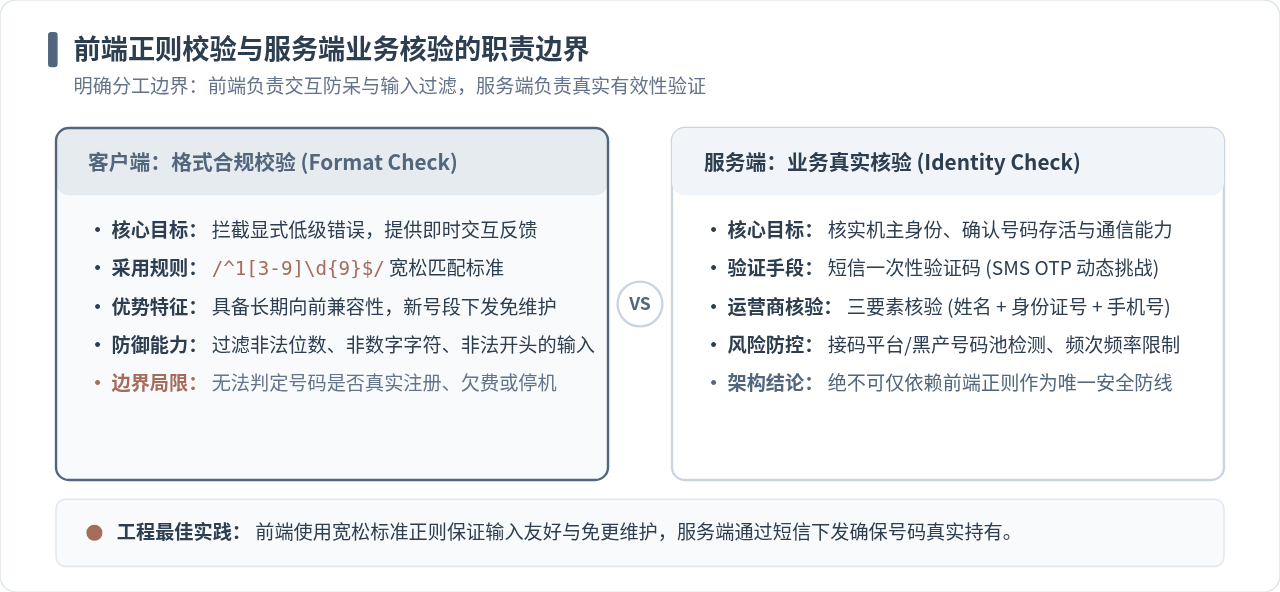
以下是两类方案在实际工程落地中的关键对比:
| 比对维度 | 标准宽松匹配 (/^1[3-9]\d{9}$/) | 号段穷举匹配 (按运营商子集列举) |
|---|---|---|
| 新号段适应性 | 免更新。工信部新分配号段(如中国广电 192)上线后自动兼容。 | 极差。未及时更新规则前,持有新号段的用户将被误报拦截。 |
| 维护成本 | 近乎为零,规则长期保持不变。 | 高昂。需专人跟踪运营商公告并频繁发版更新前端与客户端代码。 |
| 误报率 (False Negative) | 极低,只要符合国家编号标准均不会误伤合法用户。 | 较高,只要号段表出现滞后,立刻造成转化率下跌与客诉。 |
| 真实有效性保证 | 不承担真实性证明,仅做格式防呆。 | 同样无法证明该手机号已被开通、激活或归当前操作者所有。 |
正如上表所示,无论前端的号段枚举写得多么细致,只要攻击者输入一个符合号段规则的随机构造号码(例如 13800000000),穷举正则同样会予以通过。在系统安全架构中,证明手机号码真实存在且归机主控制的唯一手段,是通过服务端接入短信网关下发一次性动态验证码(SMS OTP),或在金融政务场景中调用运营商三要素认证接口。前端表单验证的本职工作仅仅是协助正常用户及时发现手误(例如少输了一位或误碰了字母),绝不能喧宾夺主去充当业务风控的核心屏障。
四、开发实践中的关键陷阱与排查
在实施 JavaScript 正则验证的过程中,有几个隐蔽且破坏力极大的技术陷阱需要格外警惕。
陷阱 1:在 RegExp.test() 中滥用全局标志 /g
许多开发者习惯给所有正则表达式顺手加上 /g 标志,例如写成 const reg = /^1[3-9]\d{9}$/g。当使用 reg.test() 连续测试同一个完全合法的手机号码时,代码将表现出诡异的“偶发性失败”:
const regWithGlobal = /^1[3-9]\d{9}$/g;
const mobile = '13800138000';

console.log(regWithGlobal.test(mobile)); // 输出: true
console.log(regWithGlobal.test(mobile)); // 输出: false (校验意外失败!)
console.log(regWithGlobal.test(mobile)); // 输出: true
console.log(regWithGlobal.test(mobile)); // 输出: false
在 JavaScript 规范中,带有
/g(或 /y)修饰符的正则表达式实例是有状态的对象(Stateful)。其内部维护着一个名为 lastIndex 的指针属性,用于记录下一次匹配搜索的起始索引。第一次 test() 成功匹配了 11 位字符后,lastIndex 会被自动更新为 11;第二次执行 test() 时,引擎会从索引 11 开始向后搜索,此时字符串末尾已无可匹配内容,因而判定为 false 并将 lastIndex 重置回 0。这就导致了“一次真、一次假”的交替Bug。解决准则:用于单值格式校验的正则表达式,严禁携带
/g 标志。
陷阱 2:国际化表单中的区号歧义处理
如果应用包含海外华人用户,或者表单支持国家/地区选择框,必须注意区号拆分。最佳实践是将国家代码(如 +86)与国内有效号码(11位数字)作为两个独立的表单字段处理。若必须在单一输入框中兼容两者,可使用前瞻或非捕获分组进行可选匹配:
// 兼容包含或不包含 +86 / 86 前缀的整串校验正则
const INT_MOBILE_REGEXP = /^(?:\+?86)?1[3-9]\d{9}$/;

console.log(INT_MOBILE_REGEXP.test('+8613800138000')); // true
console.log(INT_MOBILE_REGEXP.test('8613800138000'));   // true
console.log(INT_MOBILE_REGEXP.test('13800138000'));     // true
五、总结与速查清单
在 JavaScript 生态中完成中国大陆手机号码验证,应当坚守“标准正则防手误、容错清洗保体验、短信挑战控真实”的协同架构原则。
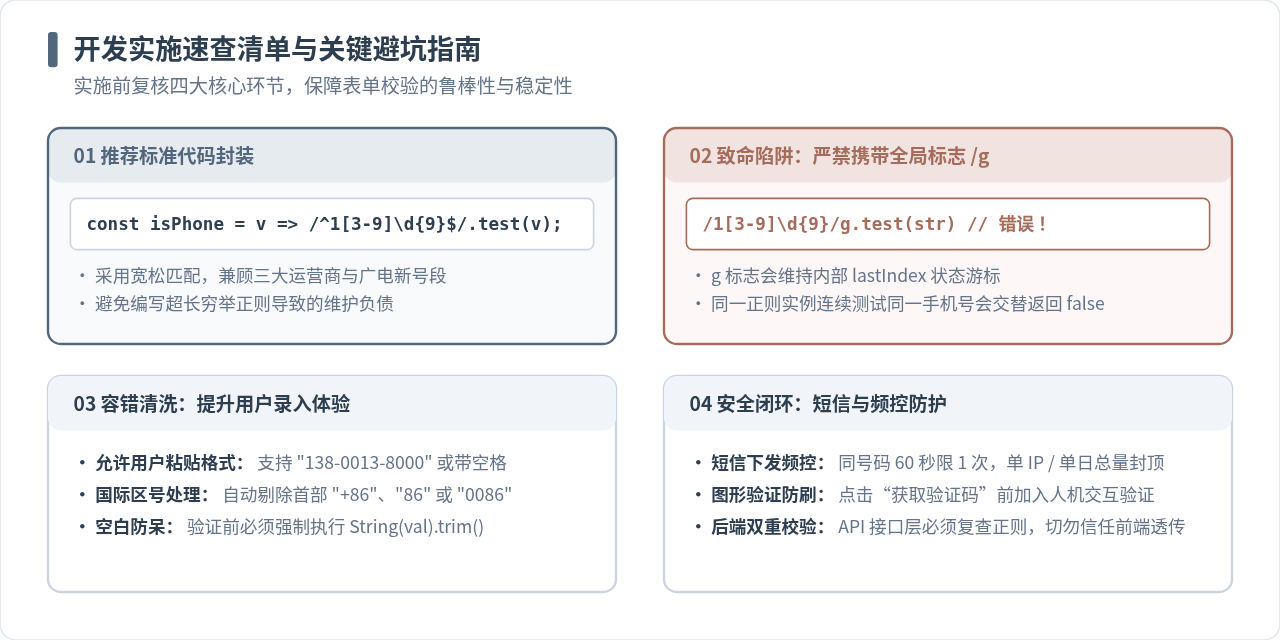
在将表单验证逻辑合入主干代码或组件库前,可对照以下四条规范逐一审查:
- 正则纯粹性:统一使用
/^1[3-9]\d{9}$/,严禁使用/g修饰符,必须包含两端锚点^与$。 - 前置清洗:在执行正则测试前,务必对输入执行
String(input).trim(),并在业务允许范围内剔除连字符与多余空格。 - 体验防阻断:切勿编写试图穷举全部运营商子号段的超长正则,避免因工信部下发新号段而阻断新用户的注册与购买流程。
- 安全双保险:前端校验仅提升交互体验,API 接口层必须维持同等校验,且必须结合短信验证码与防刷频控,构建完整的安全闭环。
JSON格式字符串怎么安全转为JS数组
2026-11-18 08:46:32
HTML引入JS后脚本报错或变量未定义的排查思路
2026-11-17 23:17:44
为什么JS函数表达式不能在定义前调用?
2026-11-17 22:52:00
JS格式化JSON遇到Circular Structure循环引用报错怎么解决
2026-11-17 22:45:37
JS怎么准确判断对象是否为空
2026-11-17 22:40:30







