

封装通用的JS对象数组动态排序工具函数
在前端与Node.js开发中,对象数组排序是高频需求。本文从基础痛点出发,深入解析动态属性提取、类型兼容、中文自然排序与多字段级联规则,逐步实现一个健壮、纯函数式且通用的JS对象数组动态排序工具函数。
一、原生排序常见痛点与通用函数设计目标
JavaScript 提供的原生排序方法 arr.sort([compareFunction]) 在设计上偏向底层,直接面向原始数组进行就地变更(In-place mutation)。当面对动态业务需求时,通常存在以下典型问题:
- 原数组被隐式修改(副作用):在 Vue、React 等现代前端框架中,直接对响应式状态或只读 Props 执行
sort()会意外篡改数据源,甚至导致组件依赖追踪失效。 - 字符串与数字类型混淆:若未传递比较函数,默认比较规则会将所有元素转换为字符串后对比 UTF-16 码点,导致
[10, 2, 5]被排成[10, 2, 5]。 - 多层嵌套取值容易报错:若按
item.dept.name排序,只要中间层级为null或undefined,直接取值就会抛出TypeError: Cannot read properties of undefined。 - 多字段联合排序逻辑冗长:当需要实现“先按部门升序,部门相同时按薪资降序,薪资再相同时按入职日期排序”时,手动书写的比较函数充斥着大量嵌套三元运算符与分支短路,极其难以复用。
为了彻底解决上述痛点,我们需要封装的通用排序工具应当具备以下四项明确设计目标:
- 数据不可变性(Immutable):保持原数组完好无损,始终返回排序后的新数组副本。
- 动态字段与路径安全解析:既支持简单属性名,也支持点分路径(如
'info.score')和自定义取值函数。 - 类型自适应与中文自然排序:能正确处理数值相减、日期前后比对,并使用
Intl.Collator准确实现汉字拼音音序及带数字的字符串自然序。 - 多字段级联与灵活配置:支持数组形式传入多条排序规则,各规则独立控制升降序与空值位置。
二、核心底层能力的逐层构建
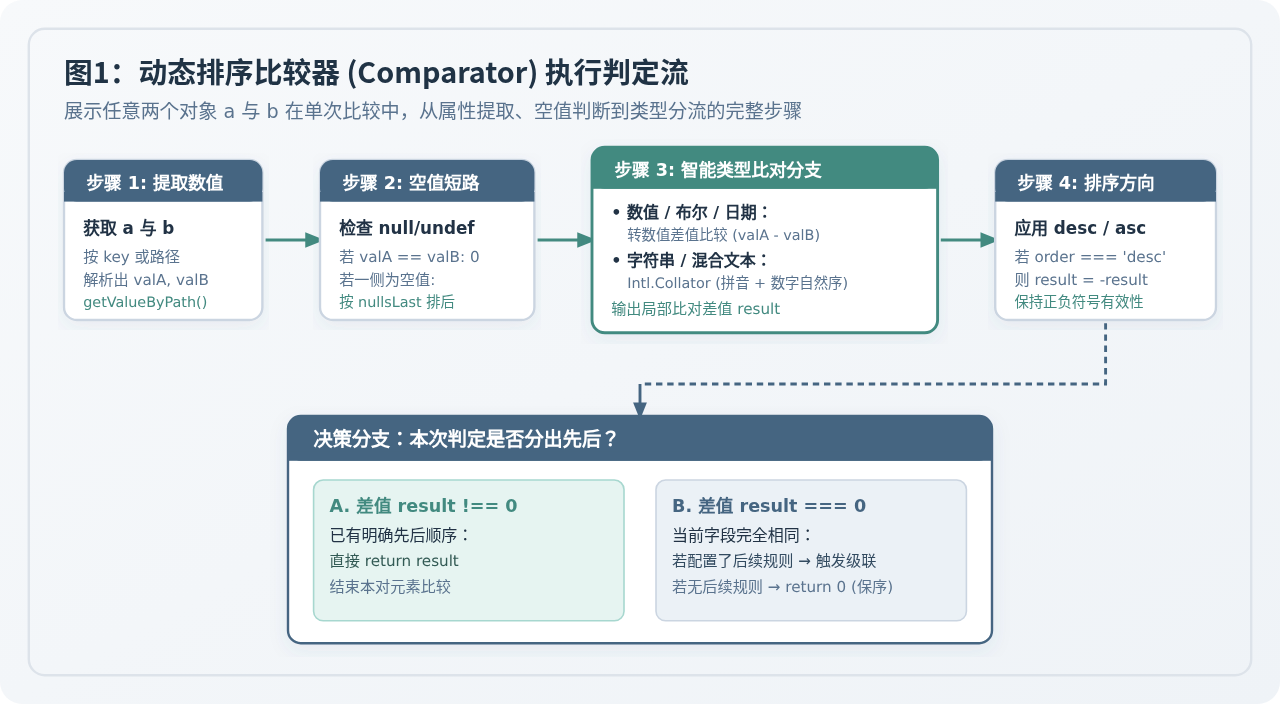
要写出工业级稳健的工具函数,不能仅仅依赖简单的 a[key] - b[key]。我们需要把属性安全提取、空值短路策略以及类型自适应这三项基础底座逐一夯实。
1. 安全解析深层嵌套属性路径
现实中的后端数据经常是深层嵌套的结构。编写一个轻量安全的路径取值器,可以避免因缺少可选链操作符而导致运行期报错:
/**
 * 根据点分路径安全读取对象的值
 * @param {Object} obj 目标对象
 * @param {string|Function} path 路径字符串或自定义取值函数
 * @returns {*} 对应的值或 undefined
 */
function getValueByPath(obj, path) {
  if (!obj || path == null) return undefined;
  if (typeof path === 'function') {
    return path(obj);
  }
  if (typeof path !== 'string') return undefined;

  // 纯属性名直接读取,避免多余分割
  if (!path.includes('.')) {
    return obj[path];
  }

  return path.split('.').reduce((current, segment) => {
    return current != null ? current[segment] : undefined;
  }, obj);
}
2. 统一空值(null / undefined)沉底与边界处理
在实际业务数据中,部分字段可能未录入或为空。如果在比较中直接进行相减或调用字符串方法,会导致 NaN 乱序或抛错。一个严谨的比较器应该允许开发者配置空值排在最前还是最后,且默认将缺失数据统一沉底:
function compareNullOrUndefined(a, b, nullsLast = true) {
  const aEmpty = a === undefined || a === null || (typeof a === 'number' && Number.isNaN(a));
  const bEmpty = b === undefined || b === null || (typeof b === 'number' && Number.isNaN(b));

  if (aEmpty && bEmpty) return 0;
  if (aEmpty) return nullsLast ? 1 : -1;
  if (bEmpty) return nullsLast ? -1 : 1;

  return null; // 两者均非空,继续常规比对
}
3. 基于 Intl.Collator 的字符串与数值智能对比
在处理字符串排序时,原生 < 或 > 仅比对 Unicode 码点。对中文环境而言,“李四”的码点可能会排在“张三”后面,完全脱离中文阅读习惯。利用现代化浏览器与 Node.js 均内置的 Intl.Collator,不仅能实现汉语拼音顺序,还能开启 numeric: true 让 "第2章" 自动排在 "第10章" 之前:
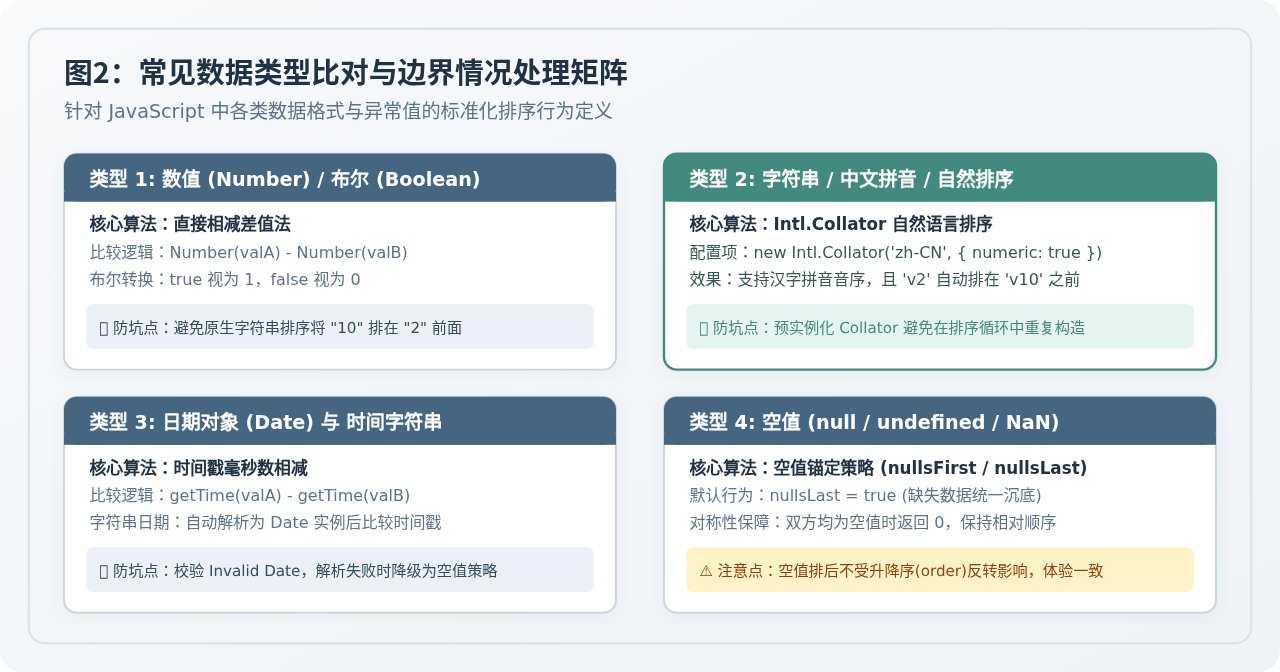
// 预先缓存Collator实例,避免在大数据量循环中重复构造产生的GC与性能损耗
const defaultZhCollator = new Intl.Collator('zh-CN', {
  numeric: true,
  sensitivity: 'base'
});

function baseCompare(valA, valB, collator = defaultZhCollator) {
  // 1. 两者完全相同
  if (valA === valB) return 0;

  // 2. 日期对象比对
  if (valA instanceof Date && valB instanceof Date) {
    return valA.getTime() - valB.getTime();
  }

  // 3. 数值型比对(含布尔值转数值)
  const typeA = typeof valA;
  const typeB = typeof valB;

  if (typeA === 'number' && typeB === 'number') {
    return valA - valB;
  }
  if (typeA === 'boolean' && typeB === 'boolean') {
    return (valA ? 1 : 0) - (valB ? 1 : 0);
  }

  // 4. 字符串或跨类型降级比较
  return collator.compare(String(valA), String(valB));
}
三、多字段级联与规则标准化设计
通用函数的易用性很大程度上取决于配置规则的表达能力。在实际开发中,我们希望既能用极简的字符串语法 '-score'(前缀 - 代表降序),也能用对象配置语法 { key: 'age', order: 'desc' },还能支持传入一个数组按顺序逐级决胜。
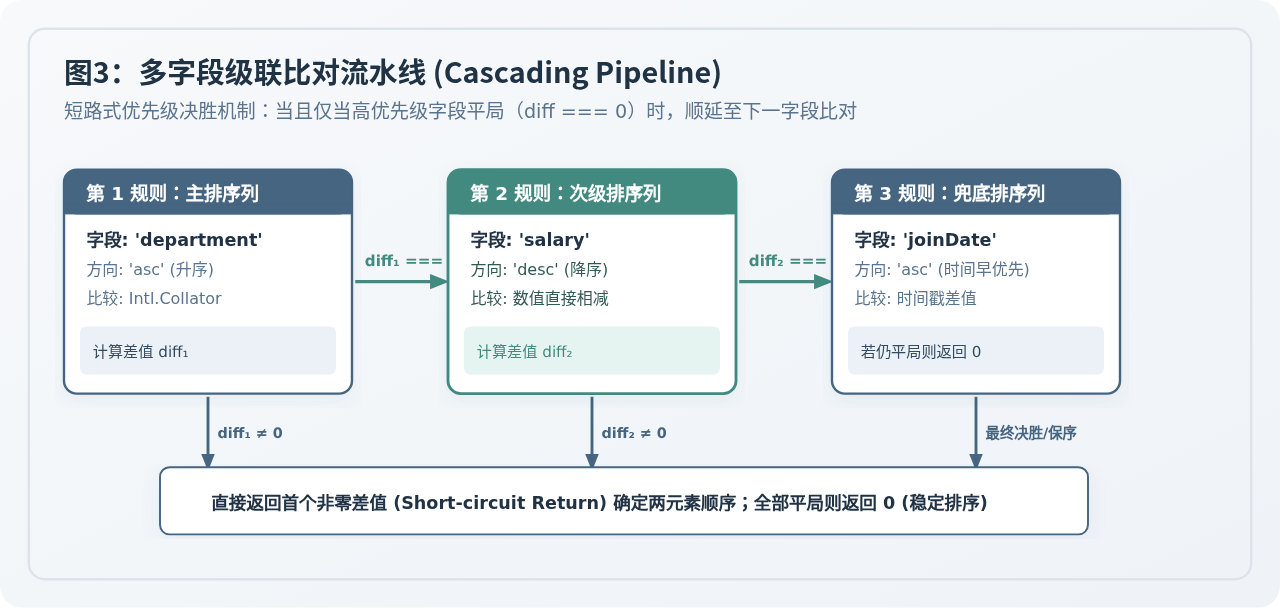
实现级联比较的关键是规则预编译(Normalization)。我们在执行排序前,将所有分散形式的规则统统解析为结构一致的描述符对象:
/**
 * 标准化排序规则
 * 规则可以为:
 * - 字符串: 'name', '-score', '+age'
 * - 对象: { key: 'user.age', order: 'desc', nullsLast: true }
 * - 取值函数: (item) => item.score
 */
function normalizeRule(rule) {
  if (typeof rule === 'string') {
    const trimmed = rule.trim();
    if (trimmed.startsWith('-')) {
      return { key: trimmed.slice(1), order: 'desc', nullsLast: true };
    }
    if (trimmed.startsWith('+')) {
      return { key: trimmed.slice(1), order: 'asc', nullsLast: true };
    }
    return { key: trimmed, order: 'asc', nullsLast: true };
  }

  if (typeof rule === 'function') {
    return { getter: rule, order: 'asc', nullsLast: true };
  }

  if (rule && typeof rule === 'object') {
    return {
      key: rule.key,
      getter: rule.getter,
      order: rule.order === 'desc' ? 'desc' : 'asc',
      nullsLast: rule.nullsLast !== false
    };
  }

  throw new TypeError(`不支持的排序规则格式: ${rule}`);
}
四、完整生产级工具函数代码封装
现在我们将上述所有能力整合为一个完整的模块。这里我们分别导出比较器生成函数 createComparator 与开箱即用的高阶纯函数 sortBy。这种设计兼顾了直接调用与在其他流处理库(如 Lodash、RxJS 或 原生 sort)中嵌入的灵活性。
/**
 * 通用对象数组动态排序工具模块
 */

// 共享的默认汉字拼音与自然文本比对器
const sharedCollator = new Intl.Collator('zh-CN', {
  numeric: true,
  sensitivity: 'base'
});

/**
 * 安全点分路径或自定义函数求值
 */
function extractValue(target, key, getter) {
  if (typeof getter === 'function') {
    return getter(target);
  }
  if (!target || typeof key !== 'string') {
    return undefined;
  }
  if (!key.includes('.')) {
    return target[key];
  }
  return key.split('.').reduce((acc, part) => (acc != null ? acc[part] : undefined), target);
}

/**
 * 创建多规则级联比较函数
 * @param {Array|string|Object|Function} rules 排序规则或规则列表
 * @returns {Function} 适用于 Array.prototype.sort 的 comparator 纯函数
 */
export function createComparator(rules) {
  // 规范化入参为数组列表
  const rawRules = Array.isArray(rules) ? rules : [rules];
  if (rawRules.length === 0) {
    return () => 0;
  }

  const normalized = rawRules.map(normalizeRule);

  return function comparator(itemA, itemB) {
    // 依次比对每条规则,遇到非0立即决胜短路
    for (let i = 0; i < normalized.length; i++) {
      const rule = normalized[i];
      const valA = extractValue(itemA, rule.key, rule.getter);
      const valB = extractValue(itemB, rule.key, rule.getter);

      // 1. 空值判断
      const nullCheck = compareNullOrUndefined(valA, valB, rule.nullsLast);
      if (nullCheck !== null) {
        if (nullCheck !== 0) return nullCheck;
        continue;
      }

      // 2. 常规数据类型比对
      let diff = 0;
      if (valA instanceof Date && valB instanceof Date) {
        diff = valA.getTime() - valB.getTime();
      } else if (typeof valA === 'number' && typeof valB === 'number') {
        diff = valA - valB;
      } else if (typeof valA === 'boolean' && typeof valB === 'boolean') {
        diff = (valA ? 1 : 0) - (valB ? 1 : 0);
      } else {
        diff = sharedCollator.compare(String(valA), String(valB));
      }

      // 3. 升降序调整
      if (diff !== 0) {
        return rule.order === 'desc' ? -diff : diff;
      }
    }

    // 所有指定规则均为平局,返回 0 保持稳定排序
    return 0;
  };
}

/**
 * 纯函数式对象数组动态排序
 * @param {Array} list 待排序数组
 * @param {Array|string|Object|Function} rules 排序规则
 * @returns {Array} 排序后的全新数组,原数组不受影响
 */
export function sortBy(list, rules) {
  if (!Array.isArray(list) || list.length <= 1) {
    return Array.isArray(list) ? [...list] : [];
  }

  const comparator = createComparator(rules);

  // 优先使用 ES2023 Array.prototype.toSorted(),环境不兼容时平滑回退浅拷贝
  if (typeof Array.prototype.toSorted === 'function') {
    return list.toSorted(comparator);
  }

  return [...list].sort(comparator);
}toSorted() 原生 API,其最大特征是直接返回排序后的副本而不破坏原数组。我们在封装中优先检测该方法,不仅兼顾前沿语法优势,还能降级保证旧版本环境的稳健运行。
五、典型实战场景与运行验证
下面通过几个具有代表性的场景,展示该工具函数在真实业务代码中的调用方法与预期输出。
场景 1:基础字段升序与降序
const employees = [
  { id: 1, name: "赵六", age: 28 },
  { id: 2, name: "孙七", age: 34 },
  { id: 3, name: "周八", age: 23 }
];

// 按年龄升序
const ascAge = sortBy(employees, 'age');
// 示例输出: id 依次为 3 (23岁), 1 (28岁), 2 (34岁)

// 按年龄降序(直接使用 '-' 前缀简写)
const descAge = sortBy(employees, '-age');
// 示例输出: id 依次为 2 (34岁), 1 (28岁), 3 (23岁)
场景 2:嵌套层级路径与中文姓名自然排序
const students = [
  { name: "张三", meta: { score: 92.5 } },
  { name: "李四", meta: { score: 88.0 } },
  { name: "王五", meta: { score: 98.0 } }
];

// 按深层分数降序排列
const topStudents = sortBy(students, '-meta.score');
// 示例输出: 王五 (98.0) -> 张三 (92.5) -> 李四 (88.0)

// 按汉字拼音自然音序排列姓名
const nameSorted = sortBy(students, 'name');
// 示例输出: 李四 (L) -> 王五 (W) -> 张三 (Z)
场景 3:复杂多字段联合级联决胜
const staffRecords = [
  { name: "甲", dept: "技术部", salary: 20000, join: "2022-03-01" },
  { name: "乙", dept: "技术部", salary: 25000, join: "2021-06-15" },
  { name: "丙", dept: "技术部", salary: 20000, join: "2020-01-10" },
  { name: "丁", dept: "人事部", salary: 18000, join: "2022-05-20" }
];

// 规则:
// 1. 部门按中文拼音升序 ('dept')
// 2. 部门相同时,薪资高者排前 ('-salary')
// 3. 薪资再相同时,入职时间早者排前 (自定义取值函数解析时间戳)
const result = sortBy(staffRecords, [
  'dept',
  '-salary',
  { getter: item => new Date(item.join).getTime(), order: 'asc' }
]);

// 示例排序结果顺序:
// 1. 丁 (人事部)
// 2. 乙 (技术部, 25000)
// 3. 丙 (技术部, 20000, 2020年入职 - 早于甲)
// 4. 甲 (技术部, 20000, 2022年入职)
六、性能优化与开发注意事项
在海量数据或高频触发排序的组件中,使用工具函数时需要关注以下三项性能要点:
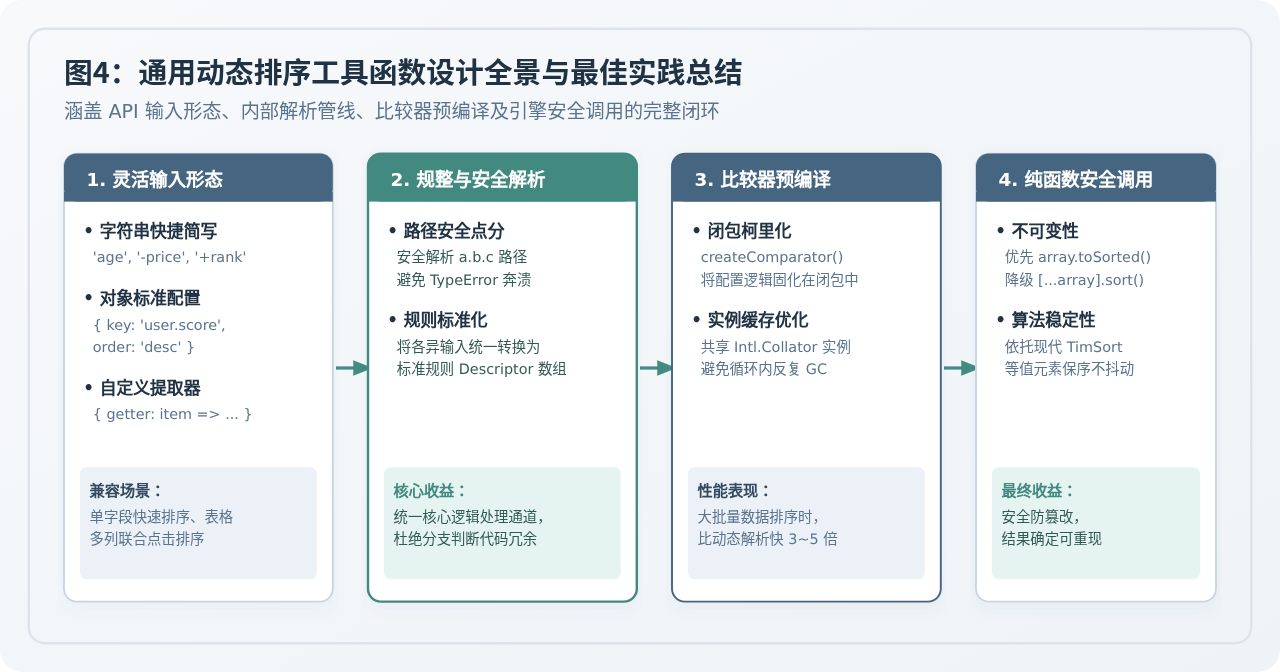
| 优化方向 | 常见误区与损耗 | 推荐最佳实践 |
|---|---|---|
| 比较器复用 | 在循环或渲染模板中反复调用 sortBy(list, rules),导致每帧重复解析规则并创建函数闭包。 |
对于固定列表头配置,使用 createComparator(rules) 预先生成比较器并固化在外部,每次仅调用比较逻辑。 |
| 国际化实例开销 | 在比较函数内部执行 new Intl.Collator(),因每次两两比较都构造新对象导致垃圾回收(GC)暴增。 |
将 Intl.Collator 提升为模块级单例共享,或通过弱引用表根据 locale 缓存实例。 |
| 算法稳定性 | 编写不满足反对称性或传递性的比较逻辑,导致排序结果在不同平台或数据轻微变更时剧烈抖动。 | 严格确保两元素完全相同时返回精确的 0;依托现代 V8 引擎采用的 TimSort 混合算法,天然保障稳定排序特性。 |
[...list] 会产生额外的数组引用开销。在此类极致性能场景下,可直接通过 list.sort(createComparator(rules)) 切换为就地排序模式,在零额外内存分配的前提下复用全部比较决策能力。
JS定时器在Event Loop中的执行时机与宏任务机制
2026-11-17 21:24:07
利用JS逻辑运算符&&和||简化if判断
2026-11-17 20:07:55
JS工厂模式与构造函数创建对象怎么选
2026-11-17 19:56:41
JavaScript全局对象是什么:window、global与self的区别
2026-11-17 19:11:59
弱引用(WeakMap/WeakSet)在JavaScript垃圾回收中的作用
2026-11-17 17:48:04







