

昆仑万维WAIC专场论坛:Matrix-Game 3.5与Mureka v9.5&O3重磅升级
昆仑万维发布Matrix-Game3.5世界模型、Murekav9.5与O3音乐模型,实现单卡20FPS实时生成,核心架构开源。方汉判断2026年为世界模型元年,认为AI将从生成转向理解与交互。圆桌共识:AI是文娱工具,人类创作者为灵魂,人机协同是未来方向。
AI与文娱的碰撞,究竟能激发出多大的能量?从演员和导演的AI创作初体验,到AI演员与真人创作者的价值博弈,再到AI如何重构平台内容生态,乃至全模态AI如何改写文娱终局——这场圆桌讨论几乎覆盖了所有关键议题。嘉宾们的共识也相当明确:AI是文娱行业最好的工具,但人类创作者始终是内容的灵魂。人机协同,才是未来的方向。
7月19日,上海西岸,昆仑万维的“世界模型与多模态范式跃迁”论坛如期举行。会上,他们一口气发布了三款重磅升级——Matrix-Game 3.5世界模型、Mureka v9.5与O3音乐模型,几乎覆盖了世界模型和AIGC创作的所有前沿赛道。
方汉:2026是“世界模型元年”,三大产业预判锚定未来方向
在论坛主旨演讲环节,昆仑万维董事长兼CEO方汉给出了一个关键判断:过去两年,AI圈最火的关键词是“生成”——生成文字、图像、视频、音乐。但从2026年开始,风向变了。核心命题从“生成”转向了“理解”与“交互”。说白了,就是让AI真正读懂物理世界的运行规律,还能和真实环境来一场闭环互动。
昆仑万维董事长兼CEO方汉
方汉在演讲中系统阐述了三大产业预判:第一,世界模型将走出屏幕,进入物理世界。具身智能正从实验室走向真实环境,这意味着机器人在行动前,必须先进行环境推演——预判动作后果、评估环境变化、及时调整应对策略。第二,游戏行业将率先被世界模型改变。开放世界游戏不再依赖数百人团队数年的手工搭建,Matrix-Game 3.5让虚拟世界随玩家行动实时生长、持续演化。第三,AI音乐、AI视频等工具将从技术试验变成大众创作工具,进一步推动AIGC的深层发展。
AI模型全球升级,掀起全模态内容生成革命
Skywork首席科学家成宇在论坛上正式发布了Matrix-Game 3.5世界模型。这款模型聚焦可交互世界模型技术,实现了Patch级别的记忆注入与系统级性能优化。具体来说,5B模型在720p分辨率下,单卡就能实现20FPS的实时生成,还能记住1分钟内的内容。
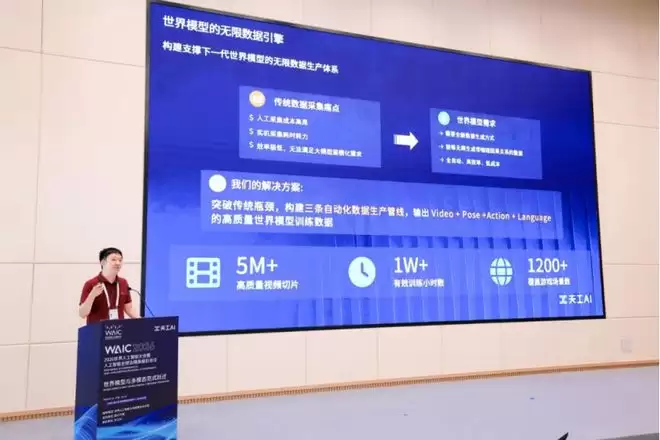
Skywork首席科学家成宇
成宇指出,世界模型是具身智能的“无限数据引擎”。Matrix-Game 3.5打造了三条自动化数据生产管线,输出Video+Pose+Action+Language的高质量训练数据,目前已积累超500万高质量视频切片、超1万有效训练小时数、覆盖1200余个游戏场景。
技术架构上,Matrix-Game 3.5将Frame-level FOV Memory升级为Patch-level FOV Memory,带来了更准确的空间记忆检索与跨帧一致性、更稳定的相机运动生成,以及最大程度保留基座模型动态生成能力的In-context Learning。用户还可以自由编辑记忆块,实现可控记忆功能。此外,在推理加速层面,通过“减少模型吞吐+DiT模型优化+VAE剪枝”三重手段,实现了单卡20FPS 720p实时推理的性能。3.5版本已宣布核心架构开源,吸引全球开发者共建生态。
昆仑万维的音乐模型v9.5版本,不再依赖声部堆砌和复杂编配制造“厉害”的第一印象,而是在真实的音乐框架中,以更克制的方式处理编配、人声、情绪与Prompt意图,让音乐表达更自然、更真诚。O3则建立在新版V9.5之上,通过test-time scaling扩展MusiCoT的推理过程。额外推理空间被用于回看偏差与自我修正,使音乐CoT能够逐步收敛,而不是一次决定后一路向前。
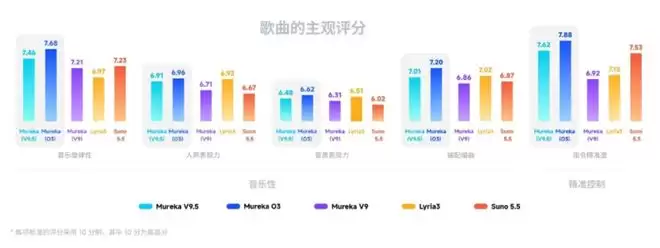
歌曲的主观评分
从评测结果来看,V9.5沿着MusiCoT路线完成了更扎实的底座升级:旋律、人声、音质和编曲全面提升,指令精准度从6.92提升至7.62。O3则建立在V9.5之上,通过持续推演、回看偏差和修正后续决策,进一步强化了旋律发展、编曲结构与指令理解,使歌曲结构更完整、情绪更连贯、段落关系更合理。简单来说,V9.5负责把歌做得更自然,O3负责让模型在交付前多看、多想、多修一遍。
用户可以从一张图、一段视频或moodboard开始,让系统理解画面的节奏、人物、空间和情绪,再生成与之匹配的音乐;当然,也可以从一首歌开始,让Agent理解歌词叙事、节拍编曲和情绪起伏,继续生成角色与MV的视觉方案。歌词决定叙事、节拍决定剪辑、旋律决定记忆点、画面决定传播场景。Agent要做的,是让这些信息在同一个创作目标下持续传递,而不是把几个生成工具简单拼在一起。
同时,Mureka推出了Character功能——一段声音、一张照片即可生成专属歌手角色,并贯穿歌曲、MV全链路;AI配乐能自动分析视频画面的场景、动作与情绪,创作更贴合内容的音乐;Mureka Agent则通过自然语言一次对话,调用整曲生成、单轨生成、Remix、延伸、MIDI导出、声音克隆等全部能力,全程无需切换界面。
院士与行业领袖齐聚,共话世界模型未来
本次论坛还邀请了多位重量级嘉宾。中国科学院院士、南京大学教授、副校长周志华受邀发表主旨演讲,围绕世界模型的前沿方向展开了深度分享。此外,黎曼动力机器人创始人刘扬教授和Reactor Technologies, Inc. CEO兼联合创始人Alberto Taiuti,也分别介绍了黎曼机器人模型1.0版和Reactor加速世界模型在全球落地的经验。
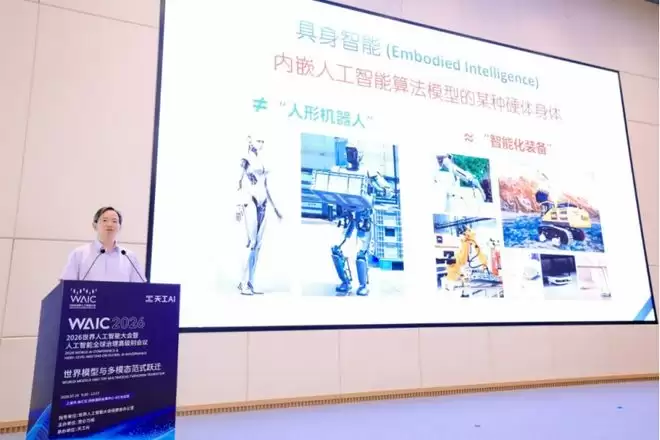
中国科学院院士、南京大学教授、副校长周志华
中国科学院院士、南京大学副校长周志华教授在题为《关于世界模型的讨论》的主旨演讲中,将世界模型划分为感知层、理解层与决策层,并着重指出决策层世界模型长期面临“多步推演复合误差平方级放大”与“样本复杂度过高”两大理论瓶颈。
黎曼动力机器人创始人刘扬教授
黎曼动力机器人近期推出的Riemann-1.0,是其成立以来首个公开发布的成果——面向Physical AI的新一代Embodied World Action Model。该模型基于超过23.2万小时多源具身交互数据训练,统一融合了第一视角人类视频、UMI示教与异构机器人轨迹,并提出了全因果世界动作建模架构与三阶段渐进式具身预训练框架。
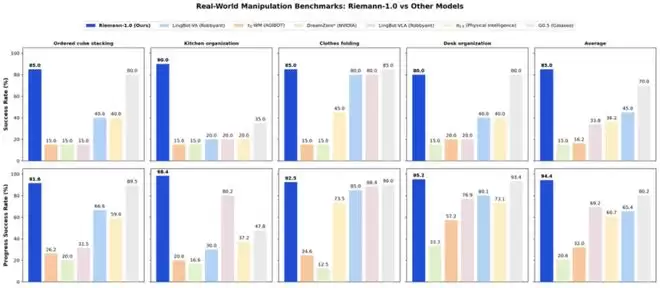
真机评测:四大家居任务全面领先
Reactor Technologies, Inc. CEO兼联合创始人Alberto Taiuti强调,世界模型不再只是生成视频或图像,而是能够持续推演环境变化并支持双向人机交互的“生成式软件”雏形。他以公司同名平台“Reactor”为例,展示了为世界模型原生设计的开发者基础设施,如何在保持极低延迟与流式传输的同时,支持机器人、游戏、仿真等高频交互场景。
Reactor Technologies, Inc. CEO兼联合创始人Alberto Taiuti
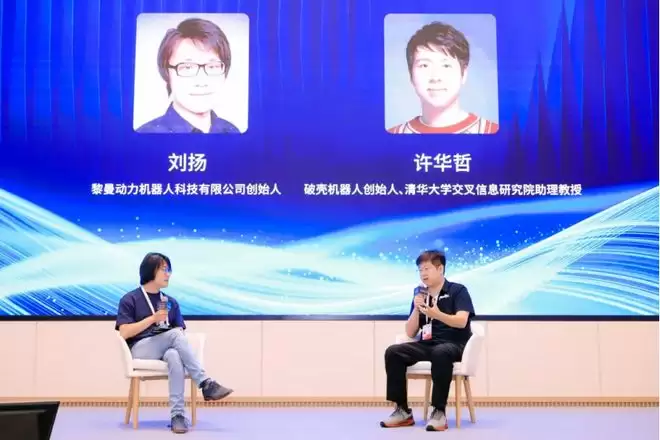
在具身智能对谈环节,黎曼动力机器人创始人刘扬与破壳机器人创始人、清华大学交叉信息研究院助理教授许华哲,围绕“具身世界模型的ChatGPT时刻”展开了深度对话,探讨了世界模型与VLA的边界、机器人通用世界模型的训练瓶颈、具身智能的Scaling Law以及家庭机器人PMF等核心议题。
全模态内容革命:AI重塑视频、游戏、音乐与全球文娱
论坛压轴环节举行了“全模态内容革命——AI重塑视频、游戏、音乐与全球文娱”圆桌对话,由甲子光年创始人张一甲主持。昆仑万维董事长兼CEO方汉,中国电影家协会副主席黄晓明,演员王珞丹,爱奇艺高级副总裁杨海涛,青年导演崔睿共同参与。
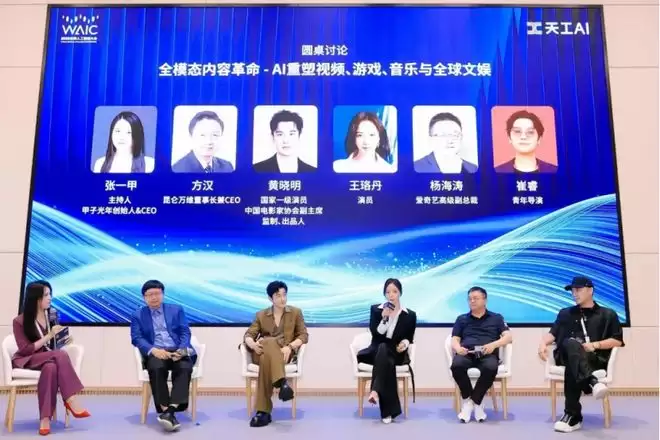
圆桌围绕AI与文娱产业的深度融合展开讨论:从演员和导演的AI创作初体验到AI演员与真人创作者的价值博弈,从AI重构平台内容生态到全模态AI重塑文娱赛道终局。嘉宾们一致认为,AI是文娱行业最好的工具与最大的革新者,而人类创作者永远是内容的灵魂缔造者,人机协同将成为全球文娱行业的新发展范式。