

JS中toUpperCase与toLocaleUpperCase有什么区别?
深入对比解析JavaScript中toUpperCase与toLocaleUpperCase的核心差异、内部转换机制、语言区域规则(如土耳其语i特例)、开发避坑指南与最佳实践决策树。
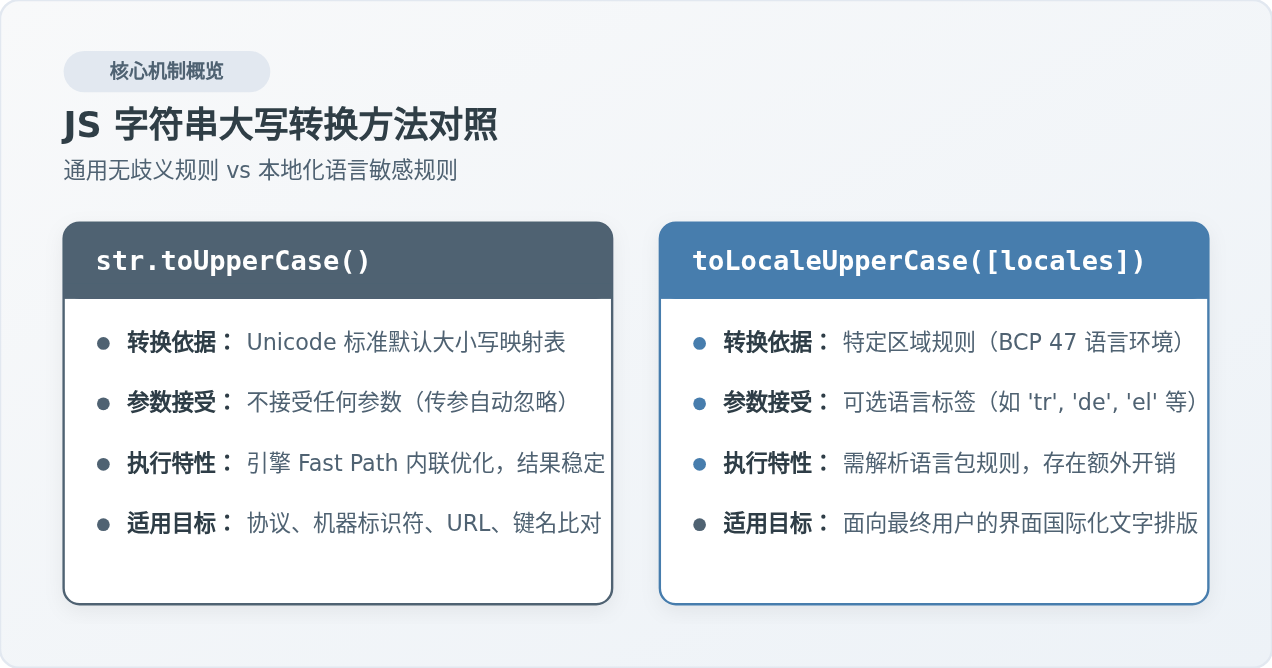
在 JavaScript 中,toUpperCase() 和 toLocaleUpperCase() 都能把字符串中的字母转换成大写形式,但两者的本质区别在于:转换过程是否遵循特定语言或区域(Locale)的大小写映射规则。简单来说,toUpperCase() 永远遵循 Unicode 标准的通用无语言差异规则,而 toLocaleUpperCase() 则依据宿主当前系统环境或显式指定的语言区域规则进行大小写映射。
一、为什么会有两个看起来几乎一样的方法?
对于大部分常规英文字符(例如 'hello world'),这两个方法的执行结果完全一致,都会得到 'HELLO WORLD'。这让不少初学者产生疑问:既然结果一样,为什么 JavaScript 还要提供两个独立的方法?
原因在于:字母的大小写映射并非在所有人类自然语言中都是完全一致的数学规则。在不同语言和国家文化中,同一个字符的大写对应形式可能存在差异。ECMAScript 规范为了同时兼顾“纯计算机通用协议的高性能稳定转换”与“国际化人机界面的精确排版”,分别设计了这两个方法:
toUpperCase():遵循 Unicode 的默认通用映射(Unicode Default Case Mappings)。它屏蔽了所有宿主操作系统的地域配置差异,不论你的电脑是在中国、美国还是土耳其,执行结果始终保持确定。toLocaleUpperCase([locales]):遵循特定的区域文化规则。如果不传入参数,它会读取当前运行环境(操作系统或浏览器)的区域设置;如果显式传入locales参数(例如'tr-TR'),则严格按照指定语言规则执行转换。
二、核心机制与转换处理流水线对比
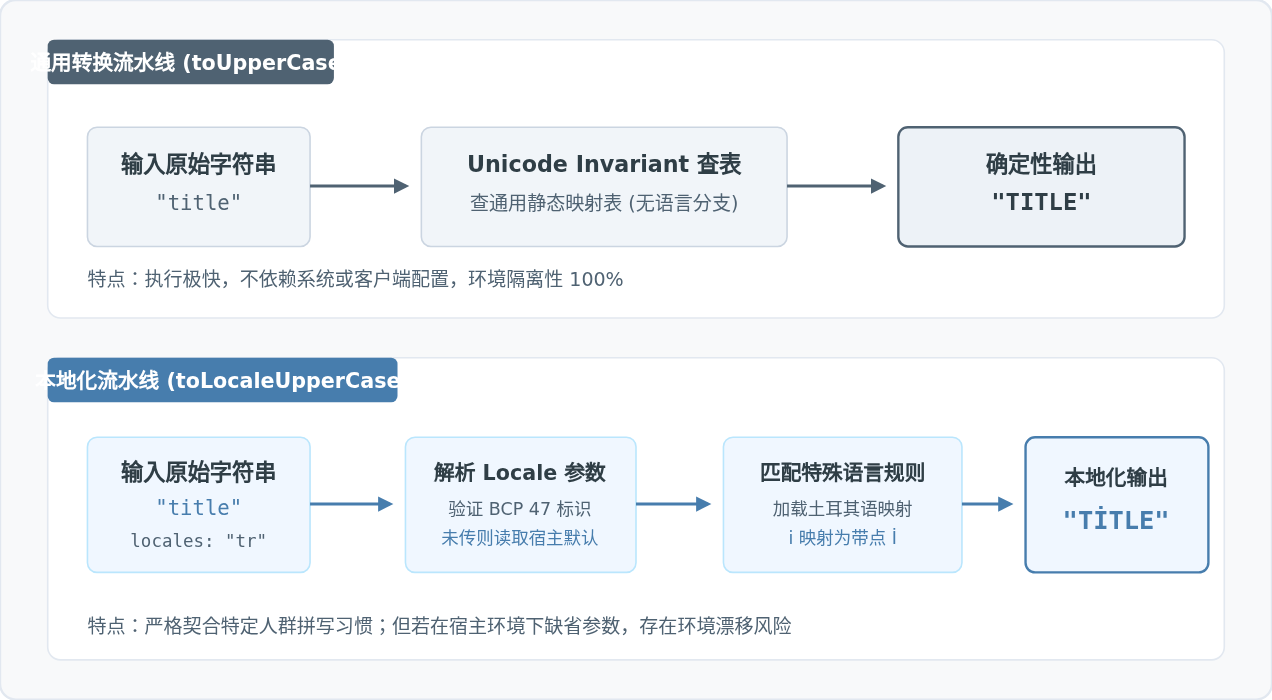
通过底层的调用流程可以更清晰地理解两者的计算链路。toUpperCase() 的处理路径短而直接,而 toLocaleUpperCase() 则多了一道“语言环境识别与规则分派”的步骤。
三、最典型的差异案例:土耳其语字母 “i”
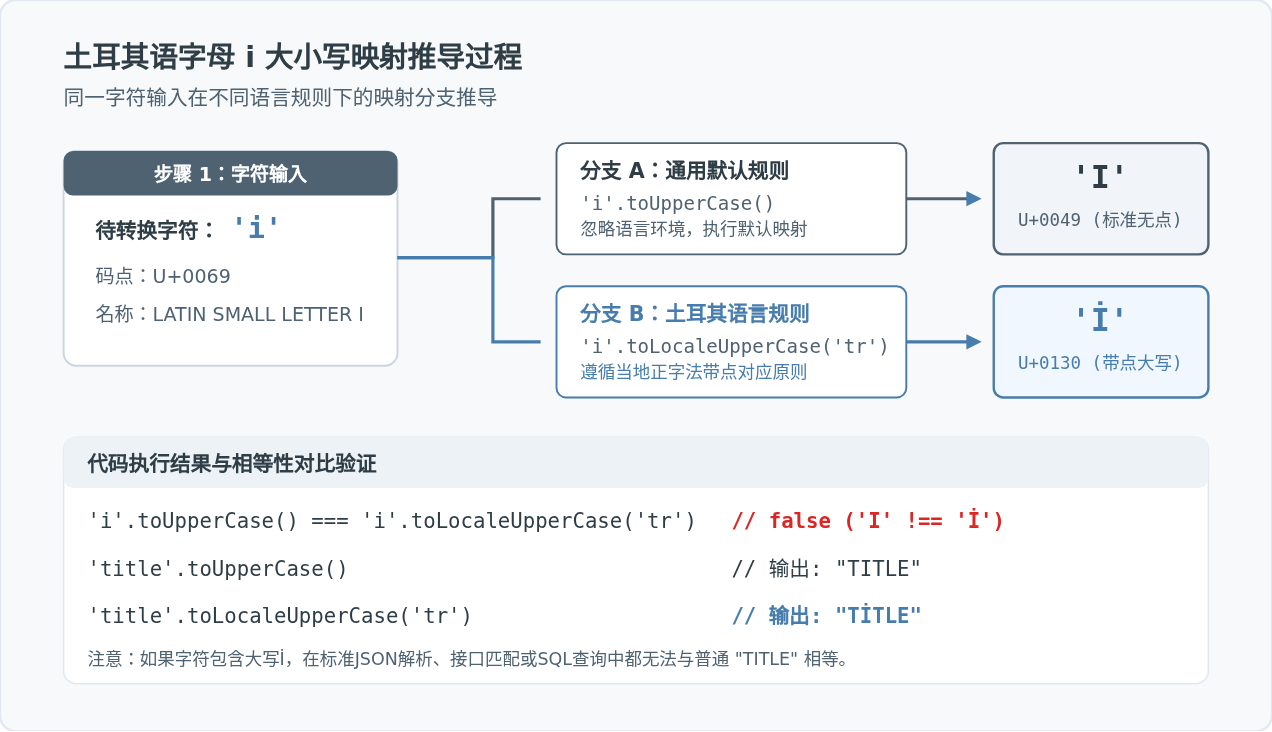
讨论这两个方法时,最经典、最具说服力的案例就是土耳其语(Turkish,代码 tr)和阿塞拜疆语(Azerbaijani,代码 az)中的字母 i。
1. 字母体系的本质不同
在通用英语和大多数使用拉丁字母的语言中,字母 i 的大小写关系非常直接:小写字母为带点的 i,大写字母为不带点的 I。
但在土耳其语中,字母 i 区分成完全独立的两个字母对:
- 带点字母对:小写
i(带点)的大写形式是带点的İ(Unicode 编码为\u0130,LATIN CAPITAL LETTER I WITH DOT ABOVE)。 - 无点字母对:小写
ı(不带点,Unicode\u0131)的大写形式才是标准不带点的I(Unicode\u0049)。
2. 实测代码演示
// 1. 常规默认大写转换(通用 Unicode 规则)
const word = 'istanbul';
console.log(word.toUpperCase());
// 输出: "ISTANBUL" (首字母为 U+0049 'I')

// 2. 指定土耳其语区域转换
console.log(word.toLocaleUpperCase('tr-TR'));
// 输出: "İSTANBUL" (首字母为 U+0130 'İ')

// 3. 严格相等判断
console.log(word.toUpperCase() === word.toLocaleUpperCase('tr-TR'));
// 输出: false
四、开发中极易引发故障的真实场景
很多开发者在编写代码时,习惯随手输入代码补全弹出的 toLocaleUpperCase(),并且不传递任何参数:
// 潜在的风险代码:不传参数调用 toLocaleUpperCase
const method = req.method.toLocaleUpperCase();
if (method === 'POST') {
  // 处理逻辑
}当 toLocaleUpperCase() 没有接收参数时,它会直接回退使用执行该代码的操作系统的当前系统语言。
如果该脚本运行在土耳其用户的电脑、或者一台系统语言被配置为土耳其语(tr-TR)的海外服务器/Docker容器中:
const action = "origin";
console.log(action.toLocaleUpperCase()); // 在土耳其系统环境下输出: "ORİGİN"
console.log(action.toLocaleUpperCase() === "ORIGIN"); // 输出: false!
只要待处理的字符串中包含字母 i(例如 origin、filter、view-item、inline、link 等),字符串匹配全部会意外失效。这会导致 HTTP 鉴权报错、路由找不到、Header 校验失败等极其难以复现的诡异 Bug。
五、如何做出正确的技术选型?
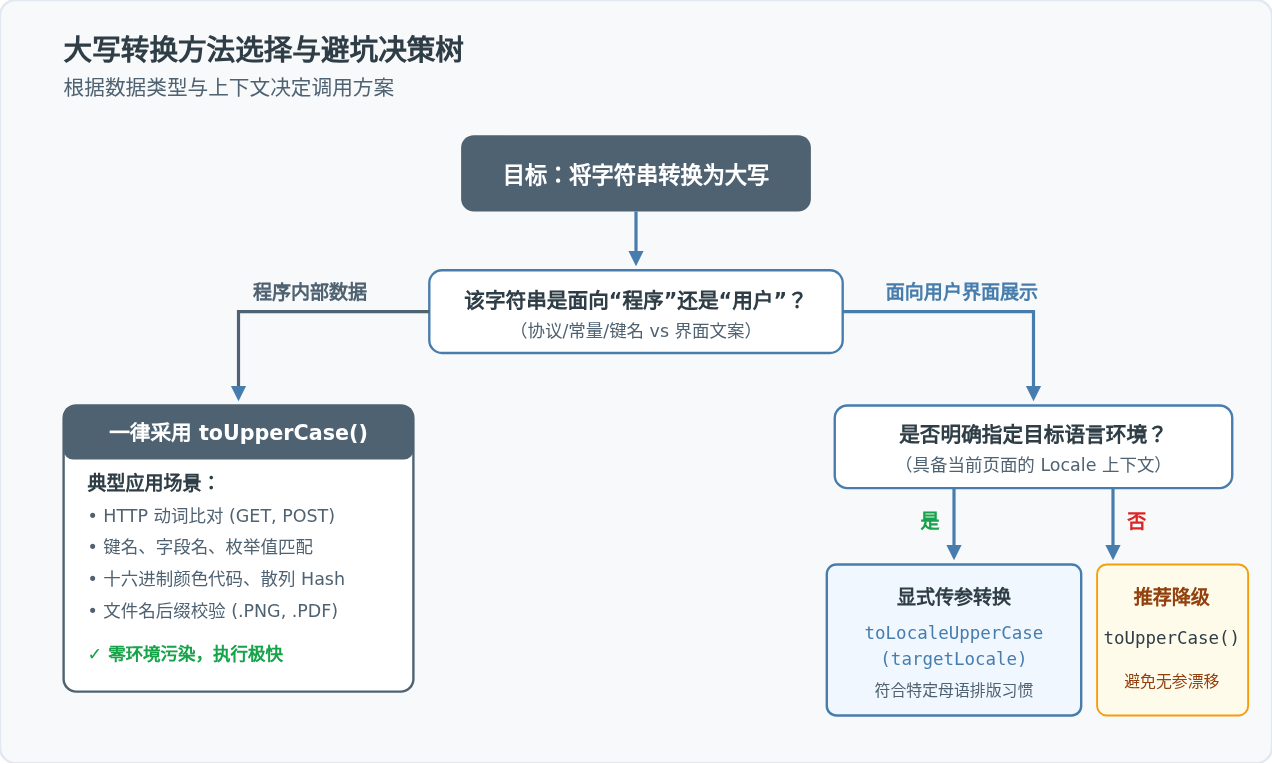
为了在实际项目中写出健壮、可预测的代码,可以依据以下决策树来判断该使用哪一个方法。
六、性能表现与参数规范说明
1. 性能对比
在底层 V8 引擎中,toUpperCase() 通常直接走 C++ 的 Fast Path,执行高度内联优化,仅涉及单字节 ASCII / UTF-16 内存偏移计算。而 toLocaleUpperCase() 需要先走 ECMAScript 国际化规范(ECMA-402)的流程:解析参数、规范化 Locale 字符串(如验证合法性、处理扩展标签),并匹配系统 ICU(International Components for Unicode)数据。在超高频循环或密集数据计算时,toUpperCase() 的执行速度明显快于 toLocaleUpperCase()。
2. 参数传递规则
toLocaleUpperCase 支持接受标准的 BCP 47 语言标签,既可以传递单个字符串,也可以传递语言偏好数组:
// 传单个语言代码
'istanbul'.toLocaleUpperCase('tr'); // "İSTANBUL"

// 传包含区域的语言标签
'istanbul'.toLocaleUpperCase('tr-TR'); // "İSTANBUL"

// 传备用语言数组(优先使用第一个被支持的语言环境)
'istanbul'.toLocaleUpperCase(['az', 'tr', 'en']); // "İSTANBUL"
七、核心要点总结与对照清单
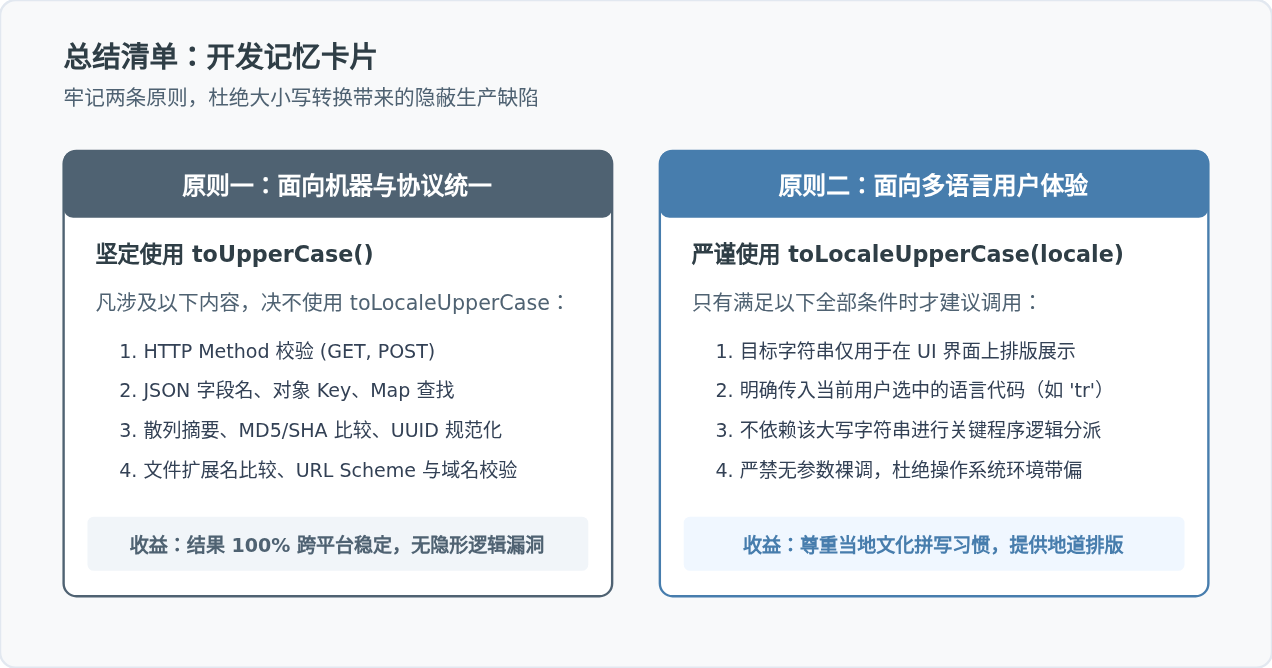
下表和总结图汇总了两个方法的所有关键技术指标,便于在代码审查或开发时快速对照:
| 比较维度 | str.toUpperCase() |
str.toLocaleUpperCase([locales]) |
|---|---|---|
| 转换标准 | Unicode Invariant(默认通用无区域规则) | BCP 47 语言区域规则(遵循正字法) |
| 参数支持 | 无参数(传入任何参数均被忽略) | 支持传入 locales 字符串或数组 |
| 未指定语言时的行为 | 始终保持通用规则,结果 100% 幂等 | 自动读取当前运行操作系统的默认语言(存在环境漂移风险) |
| 执行性能 | 极高(引擎快速路径直接内联) | 中等(涉及参数解析与 ICU 词法表) |
土耳其语 'i' 的大写 |
'I' (U+0049) |
'İ' (U+0130,当指定 'tr' 时) |
| 核心应用场景 | 接口协议、文件名、代码逻辑、常量 | 多语言前台 UI 界面的人性化文字排版 |
Google Gerrit Code Review 1.0.0 怎么核对 REST 查询与写入的权限边界?
2026-11-17 18:59:26
Ducter 0.0.67 的暂存消息和代理记录由什么触发
2026-11-17 14:05:20
last30days-skill v4.2.1、v4.3.0 如何区分查询不完整和无结果?
2026-11-17 13:39:55
ChatGPT for Academic Researchers候补资格与开放申请有什么区别
2026-11-17 13:30:52
eBay 6.282.0兼容哪些Apple系统,设备支持说明有什么边界?
2026-11-16 18:43:35







