

llama.cpp b12458为何要按槽位保存YuE2-3B的采样分数
llama.cpp b12458加入YuE2-3B,修正流式生成,并按序列保存采样分数。
旧路径在多个槽位交错解码时,最后更新的上下文分数可能来自别的序列。新实现保留各序列自己的分数,再完成引导混合与后续采样。
llama.cpp b12458加入了哪一项模型能力
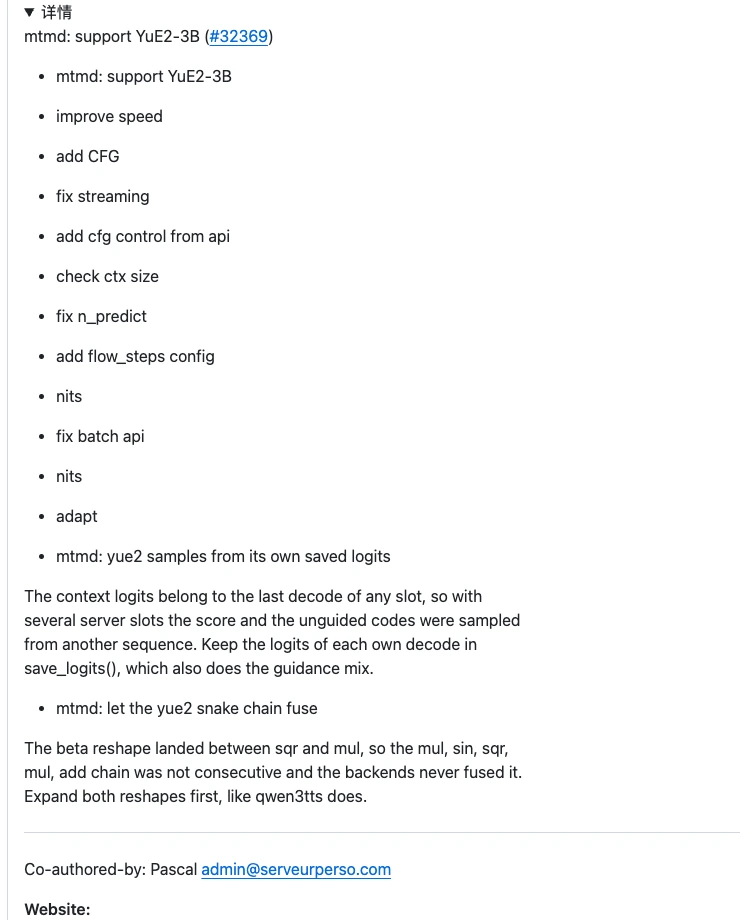
llama.cpp b12458通过多模态组件mtmd加入YuE2-3B支持,面向音频生成。发布说明还列出流式处理修正、上下文大小检查、生成长度相关修正和批处理接口调整。版本的模型支持范围应按这一具体模型与相应构建理解。
流式输出和CFG各控制什么
流式处理关系到生成过程中如何分批交付输出。CFG指无分类器引导,作用在采样前的分数混合,用来调节条件对生成结果的影响。发布说明记录了流式修正和来自接口的CFG控制,并列出了生成流程步数的配置支持。实际调用的字段与取值仍取决于对应接口和构建的说明。
多个槽位为什么需要分别保存分数
在服务端多槽位场景,槽位对应各自正在处理的序列。上下文中的最新logits可能属于最后一次执行解码的任一槽位。如果两次解码交错,直接从公共上下文读取最新分数,就可能把其他序列的分数或无引导编码取来用于当前采样。
b12458保存每个序列自身解码得到的logits,并在该路径完成引导混合。这样采样数据与发起该轮解码的序列保持对应。单个请求只涉及自己的序列,多槽位交错时这项隔离更关键。
评估并发时该分别观察什么
流式输出关注交付是否连续,采样归属关注不同序列是否使用自己的分数,生成速度则还取决于模型、后端、硬件和并发量。此次发布也整理了模型中的计算链,便于满足后端算子融合条件。实际性能需要用对应构建和部署条件来判断。
JS使用JSON.stringify将对象转换为JSON字符串
2026-11-17 10:54:18
JS怎么处理非标准JSON字符串导致的解析格式化失败
2026-11-17 10:32:29
Ducter 0.0.59怎样区分聊天接入条件和任务等待状态
2026-11-16 21:58:01
Java和JavaScript哪个更难学?初学者入门门槛对比
2026-11-16 15:04:52
JS中==与===判断字符串相等的区别及最佳实践
2026-11-16 14:27:08