

Unlimited OCR 2云端服务与本地部署有什么区别,TextMind入口意味着什么
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
判断Unlimited OCR 2能否用于自己的文档任务,应把云端渠道、账号条件与本地部署分开。官方模型说明已确认百度智能云可用,并给出TextMind网页入口;是否具有对应服务权限、额度和适用接口,还需要结合账号实际展示的信息判断。
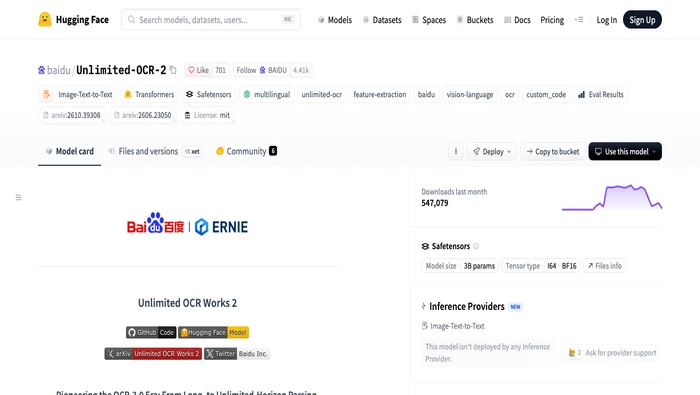
这次确认的是云端渠道
官方模型说明的Release部分新增了百度智能云正式可用的说明,并将网页入口指向TextMind的文档解析页面。这里应区分“模型已经公开”和“云服务渠道新增确认”:Unlimited OCR 2此前已有模型说明、权重及本地推理内容,不能把这条云端渠道信息写成模型本身刚刚首次开源。
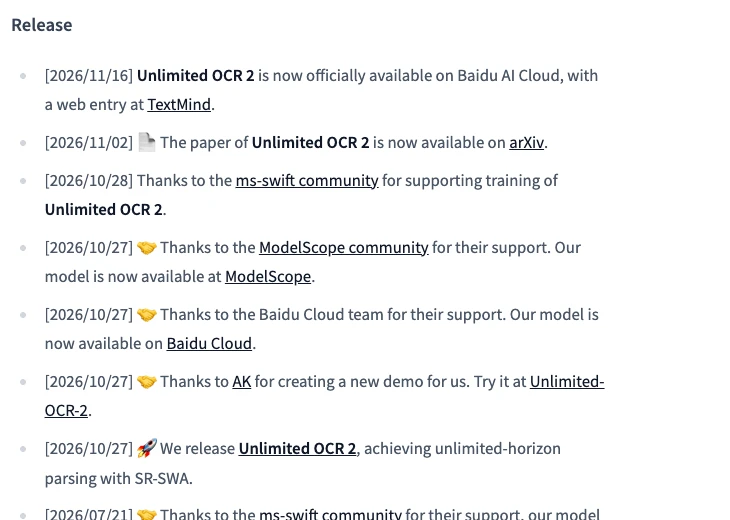
TextMind入口的路径对应文档解析应用。公开入口可以帮助识别服务去向,但路径名称本身不说明完整功能菜单,更不能代替账号内的服务授权、配额和接口说明。对网页使用与程序接入,应分别依据实际产品页面和适用文档判断。
账号、权限和额度应分别判断
公开入口需要登录百度智能云控制台。登录只是进入账号环境,不等于已经获得全部文档解析能力;现有公开说明没有给出适用于所有账号的开通状态、免费额度、单次页数限制或并发数量。使用前需要明确账号是否具备对应服务权限,以及页面所列的资源与计费条件是否适用于计划处理的文档。
额度与费用也不是同一个概念。即使某项服务提供试用资源,资源覆盖的功能、有效期和用完后的处理方式仍需以服务说明为准。公开说明没有列出统一免费数量或价格;模型仓库的下载量、点赞与开源许可,也不代表云服务免费。
本地推理示例不能直接当作云API
官方模型说明同时包含本地模型推理内容,例如加载模型、传入页面图片以及多页推理。模型侧的infer_multi示例按页面顺序提供图片,输出按输入顺序包含页面标记;这些是模型使用方式,不能据此认定TextMind采用相同请求结构、认证字段或返回格式。
如果目标是自行部署,应关注对应模型说明中的运行环境、依赖和模型调用;如果目标是使用百度智能云,则应关注该云服务当前提供的网页功能、账号授权、配额和正式接口文档。两条路径的部署责任与接入条件不同,不应把本地权重调用包装成已经核实的云API示例。
怎样确定是否适合自己的文档任务
评估时可以先明确需求属于网页文档解析还是程序化处理,再核对对应渠道实际提供的能力与限制。复杂版面、长文档和跨页信息是否满足业务要求,需要结合产品的适用说明与自己的文档验证;官方入口确认不等于对所有文档准确率、处理时延或业务可用性的保证。
目前能够确定的是Unlimited OCR 2的百度智能云渠道及TextMind网页去向。账号内上传控件、识别结果页面、额度设置和云API参数,应以实际可用服务的界面与文档为准。将渠道确认与具体账号可用条件分开,能避免选错接入方式或提前按不存在的额度安排任务。
怎么在线格式化压缩JS代码并保留原始注释
2026-11-05 09:15:34
生产环境怎么自动移除JS控制台打印日志
2026-11-05 09:07:54
Babel 配置 core-js 完整指南:@babel/preset-env 与 useBuiltIns 设置
2026-11-04 20:32:23
Rollup打包集成Terser进行JS压缩的配置方法
2026-11-03 11:58:27
core-js v3 安装配置:配合 @babel/preset-env 实现按需引入
2026-11-03 11:11:05