JS数组去重:使用Set实现最简代码
深入讲解使用 JavaScript ES6 中的 Set 实现最简代码数组去重的方法,涵盖 [...new Set(arr)] 与 Array.from 的具体写法、底层 SameValueZero 判等原理、针对原始类型与对象引用的适用边界及性能对比。
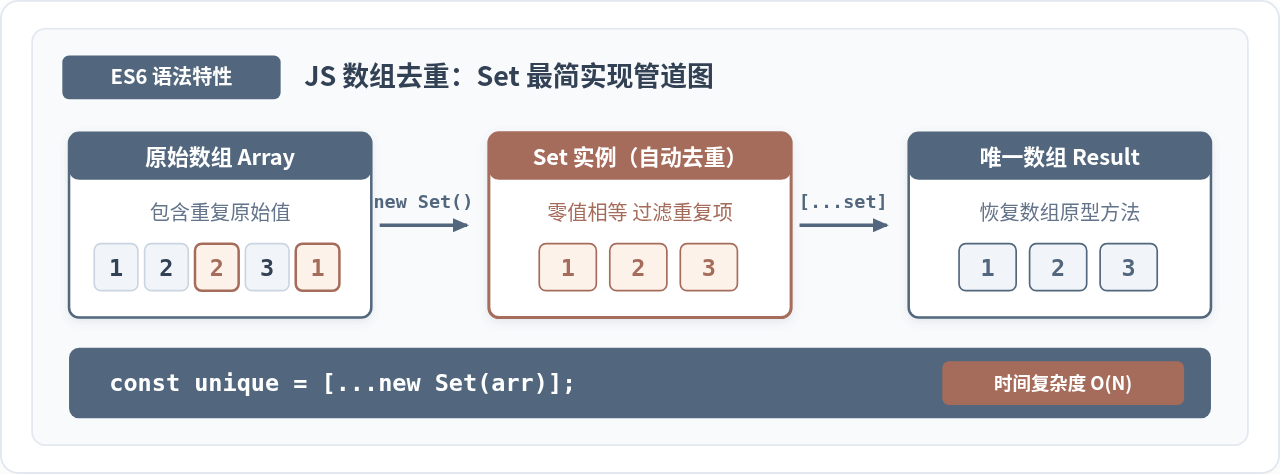
Set 集合结合展开运算符:const unique = [...new Set(arr)];。这行代码在保证代码精简的同时具备接近 O(n) 的高执行效率,是现代前端开发中处理数字、字符串等原始类型数组去重的标准写法。
一、核心写法:一行代码的两种实现形式
在 ES6 出现之前,编写数组去重逻辑通常需要依赖双层 for 循环,或是利用 Array.prototype.filter 与 indexOf 遍历组合。这些写法不仅冗长,而且嵌套遍历的时间复杂度达到 O(n²)。
借助 ES6 原生引入的 Set 数据结构,去重可以精简为一行表达式。在实际工程中,通常有两种形式可供选择:
1. 展开运算符(Spread Operator)形式
// 原始输入数组
const numbers = [1, 2, 2, 3, 4, 4, 5, 1];

// 核心去重代码:一行搞定
const uniqueNumbers = [...new Set(numbers)];

console.log(uniqueNumbers);
// 示例输出: [1, 2, 3, 4, 5]
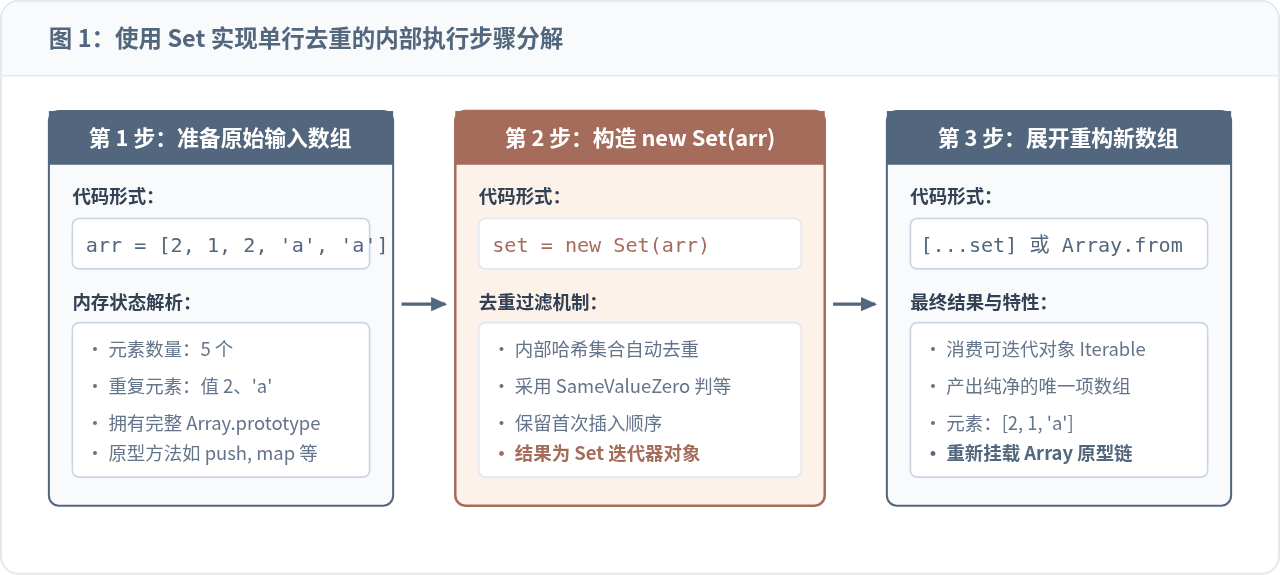
这是最推荐、也是阅读体验最直观的书写方式。它的执行机制非常紧凑:首先执行 new Set(numbers),Set 构造函数在初始化时遍历数组并剔除重复值;紧接着通过方括号 [] 配合展开语法 ... 消费 Set 这个可迭代对象(Iterable),把各个元素直接提取并放置进全新的数组中。
2. Array.from 静态方法形式
const fruits = ['apple', 'banana', 'apple', 'orange'];

// 使用 Array.from 将 Set 转换为真实数组
const uniqueFruits = Array.from(new Set(fruits));

console.log(uniqueFruits);
// 示例输出: ['apple', 'banana', 'orange']
Array.from() 同样能够将 Set 实例转回数组。它的额外优势在于支持传入第二个参数作为 mapFunction,可以在转回数组的同时同步完成映射计算,例如在去重的同时对数值进行倍增:Array.from(new Set(arr), x => x * 2)。
二、底层原理:为什么 Set 能够实现快速去重?
要真正理解这行简短代码,需要弄清两个关键事实:为什么 Set 内部能过滤重复项,以及它是按什么规则判断两个元素“是否相同”。
在 ECMAScript 规范中,Set 是一种类似于集合的有序数据结构,它的关键特征是集合内的每个值都必须唯一,并且在遍历时会严格按照插入顺序排列。当把数组传给 new Set(arr) 时,底层引擎会依次将数组元素加入集合中,如果遇到已经存在的元素则自动忽略。
Set 的判等依据:SameValueZero(零值相等)算法
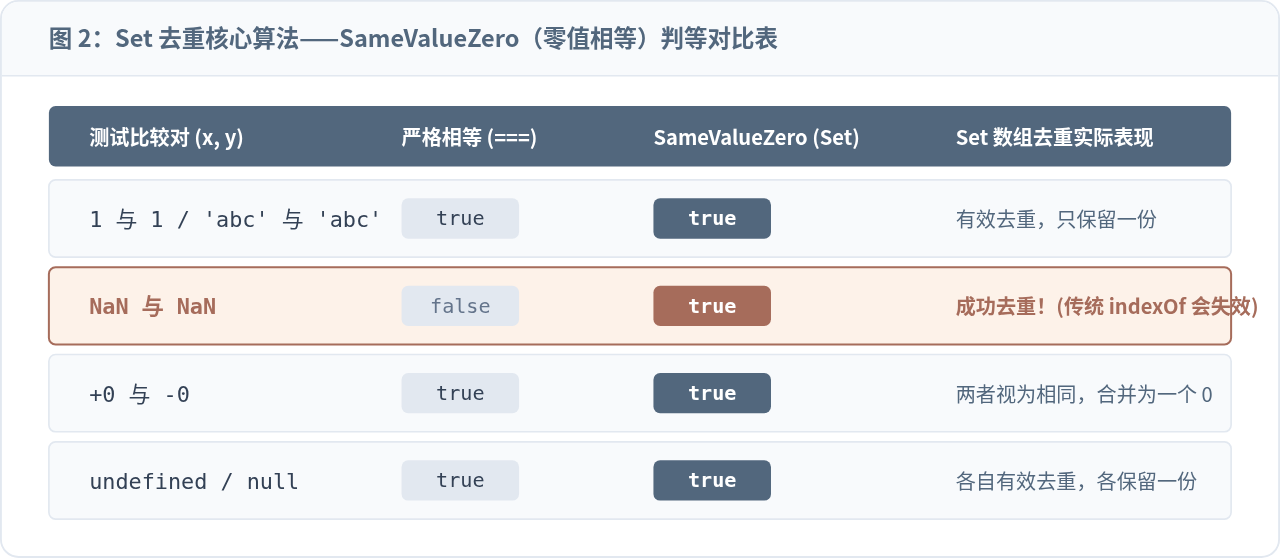
很多开发者容易误以为 Set 内部使用的是普通的严格全等比较(===)。实际上,Set 内部采用的是 ECMAScript 规范定义的 SameValueZero 算法。它与严格全等的表现几乎一致,但在两个特殊值上存在决定性的区别:
-
关于
NaN的比较:在 JavaScript 严格全等中,NaN === NaN的结果是false。这也是传统arr.filter((item, index) => arr.indexOf(item) === index)写法的致命缺陷——因为[NaN].indexOf(NaN)始终返回-1,导致数组里的 NaN 会被直接错误丢弃。而在 Set 采用的 SameValueZero 算法中,NaN与NaN被判定为相互相等,因此多个NaN会被成功合并为单个NaN。 -
关于
+0与-0的比较:在 SameValueZero 规则下,正零与负零视为相等,去重后统一保留一个0。
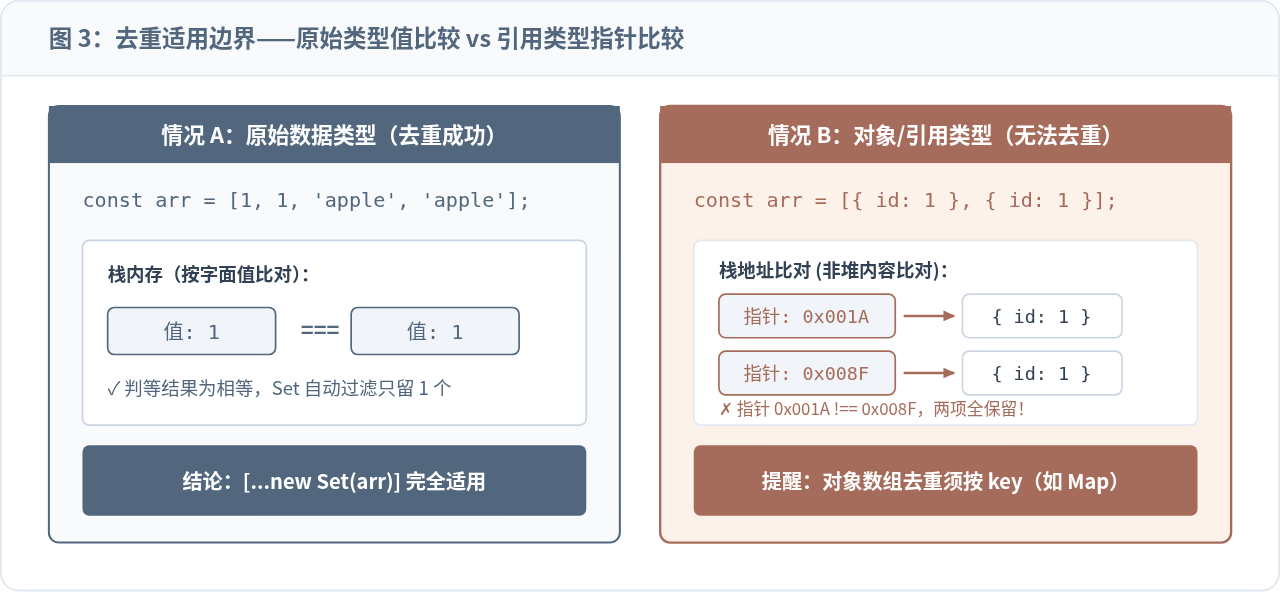
三、适用边界与引用类型的“失效”陷阱
虽然 [...new Set(arr)] 写法极其精炼,但它并不是任何数据结构都能无脑适用的“万能公式”。它有明确的适用边界:
- 完全适用的类型:所有原始数据类型(Primitive Types),包括数字(Number)、字符串(String)、布尔值(Boolean)、BigInt、Symbol,以及
null与undefined。 - 无法直接去重的类型:引用数据类型(Reference Types),即普通对象(Object)、数组(Array)和函数(Function)。
const users = [
  { id: 1, name: 'Alice' },
  { id: 1, name: 'Alice' }
];

const result = [...new Set(users)];
console.log(result.length); // 仍然是 2!并未去除重复项
产生这种现象的根本原因在于 JavaScript 的内存机制:对象在内存中由“栈内存中的引用指针”和“堆内存中的实体内容”组成。每次书写对象字面量 { id: 1 },JavaScript 都会在堆内存中开辟一块新的独立存储空间,栈内存分配到的地址指针截然不同(例如 0x001A 与 0x008F)。
SameValueZero 算法比对的是变量存储的值。对于引用类型,它比较的是栈中的引用指针,而不是深度遍历比对内部属性。因为指针地址不相等,Set 就会判定它们是两个完全不同的元素并完整保留。
对象数组去重的推荐标准解法
如果你的业务场景是对象数组(例如从接口获取的列表),并希望根据唯一键(如 id)进行排重,推荐借助 Map 结合 filter 保持 $O(n)$ 的线性时间开销:
const list = [
  { id: 101, name: '张三' },
  { id: 102, name: '李四' },
  { id: 101, name: '张三(重复项)' }
];

// 利用 Map 记录出现过的 key,仅保留第一次出现的元素
const seen = new Map();
const uniqueList = list.filter(item => !seen.has(item.id) && seen.set(item.id, 1));

console.log(uniqueList);
// 示例输出: [ { id: 101, name: '张三' }, { id: 102, name: '李四' } ]
四、性能分析与日常选型建议
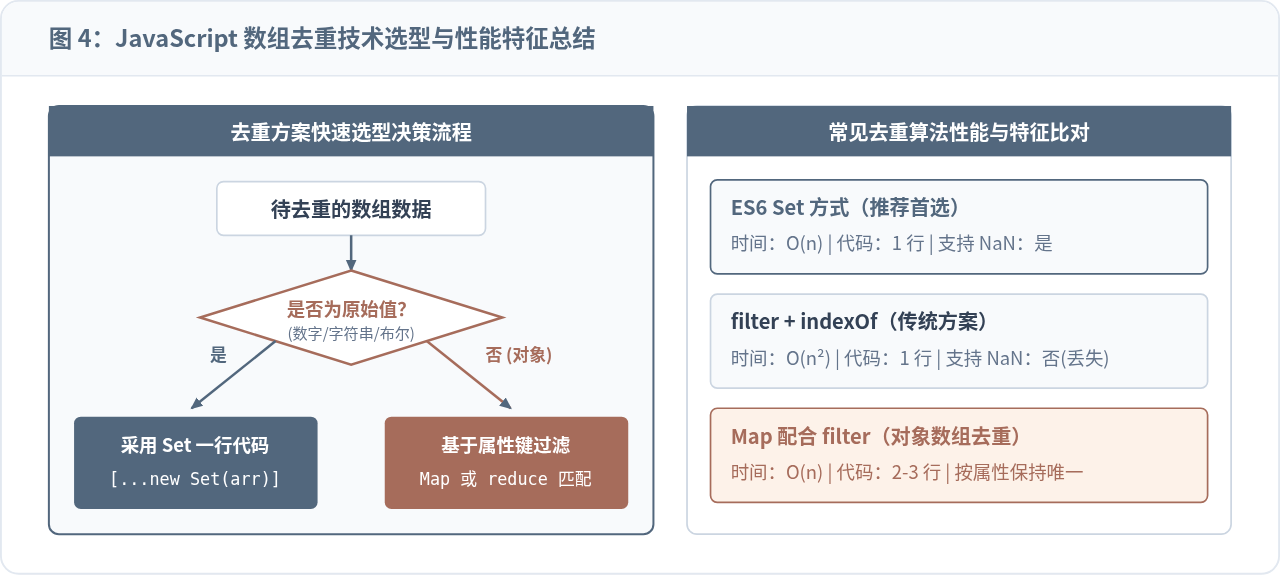
在性能表现上,[...new Set(arr)] 具有显著优势。Set 底层通常基于哈希表(Hash Table)或哈希集合构建,其元素查找和插入的平均时间复杂度均为接近 O(1)。遍历长度为 n 的原始数组并将其插入 Set 的整体时间开销为 O(n),从 Set 展开回数组同样为 O(n),因此整体耗时与数组长度呈线性关系。
相比之下,传统的 filter + indexOf 写法每次循环都会触发一次对原数组的线性扫描,整体时间复杂度为 O(n²)。当数组规模从 100 增至 100,000 时,Set 写法只需几毫秒,而 O(n²) 方案可能会导致页面严重卡顿数秒。
最佳实践总结清单
- 处理基础数据类型(数字、字符串等):坚决优先使用
[...new Set(arr)],写法最短,可读性最好,性能表现最优。 - 需要去重且同步进行转换:选用
Array.from(new Set(arr), fn),一步完成排重与投影映射。 - 包含 NaN 的数据清洗:必须使用 Set,以避免传统
indexOf丢失有效 NaN 值的潜在逻辑 Bug。 - 处理业务对象列表:避免直接对对象数组套用 Set,应使用
Map根据业务唯一标识键(如id或code)进行线性过滤。
Promise和fetch在不支持浏览器中的Polyfill解决方案
2026-11-16 13:42:31
JS定时器回调中this指向丢失怎么解决
2026-11-16 13:19:35
JS用正则表达式实现首字母大写
2026-11-16 13:19:19
为什么前端面试仍推荐研读JavaScript高级程序设计
2026-11-16 13:18:59
JavaScript怎么获取数组中某元素的所有索引位置
2026-11-14 11:05:07
相关标签: