

JS二进制转换出现乱码怎么办?UTF-8编码问题解析
解析JavaScript在进行二进制(ArrayBuffer、Uint8Array、Blob、Buffer)转文本时出现乱码的根源,深入讲解UTF-8变长编码机制、分片截断问题,并提供TextDecoder与StringDecoder的标准解决方案。
String.fromCharCode),或在流式分片读取时截断了 UTF-8 的多字节序列。解决该问题的标准做法是统一使用现代规范的 TextDecoder 或 Node.js 的 string_decoder,并在分块传输中保持解码器状态。
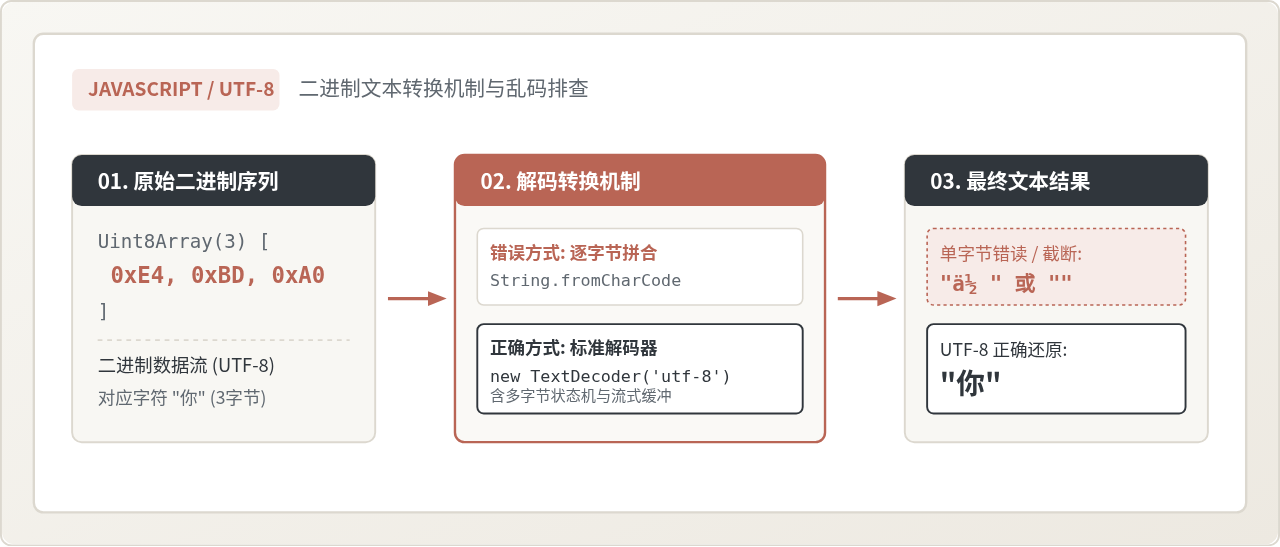
一、乱码现象与 UTF-8 变长编码机制解析
在前端网络请求、WebSocket 通信、文件分片读取或 Node.js 服务端处理二进制流时,转换文本常会遇到两类形态迥异的乱码:
- 形态 A:连续的问号菱形
��。这是 Unicode 标准中的“替换字符”(Replacement Character,编码为U+FFFD)。当解码器在 UTF-8 模式下收到了非法的字节组合,或者一个中文字符原本需要的连续字节在末尾被强行掐断时,解码器无法将其还原为合法字符,便会使用�占位替代。 - 形态 B:生僻的拉丁字符如
ä½ å¥½。这种乱码并不代表数据丢失,相反,底层的 UTF-8 字节是完整且正确的,但程序错误地将每个字节视作一个独立的字符(例如按 ISO-8859-1 或 Windows-1252 编码逐字节映射),将原本属于一个汉字的 3 个字节强行解释成了 3 个西方扩展字符。
理解这两种现象的根源,关键在于掌握 UTF-8 变长字节结构。UTF-8 是一种针对 Unicode 标量值的变长字符编码方案,一个字符可能占用 1 到 4 个字节:
- 1 字节(ASCII 兼容):编码形式为
0xxxxxxx(0x00 ~ 0x7F),包含标准英文字母、数字和常见符号。 - 2 字节:前缀为
110xxxxx 10xxxxxx(0x80 ~ 0x7FF),多用于希腊文、阿拉伯文等。 - 3 字节(绝大部分常用汉字):前缀为
1110xxxx 10xxxxxx 10xxxxxx(0x800 ~ 0xFFFF)。例如汉字“你”的 Unicode 码点是U+4F60,在 UTF-8 下编码为 3 个字节:0xE4 0xBD 0xA0。 - 4 字节(Emoji 与罕见古籍字):前缀为
11110xxx 10xxxxxx 10xxxxxx 10xxxxxx(0x10000 ~ 0x10FFFF)。
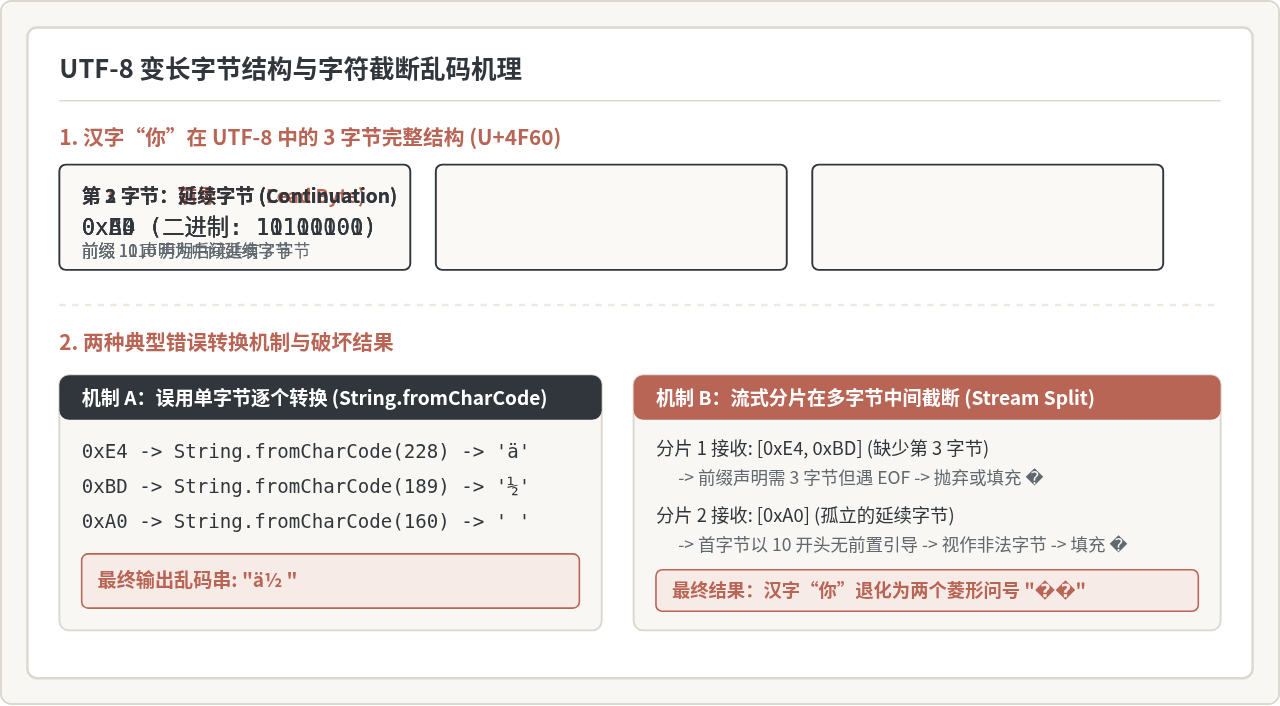
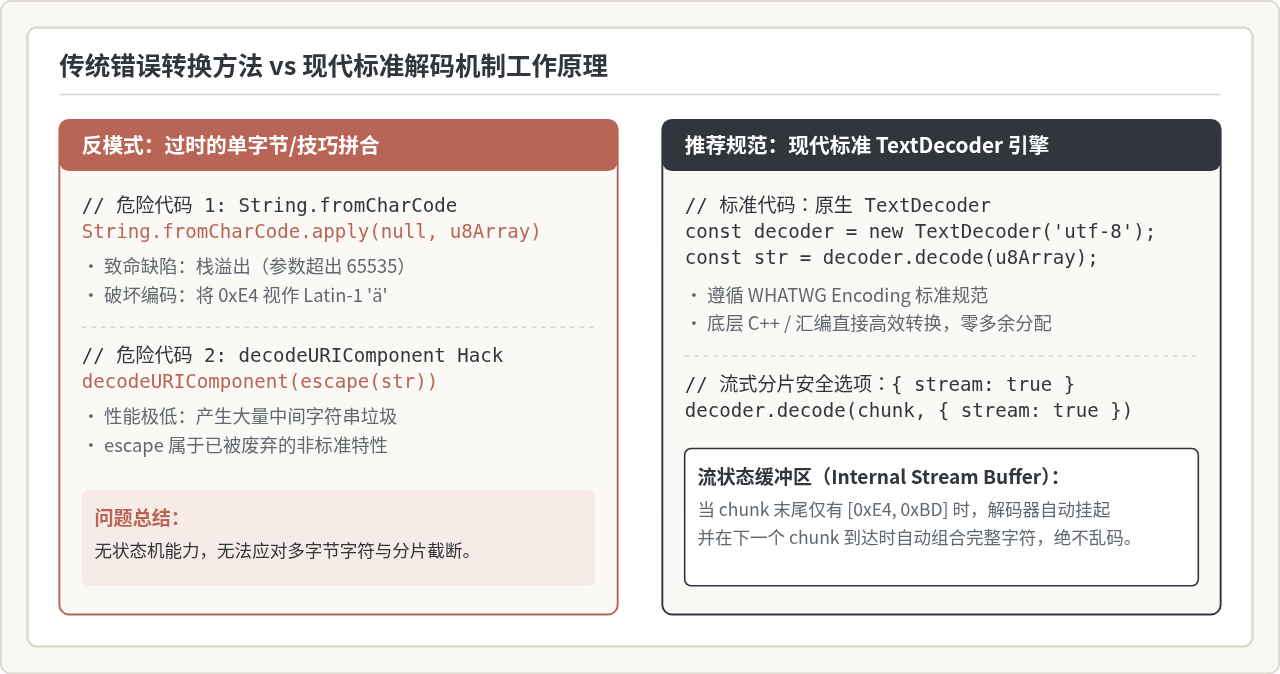
很多早期教程介绍过诸如 String.fromCharCode.apply(null, uint8Array) 或通过 escape/decodeURIComponent 的转换技巧。在纯 ASCII 字符场景下这些写法看似正常,但一旦遇到非英文字符就会彻底崩溃。因为 String.fromCharCode 接收的是 16 位的 UTF-16 代码单元,将单字节数值直接传入,等于强行按单字节映射,从而破坏了 UTF-8 的多字节联合语义。
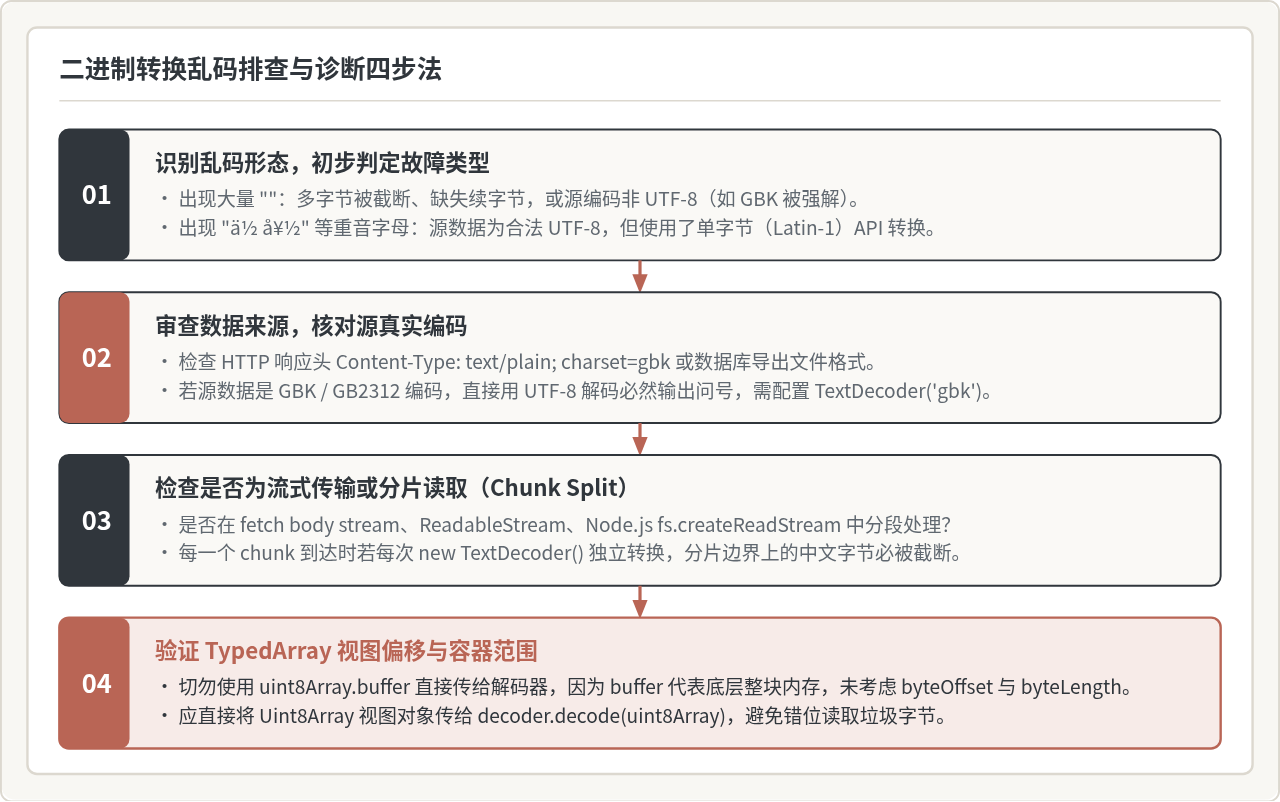
二、二进制转换乱码排查四步法
当遇到 JavaScript 二进制转字符串乱码时,按照以下标准化排查流程,可以在几分钟内定位并排除故障:
1. 查看原始十六进制字节(Hex Dump)
排查的第一步是观察二进制底层到底收到了什么。可以通过简单的辅助函数将 Uint8Array 打印为十六进制:
// 打印二进制数据的前 16 个字节的十六进制形式
function dumpBytes(uint8Array, limit = 16) {
  const hex = Array.from(uint8Array.slice(0, limit))
    .map(b => '0x' + b.toString(16).padStart(2, '0').toUpperCase())
    .join(' ');
  console.log(`[Byte Dump (总长 ${uint8Array.length})]:`, hex);
}

// 示例输出:
// [Byte Dump (总长 6)]: 0xE4 0xBD 0xA0 0xE5 0xA5 0xBD (对应汉字 "你好")
如果打印出的字节是类似 0xC4 0xE3 0xBA 0xC3(双字节结构),这表明源数据不是 UTF-8,而是 GB2312/GBK 编码,此时任何纯 UTF-8 解码器都会报错或出现乱码。
三、标准解决方案与代码实操
1. 浏览器与现代环境标准方案:TextDecoder
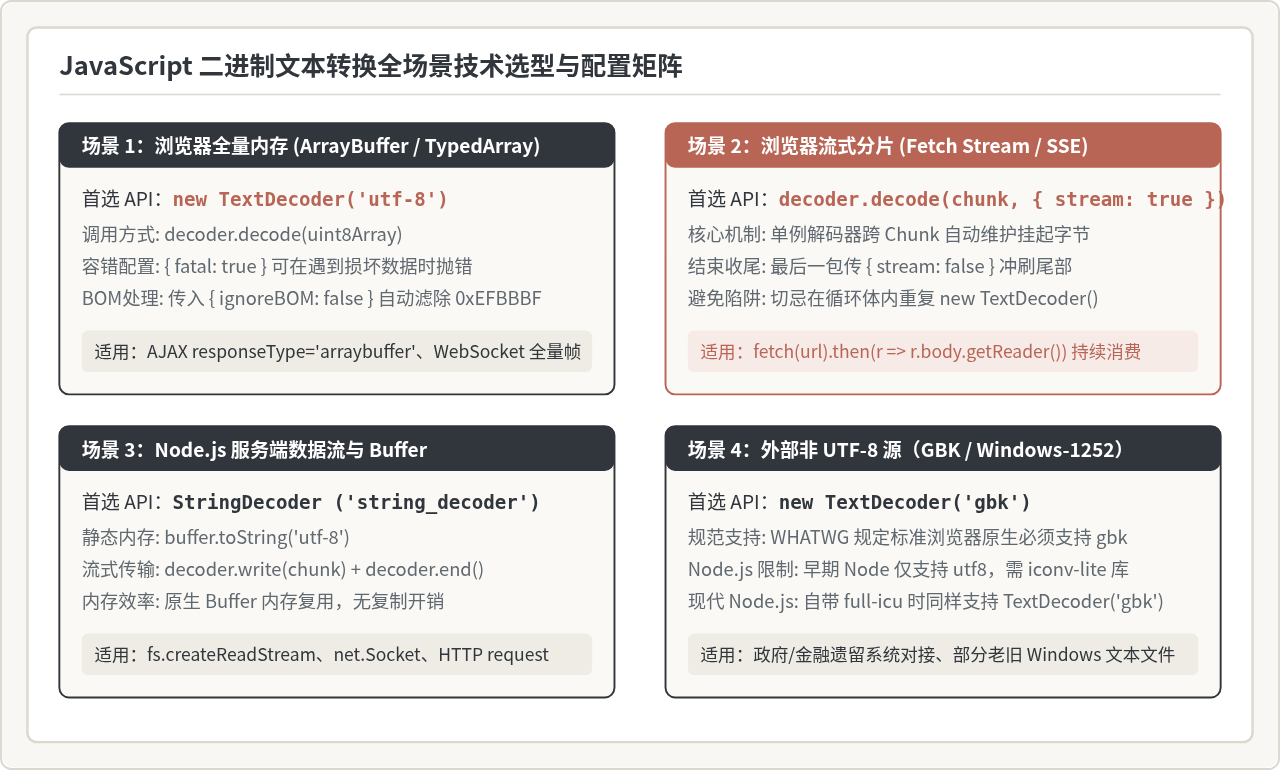
现代浏览器以及 Node.js(v11+)均原生内置了 TextDecoder API,这是目前将 ArrayBuffer 或 Uint8Array 还原为文本的唯一推荐标准方式。
// 基础用法:全量二进制数据转换
const uint8Array = new Uint8Array([0xE4, 0xBD, 0xA0, 0xE5, 0xA5, 0xBD]); // "你好"

// 实例化解码器,默认即为 'utf-8'
const decoder = new TextDecoder('utf-8');
const text = decoder.decode(uint8Array);

console.log(text); // 准确输出:"你好"当使用 subarray 或已有 offset 的 Uint8Array 时,必须直接将 uint8Array 作为参数传给 decode(),绝不能写成 decoder.decode(uint8Array.buffer)。因为 .buffer 返回的是底层分配的整个底层 ArrayBuffer,其可能包含前后其他无用或偏移的字节,从而引发解析错乱。
2. 流式分块传输(Fetch / WebSocket / Stream)防截断实战
在消费流式数据(例如大型模型返回的流式 SSE、分段文件下载或分片读取)时,每一个 chunk 的长度并不保证恰好落在中文字符的 3 字节边界上。若对每个 chunk 独立调用无状态解码,遇到跨 chunk 的汉字就会变成 �。
解决方案是复用同一个 TextDecoder 实例,并在处理中间分片时传入 { stream: true } 参数:
// 模拟流式读取:汉字“你好”被硬性切成两段
// chunk1: [0xE4, 0xBD] (缺了 "你" 的第 3 字节)
// chunk2: [0xA0, 0xE5, 0xA5, 0xBD] ("你" 的第 3 字节 + 完整的 "好")
const chunk1 = new Uint8Array([0xE4, 0xBD]);
const chunk2 = new Uint8Array([0xA0, 0xE5, 0xA5, 0xBD]);

const streamDecoder = new TextDecoder('utf-8');

// 1. 处理第一个分片,声明 stream: true
const part1 = streamDecoder.decode(chunk1, { stream: true });
console.log('Part 1 输出:', JSON.stringify(part1));
// 输出: "" (解码器暂存了前 2 个字节,不盲目输出乱码)

// 2. 处理第二个分片,如果后续还有数据继续 stream: true;若结束则 stream: false
const part2 = streamDecoder.decode(chunk2, { stream: false });
console.log('Part 2 输出:', JSON.stringify(part2));
// 输出: "你好" (解码器将暂存字节与新分片拼接后成功还原)
3. Node.js 服务端专有方案:Buffer 与 string_decoder
在 Node.js 中,如果是全量内存块,可直接使用内置 Buffer.from().toString('utf-8');但如果监听的是 stream.on('data') 事件,则必须使用内置的 string_decoder 模块:
// Node.js 环境
const { StringDecoder } = require('string_decoder');
const decoder = new StringDecoder('utf8');

// 假定 readableStream 是一个读取流
readableStream.on('data', (chunk) => {
  // decoder.write 会自动缓冲不完整的多字节字符
  const text = decoder.write(chunk);
  process.stdout.write(text);
});

readableStream.on('end', () => {
  // 结束时输出剩余缓存(若有)
  const remaining = decoder.end();
  process.stdout.write(remaining);
});
4. 浏览器 Blob 与 File 对象的异步安全转换
对于用户上传的 File 对象或网络下载的 Blob,现代浏览器提供了原生的 Promise 方法,无需手动操作 ArrayBuffer:
// 现代浏览器标准方式:直接调用 blob.text()
async function readBlobAsUtf8(blob) {
  // 内部默认以 UTF-8 规范进行完整解析
  const text = await blob.text();
  return text;
}

// 传统回调兼容方式:FileReader
function readBlobLegacy(blob, callback) {
  const reader = new FileReader();
  reader.onload = () => callback(reader.result);
  reader.readAsText(blob, 'utf-8'); // 显式声明 utf-8 编码
}
四、进阶场景与防御性编程指南
1. 严格校验与错误捕获(fatal 模式)
默认情况下,TextDecoder 遇到非法或破损的字节时,会静默地用 � 替换。如果业务场景对数据完整性有极端要求(例如必须保证文本绝对无损,损坏时立刻报警终止),可在创建解码器时启用 fatal: true:
// 开启严格模式:遇到非法 UTF-8 字节直接抛出 TypeError
const strictDecoder = new TextDecoder('utf-8', { fatal: true });

try {
  // 故意传入一个破坏的 UTF-8 字节流(缺少后续延续字节)
  const brokenBytes = new Uint8Array([0xE4, 0xBD]);
  const result = strictDecoder.decode(brokenBytes);
} catch (err) {
  console.error('检测到损坏或非法的二进制编码,解码终止:', err);
  // err.name === 'TypeError'
}
2. UTF-8 BOM 头的自动过滤
部分 Windows 工具(如老版本记事本)在保存 UTF-8 文件时会附带一个 3 字节的 BOM(Byte Order Mark)头:0xEF, 0xBB, 0xBF。如果直接转换,这个不可见字符会被当成零宽非换行空格(),导致字符串比对或 JSON 解析报错(如 Unexpected token in JSON at position 0)。
TextDecoder 默认参数 ignoreBOM: false 会自动识别并剔除开头的 BOM 标记;若保留默认设置,直接解码即可安全剔除 BOM。
五、自查清单与最佳实践总结
| 检查项 | 反模式 / 错误做法 | 现代推荐做法 |
|---|---|---|
| API 选型 | String.fromCharCode.apply(null, arr) |
统一使用 new TextDecoder('utf-8').decode(arr) |
| 分片流式读取 | 每个 chunk 独立 new TextDecoder().decode() |
复用解码器并传入 { stream: true } |
| TypedArray 切片 | decoder.decode(arr.buffer)(忽略了偏移量) |
直接传视图:decoder.decode(arr) |
| Node.js 管道流 | chunk.toString() 直接在 data 事件中字符串拼接 |
使用 const { StringDecoder } = require('string_decoder') |
| GBK 编码支持 | 用 UTF-8 强行解码后再尝试正则替换 | 声明 new TextDecoder('gbk') 或 Node.js 借助 iconv-lite |
只要理清 UTF-8 变长字节结构与解码器状态机机制,在全量场景坚持使用标准 TextDecoder,在流式场景妥善开启 { stream: true },就能从根本上杜绝二进制转换过程中的乱码问题。
ChatGPT iOS 1.2026.307维护范围与iOS 18.0要求,如何区分客户端和服务功能
2026-11-16 13:35:17
JS获取的时间控件值怎么转换为Date对象或格式化
2026-11-16 13:23:58
langchain-core 1.8.1怎么区分Gateway上下文与进程环境配置
2026-11-16 11:44:07
TensorFold 1.2.9如何复用服务配置并核对API变化
2026-11-16 11:25:58
Google Ads Skills 1.1.1/1.0.3怎样区分查询与有限写入?
2026-11-16 11:08:24







