

Commvault与NVIDIA参考设计计划12月早期发布,AI检索与数据授权有什么区别
解释Commvault Data Activate与NVIDIA NIM、Nemotron Retriever、cuVS及Apache Solr合作的数据治理范围,区分内容、权限、保留期限与2026年12月早期发布、2027年正式可用目标。
把企业内容变得可检索,并不等于让所有用户或智能体永久获得访问。Commvault与NVIDIA在11月10日提出的数据合作,将检索与源内容、保留期限及权限变化的持续治理结合。参考设计目标为2026年12月早期发布和2027年正式可用,具体交付日期尚未公布。
这组技术分别连接哪一部分数据流程
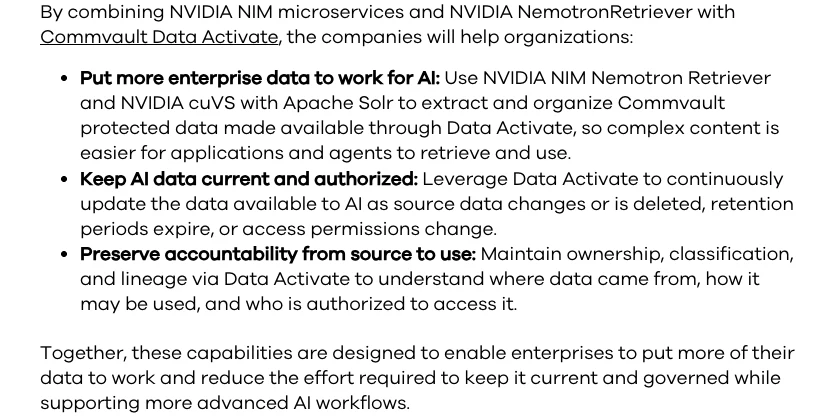
合作组合包括Commvault Data Activate、NVIDIA NIM微服务、Nemotron Retriever,以及与Apache Solr配合的NVIDIA cuVS。公告描述的用途是提取和组织通过Data Activate提供的受保护数据,让复杂内容更容易被AI应用及智能体检索使用。这里关注的是把已有企业数据转化为可治理的AI上下文。
提取、组织与检索属于不同环节,多项技术被纳入合作,也不证明每家企业已经准备好完整运行环境。公告没有提供可直接套用的通用部署参数、GPU配置、性能数字或访问凭据,也未把数据准备等同于训练一套新的基础模型。参考设计的价值与实际项目部署状态应分开理解。
为什么数据变化和访问变化都需要传递
Data Activate计划持续更新AI可用数据,触发条件不只有源文件被修改,还包括源内容删除、保留期限到期以及访问权限改变。一次性导出反映一个时点,后续检索是否仍符合源系统最新状态需要另外判断。内容更新与授权更新需要同时纳入数据管道。
例如,源系统的一份材料仍然存在,但访问权限已经收紧,“文件未删除”就不能作为继续向原先所有用户提供检索的依据;反过来,权限没有变化也不证明内容仍在保留期限内。这些条件来自公告的治理目标,并不代表已公开一个适用于全部系统的更新延迟保证。
检索结果为什么还需要治理上下文
合作强调通过Data Activate保留数据所有权、分类和血缘信息,用来说明数据来自哪里、可如何使用,以及谁获准访问。内容检索结果与来源治理信息结合,才能为企业AI流程提供可追责的上下文。仅有一段可以被模型读懂的文本,还不足以表达其全部授权与使用条件。
这些信息服务于治理,不等于每个生成答案都被自动证明正确。来源可追踪、权限合规与回答质量各有判断依据;将受保护数据用于检索,也不意味着AI应用可以绕过原本的访问边界,或把所有历史保留内容永久开放给任何智能体。
12月早期版本与2027年正式可用怎么理解
官方针对SaaS和软件参考设计使用的是early release目标,时间为2026年12月,general availability目标为2027年。早期发布描述产品阶段,不能翻译为“12月初交付”;2027年也没有被指定到某个月或某一天。企业安排验证、采购和集成时,应保留路线目标与实际可用状态的区别。
这次合作侧重AI数据准备与治理,和AgentRecover的智能体恢复职责不同。参考设计将哪些数据变得可检索、如何随权限变化更新,与事故后如何恢复受影响系统,是不同问题。公告另预告11月18日SHIFT Virtual进一步说明,这项活动本身不代表参考设计已经正式发布。
Nod 0.7.4与0.7.5怎样区分本地模型等待、跨模型历史和上下文恢复?
2026-11-14 21:04:42
AI智能体和AI助手有什么区别?从自主性与任务规划看本质差异
2026-11-08 20:44:33
IntelliJ IDEA中通义灵码插件的常用快捷键与高效技巧
2026-11-07 23:31:41
Google Veo 使用教程:从文本提示到高质量视频生成的步骤
2026-11-07 16:38:43
Stable Diffusion提示词生成器与常用关键词查询网站推荐
2026-11-07 15:04:22