js字符串转数组ES2026Uint8Array.fromHex新API
深入解析 ES2026 标准新特性 Uint8Array.fromHex API,详解十六进制字符串转换为 Uint8Array 字节数组的语法规则、边界校验、执行步骤及与传统方案的深度对比。
在 JavaScript 中将十六进制字符串转为字节数组,长期以来只能依赖手动遍历截取或借助环境特定库。随着 ECMAScript 规范将 Uint8Array to/from base64 and hex 提案正式纳入标准(ES2026),原生静态方法 Uint8Array.fromHex() 为前端与服务端提供了统一、高性能且具备严格校验的解决方案。本文将详细讲解该 API 的语法使用、解析机制、错误排查步骤,并对照传统循环方案分析核心差异。
一、Uint8Array.fromHex() 的核心功能与基本语法
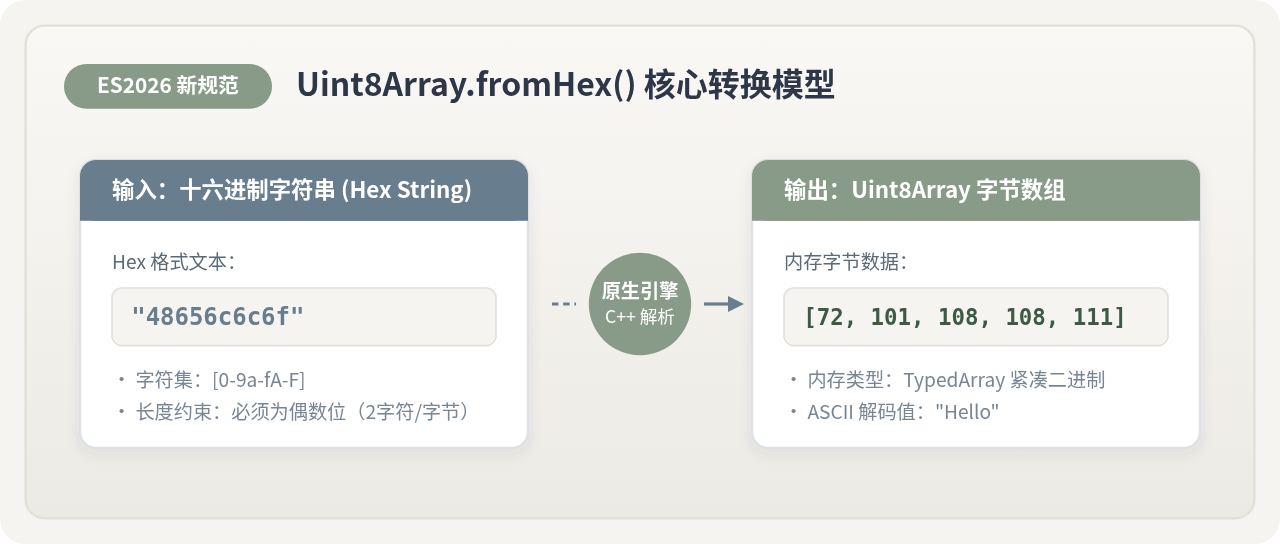
在处理密码学签名、哈希值展示、网络二进制协议封包时,十六进制字符串(Hex String)是最常用的编码形式之一。过去开发者想要将如 "48656c6c6f" 的字符串转换为字节数组,往往需要书写循环或正则表达式将其两两拆分,再通过 parseInt 转化为数字。
Uint8Array.fromHex() 作为标准原生静态方法,直接接收一个十六进制字符串并返回对应的 Uint8Array 实例,无需任何中间包装或第三方辅助库。
基本语法与签名
Uint8Array.fromHex(hexString);- 参数
hexString:必须为一个合法的十六进制字符串。有效字符包含数字0-9以及英文字母a-f(大小写均合法)。 - 返回值:返回一个新构建的
Uint8Array实例,数组长度严格等于字符串字符数的一半(即hexString.length / 2)。
基础代码示例
// 示例 1:基础十六进制字符串转字节数组
const bytes = Uint8Array.fromHex("48656c6c6f");
console.log(bytes);
// 示例输出:Uint8Array(5) [72, 101, 108, 108, 111]

// 示例 2:支持大写字母及混合大小写
const mixedBytes = Uint8Array.fromHex("4A4b4C");
console.log(mixedBytes);
// 示例输出:Uint8Array(3) [74, 75, 76]

// 示例 3:空字符串处理
const empty = Uint8Array.fromHex("");
console.log(empty.length);
// 示例输出:0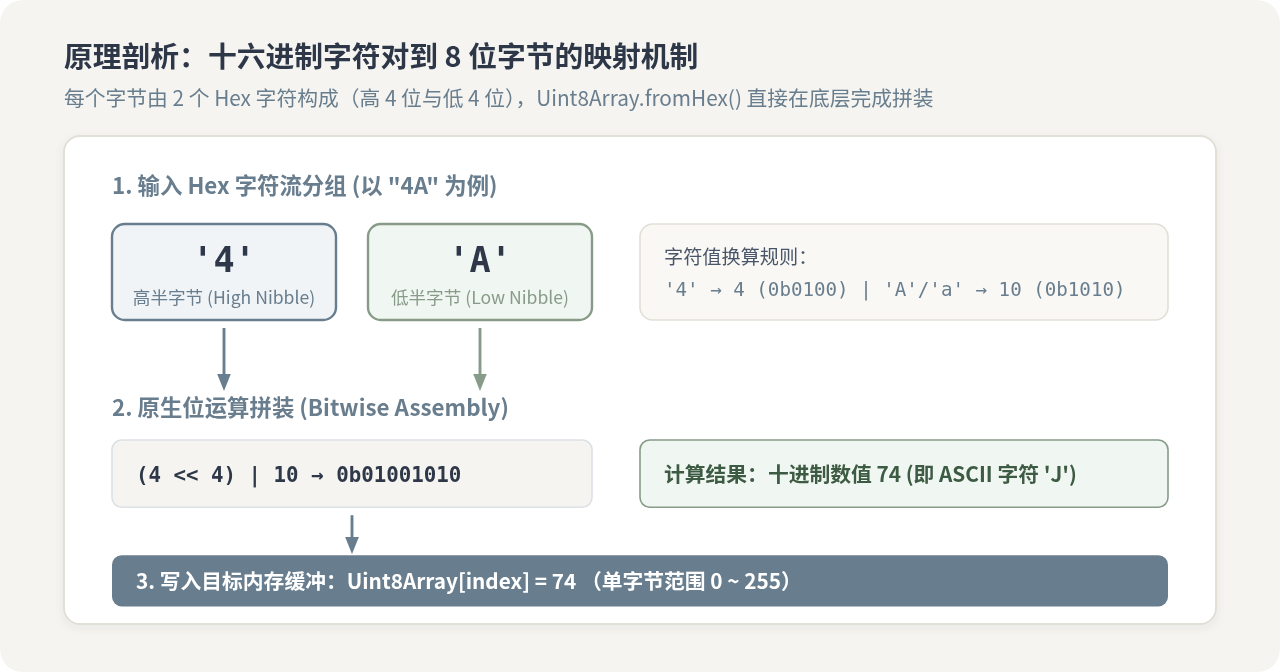
每个字节由 8 个二进制位(bit)构成,数值范围为 0 到 255。一个十六进制字符恰好能表示 4 个二进制位(半字节 Nibble),因此必须由两个连续的十六进制字符组成一个完整的字节(高 4 位与低 4 位组合)。Uint8Array.fromHex() 在底层直接执行位移与按位或操作,单次扫描即可完成目标内存的填充。
二、标准化操作步骤与双向转换链路
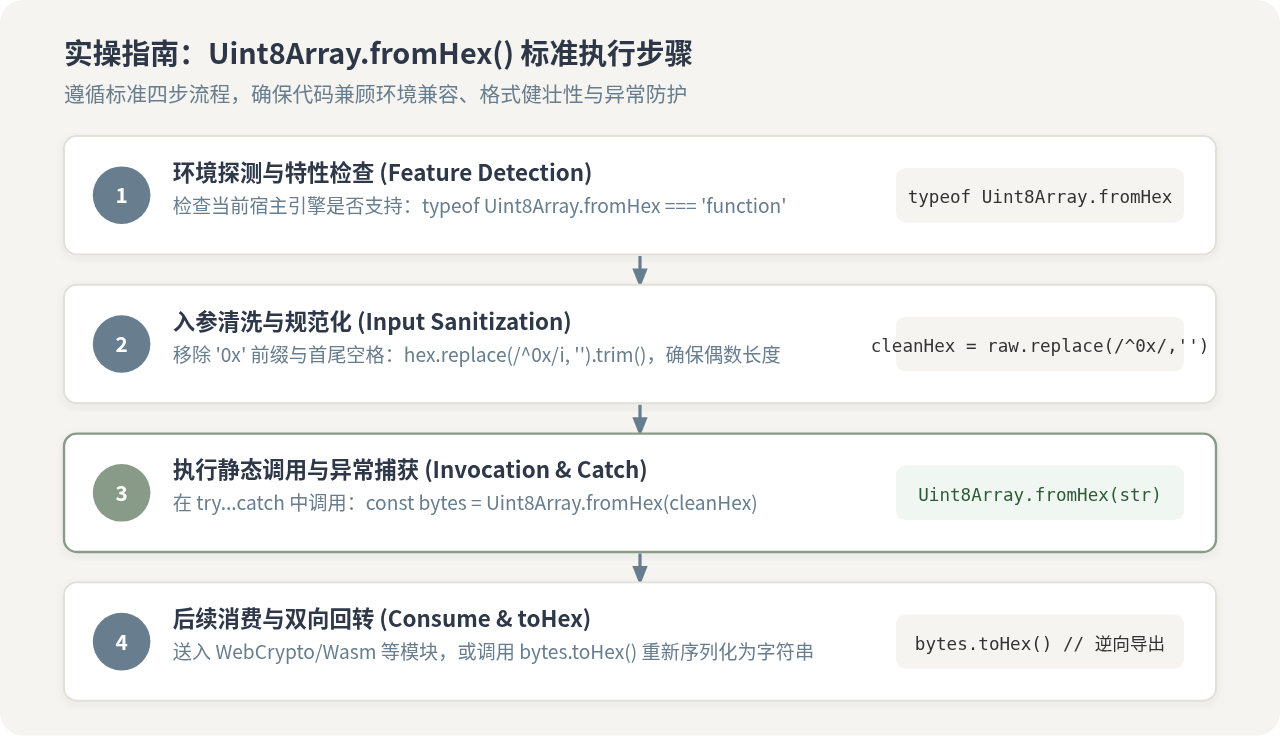
在实际工程落地中,为了保证跨环境健壮性并规避脏数据输入,建议遵循以下四个标准操作步骤完成转换任务。
步骤一:运行环境特性检查
虽然现代浏览器(如 Chrome 128+、Firefox 133+、Safari 18.2+)以及 Node.js 22+ 已经全面支持该特性,但在尚未升级的旧版运行环境中仍需做前置探测。
const isSupported = typeof Uint8Array.fromHex === 'function';
if (!isSupported) {
  // 说明:当前宿主尚未内置该 API,可使用 Polyfill 或回退处理
}
步骤二:入参清洗与规范化
在很多业务中,十六进制数据往往带有 "0x" 前缀,或者携带首尾空格与换行符。Uint8Array.fromHex() 遵循严格解析规范,传入 "0x" 前缀会被当做非法字符直接抛出错误。因此在传入前,应先进行标准化清洗。
function sanitizeHex(input) {
  let cleaned = input.trim();
  if (cleaned.startsWith("0x") || cleaned.startsWith("0X")) {
    cleaned = cleaned.slice(2);
  }
  return cleaned;
}
步骤三:执行静态调用并捕获异常
根据 ECMAScript 规范,任何长度不对齐或包含非法字符的情况都会同步抛出 SyntaxError。在调用处应包裹错误捕获逻辑,避免未捕获异常导致程序崩溃。
function safeHexToBytes(rawHex) {
  const hex = sanitizeHex(rawHex);
  try {
    return Uint8Array.fromHex(hex);
  } catch (err) {
    if (err instanceof SyntaxError) {
      console.error("十六进制字符串格式不合法:", err.message);
    }
    throw err;
  }
}
步骤四:与 Uint8Array.prototype.toHex() 配合实现双向回转
与 fromHex() 同期标准化的还有实例方法 Uint8Array.prototype.toHex(),两者配合构成了完整的十六进制双向编解码闭环:
// 字符串转字节数组
const raw = "deadbeef";
const array = Uint8Array.fromHex(raw);

// 字节数组重新导出为小写十六进制字符串
const restored = array.toHex();
console.log(restored);
// 示例输出:"deadbeef"
三、严格的校验机制与边界错误排查
了解 Uint8Array.fromHex() 的边界限制对于排查线上故障至关重要。与宽松解析函数不同,该 API 遵循“非零即整、零容忍错误”的原则。
如果传入的字符串长度不能被 2 整除(例如
"abc" 长度为 3),引擎会立即抛出 SyntaxError。因为一个未配对的孤立字符无法表达一个完整字节。如果数据源存在左侧缺零的情况,必须先补齐前导 '0'。
try {
  Uint8Array.fromHex("abc");
} catch (e) {
  console.log(e.name);    // "SyntaxError"
  console.log(e.message); // 示例:"String must have an even number of hexadecimal digits"
}字符串中包含任何除
[0-9a-fA-F] 以外的字符,包括空格、换行、标点符号、'g'~'z' 字母等,均会触发 SyntaxError。与 parseInt 会自动跳过或中途截断的行为不同,fromHex 拒绝解析不完整数据。
try {
  // 包含非 hex 字符 'z'
  Uint8Array.fromHex("48656c6c6f7a");
} catch (e) {
  console.log(e.name); // "SyntaxError"
}
四、新原生 API 与传统方案的关键差异对比
在 ES2026 规范落地前,社区主要采用手动循环截取或正则表达式匹配两种模式。将两者置于相同输入条件下,其在架构设计、内存消耗与校验行为上存在显著差异。
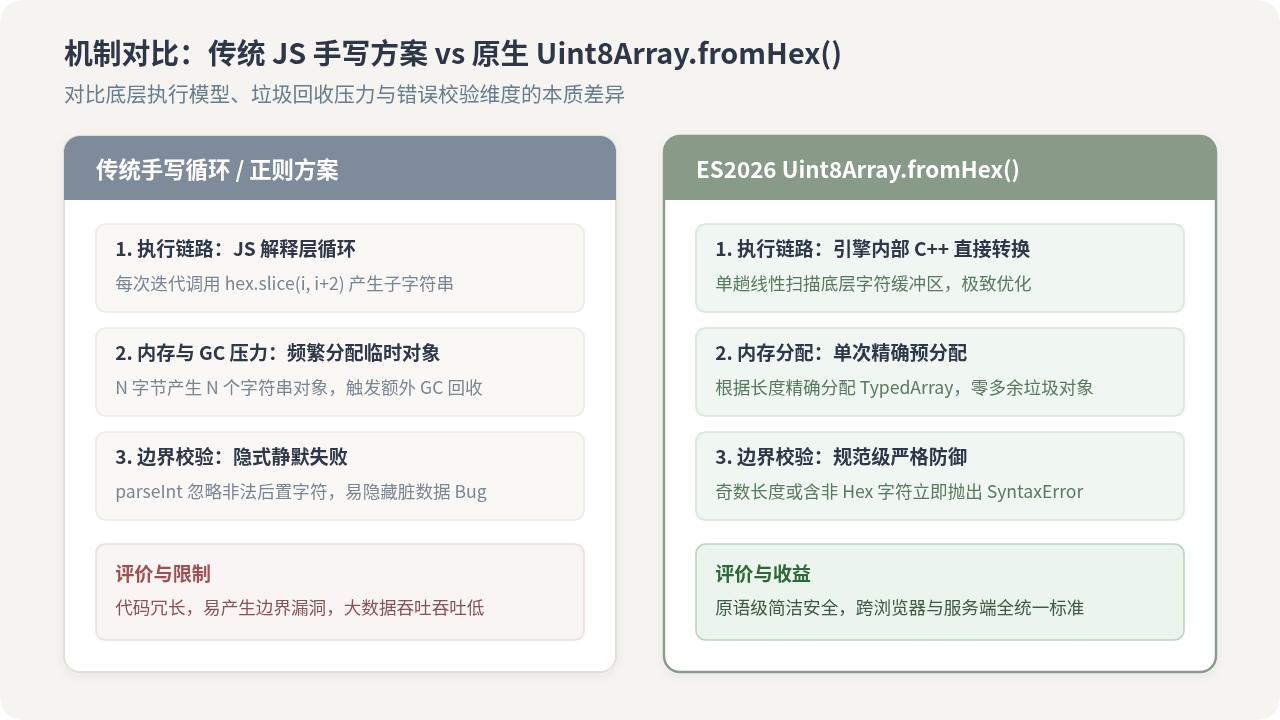
代码实现对比
// 传统方案:循环 + slice + parseInt
function legacyHexToBytes(hex) {
  if (hex.length % 2 !== 0) throw new Error("Invalid length");
  const len = hex.length / 2;
  const bytes = new Uint8Array(len);
  for (let i = 0; i < len; i++) {
    // 每次循环截取创建新子字符串,调用 parseInt
    bytes[i] = parseInt(hex.slice(i * 2, i * 2 + 2), 16);
  }
  return bytes;
}

// 新标准方案:单行原生调用
const modernBytes = Uint8Array.fromHex(hex);
关键差异深度剖析
| 比较维度 | 传统手写循环 / 正则方案 | ES2026 Uint8Array.fromHex() |
|---|---|---|
| 执行效率 | 解释层循环,耗时长,大数据下性能随长度线性下降严重 | 引擎内部 C++ 直接遍历处理,利用 CPU 指令集优化,性能大幅提升 |
| 内存与 GC 压力 | N 字节产生 N 个中间子字符串,增加 V8 堆内存碎片与垃圾回收频率 | 单次精确预分配目标 TypedArray 缓冲区,零中间临时对象创建 |
| 字符校验行为 | parseInt 宽松容错,如 parseInt("0x", 16) 隐式返回 0,易隐藏脏数据 |
规范强制全字符匹配,遇非法字符立即抛出精准的 SyntaxError |
| 规范与维护性 | 各项目手写逻辑不一,容易漏查奇数长度等边界情况 | ECMAScript 原生内置标准,API 签名简洁统一,免去工具函数维护 |
五、典型应用场景与兼容性回退
Uint8Array.fromHex() 的引入直接简化了前端与 Node.js 现代服务端的诸多关键业务管道。
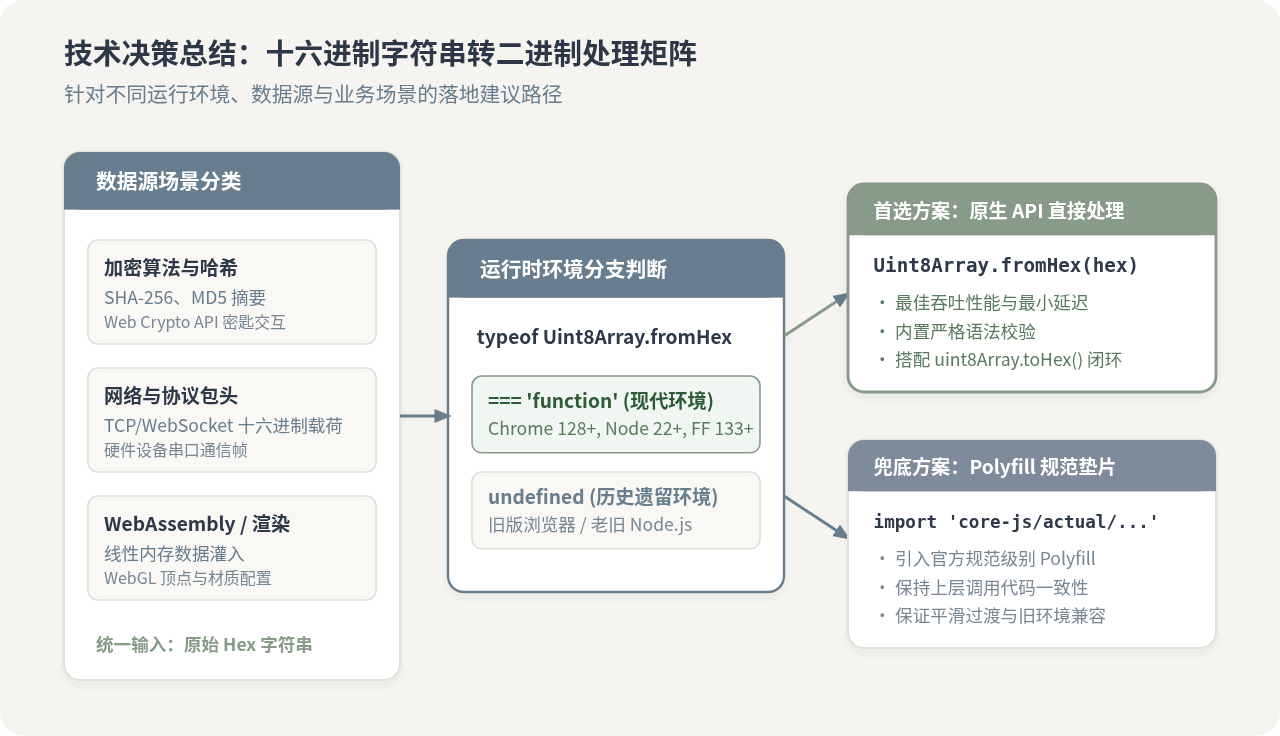
场景一:Web Crypto API 密钥与哈希比对
在进行 HMAC 校验或密码学加解密时,接口通常要求传入 BufferSource(即 ArrayBuffer 或 TypedArray)。借助该 API,可直接将存储在数据库或接口下发的 Hex 签名转化为可用载荷:
const rawKeyHex = "a1b2c3d4e5f60718293a4b5c6d7e8f90";
const keyData = Uint8Array.fromHex(rawKeyHex);

// 直接传入 crypto.subtle 导入密钥
const cryptoKey = await window.crypto.subtle.importKey(
  "raw",
  keyData,
  { name: "HMAC", hash: "SHA-256" },
  false,
  ["sign", "verify"]
);
场景二:旧环境兼容垫片(Polyfill)
对于需要兼容旧版运行时(如老版本 Electron 或低版本移动端 WebView)的项目,推荐引入成熟规范垫片包 core-js,或挂载轻量防御性 Polyfill:
if (!Uint8Array.fromHex) {
  Uint8Array.fromHex = function (hex) {
    if (typeof hex !== "string") {
      throw new TypeError("Argument must be a string");
    }
    if (hex.length % 2 !== 0) {
      throw new SyntaxError("Hex string length must be even");
    }
    const length = hex.length / 2;
    const result = new Uint8Array(length);
    for (let i = 0; i < length; i++) {
      const byteHex = hex.slice(i * 2, i * 2 + 2);
      if (!/^[0-9a-fA-F]{2}$/.test(byteHex)) {
        throw new SyntaxError("Invalid hexadecimal characters");
      }
      result[i] = parseInt(byteHex, 16);
    }
    return result;
  };
}js字符串怎么用正则转数组split(/,/)
2026-11-13 20:55:21
js字符串转数组Intl.Segmenter按字形分割
2026-11-13 19:07:57
js字符串转数组数字变成字符串问题
2026-11-13 18:51:39
js字符串怎么转数组split空字符串方法
2026-11-13 14:53:38
ES6新增JavaScript数组方法:includes、find和flat使用指南
2026-11-13 12:17:06