js字符串怎么转数组处理emoji不拆分乱码
详细讲解在JavaScript中将包含emoji表情的字符串转为数组时避免乱码的有效方法,深入分析UTF-16编码与代理对机制,对比split、Array.from与Intl.Segmenter在处理复杂emoji时的实际表现与最佳实践。
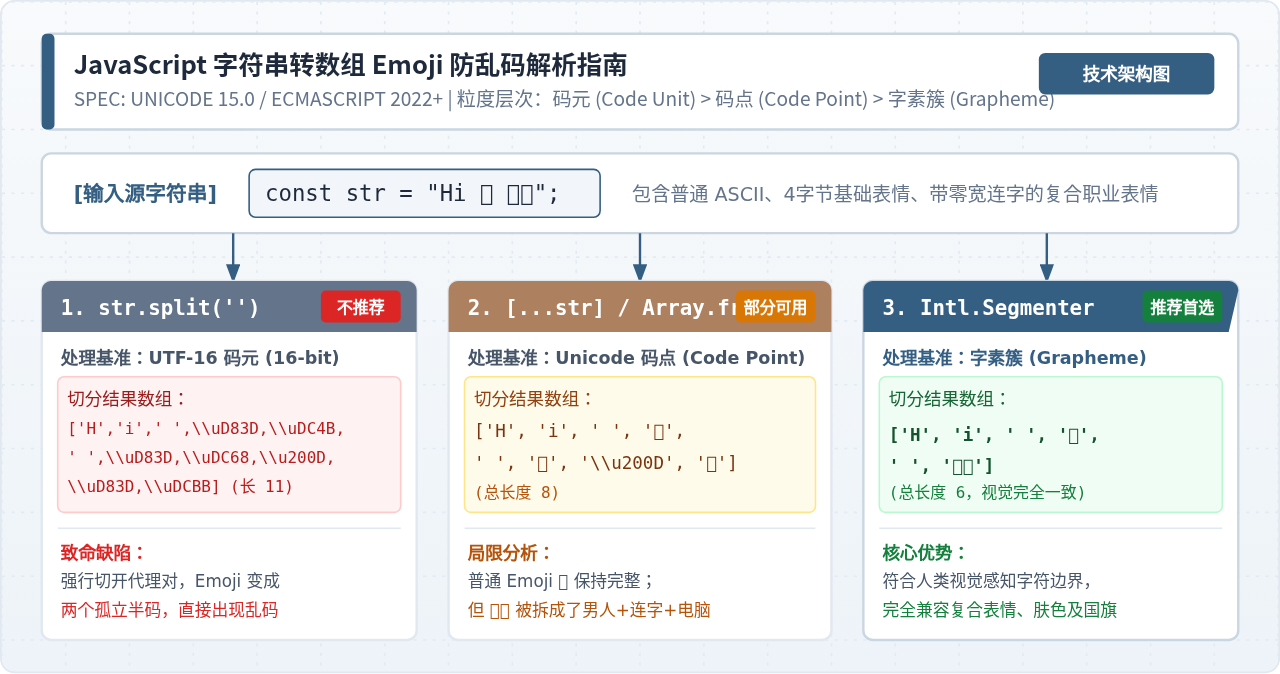
str.split('') 切分包含 Emoji 表情的字符串,经常会出现表情被劈裂成 \uD83D、\uDE0A 等孤立半码,在控制台或网页上直接显示为问号乱码(如 或空方块)。导致这一现象的根源在于:JavaScript 字符串底层采用 UTF-16 编码,单字符只能容纳 16 位的“码元(Code Unit)”,而大部分 Emoji 均超出了 16 位范围,属于由一对码元组成的“代理对(Surrogate Pair)”,甚至是由多个码点借助“零宽连字符(ZWJ)”拼合而成的复合表情。针对单体基础 Emoji,使用 ES6 展开运算符 [...str] 或 Array.from(str) 即可按 Unicode 码点安全拆分;若要应对包含肤色、性别、职业以及家庭等复合 Emoji,推荐使用现代原生标准 Intl.Segmenter 按视觉字素簇(Grapheme Cluster)进行零损坏转换。
一、为什么常规 split('') 会导致 Emoji 乱码
要彻底解决 Emoji 乱码,首先需要了解 JavaScript 字符串在内存中的底层存储方式。ECMAScript 规范明确规定:JavaScript 字符串是由一系列 16 位无符号整数单元组成的序列,每一个 16 位单元被称为一个码元(Code Unit)。
在 Unicode 标准诞生之初,世界各国的常用字符都位于编号 U+0000 到 U+FFFF 之间的区域,被称为基本多语言平面(BMP,Basic Multilingual Plane)。在这个区间内,一个码元(16 位)正好对应一个字符,例如英文 'A'(0x0041)或中文字符 '你'(0x4F60)。
然而随着 Emoji 与各类生僻古文字被收入 Unicode,字符数量迅速突破了 16 位的上限(65536 种可能),延伸到了辅助平面(Supplementary Planes,编号可达 U+10FFFF)。为了让现有的 UTF-16 体系能够容纳这些 21 位的码点,Unicode 专门预留了一段称为“代理区(Surrogate Code Points)”的内存区间:
- 高位代理(High Surrogate):数值范围在
0xD800 ~ 0xDBFF之间。 - 低位代理(Low Surrogate):数值范围在
0xDC00 ~ 0xDFFF之间。
任何一个辅助平面的字符,在 UTF-16 下都必须通过“一个高位代理 + 一个低位代理”组成的一对 32 位结构来存储,这被称为代理对(Surrogate Pair)。
// 示例:笑脸 Emoji 😊 的真实存储情况
const emoji = "😊";

console.log(emoji.length);
// 输出: 2 (注意:这里返回的是 UTF-16 码元数量,而不是视觉字符数)

console.log(emoji.charCodeAt(0).toString(16));
// 输出: "d83d" (高位代理码元)

console.log(emoji.charCodeAt(1).toString(16));
// 输出: "de0a" (低位代理码元)
当执行 str.split('') 时,JavaScript 引擎会严格按照“每个 16 位码元切一刀”的逻辑执行分割。它并不知道 0xD83D 和 0xDE0A 是一个不可分割的整体,结果就把这对亲密配合的代理对一刀两断:
// 错误示范:使用 split('')
const str = "Hi 😊";
const brokenArr = str.split("");

console.log(brokenArr);
// 示例输出: ['H', 'i', ' ', '\uD83D', '\uDE0A']

console.log(brokenArr[3]);
// 输出: "" (孤立的高位代理无法被字库渲染,显示为 Unicode 替换字符 U+FFFD)
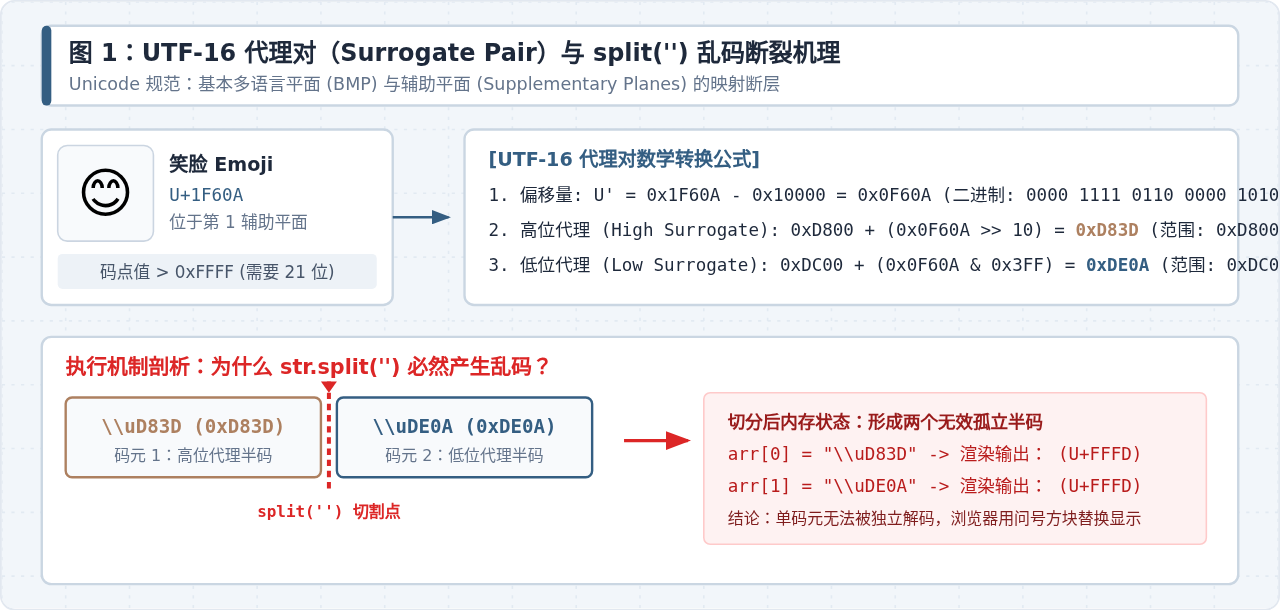
split('') 切分字符串。
二、方案一:使用展开运算符或 Array.from()(码点级安全)
ES6(ECMAScript 2015)在底层为字符串新增了迭代器协议(String Iterator)。字符串迭代器能够识别 UTF-16 的高低位代理对,自动将它们拼合为一个完整的 Unicode 码点(Code Point) 后再吐出。
基于这一特性,我们可以使用 [...str](展开运算符)或 Array.from(str) 将字符串安全转为数组:
// 推荐用法(基础场景):展开运算符与 Array.from
const text = "点赞👍 好运🎉";

// 方法 1:展开运算符
const arr1 = [...text];
console.log(arr1);
// 示例输出: ['点', '赞', '👍', ' ', '好', '运', '🎉']

// 方法 2:Array.from
const arr2 = Array.from(text);
console.log(arr2);
// 示例输出: ['点', '赞', '👍', ' ', '好', '运', '🎉']
可以看到,在 arr1 中,'👍' 和 '🎉' 均作为一个完整的单项存在,没有被切成两半,也不会出现任何乱码符号。
展开运算符的局限性:复合 Emoji 仍会被拆散
[...str] 只能解决“单码点 Emoji”的拆分问题。但随着 Unicode 标准的发展,现代手机与操作系统中充斥着由多个码点组合而成的复合 Emoji:
- 零宽连字符组合(ZWJ Sequence):例如程序员表情
👨💻,它是由“男人👨(U+1F468)”、不可见的“零宽连字符\u200D”以及“笔记本电脑💻(U+1F4BB)”三个独立码点合并渲染而成的。 - 肤色与性别修饰符:例如
👍🏽是由基础大拇指加上菲茨帕特里克肤色修饰符(U+1F3FD)合成的。 - 国家与地区旗帜:例如
🇨🇳是由两个区域指示符号\uD83C\uDDE8与\uD83C\uDDF3拼接显示而成的。
如果对复合 Emoji 使用展开运算符,虽然不会产生生僻乱码,但它会把一个视觉上的整体拆解成多个离散的小零件:
// 局限性演示:展开运算符处理复合 Emoji
const dev = "👨💻";
console.log([...dev]);
// 示例输出: ['👨', '\u200D', '💻'] (原本一个视觉表情被拆成了 3 项!)
const family = "👨👩👧👦";
console.log([...family]);
// 示例输出: ['👨', '\u200D', '👩', '\u200D', '👧', '\u200D', '👦'] (被拆成了 7 项!)
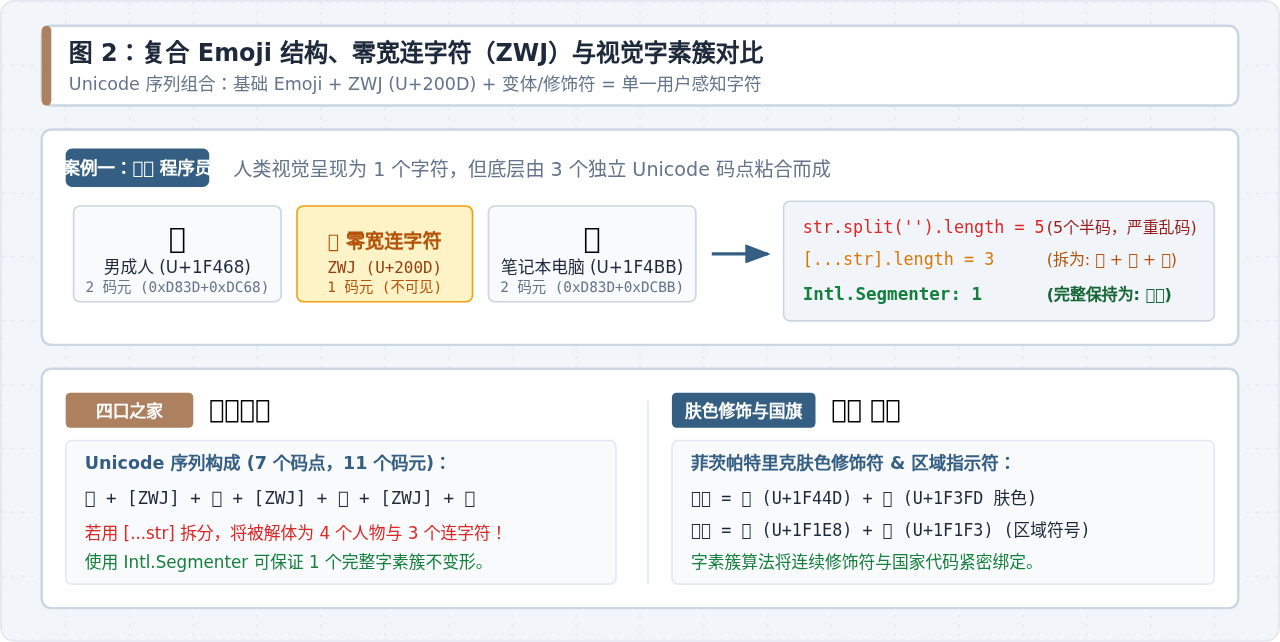
如果在字数统计、逐字打字机动画、验证码输入或截断摘要等交互中,把 👨💻 拆成 ['👨', '\u200D', '💻'],用户就会在界面上看到半个表情甚至奇怪的零宽字符。这引出了我们最推荐的原生解决方案——按字素簇拆分。
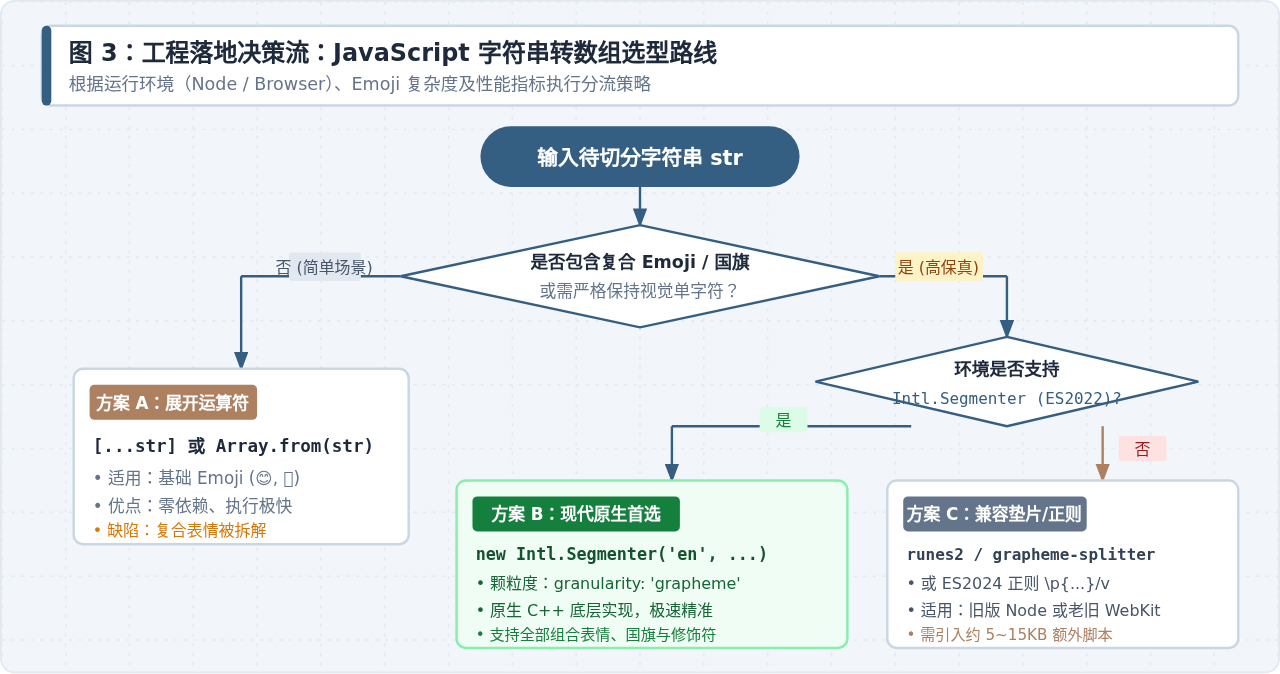
三、方案二:使用现代原生 Intl.Segmenter(字素簇级完美解析)
在 Unicode 术语中,用户在屏幕上直观看到的、无论底层由多少个码点构成的“单一书写单元”,被称为字素簇(Grapheme Cluster)。
ECMAScript 2022 正式引入了国际化分词接口 Intl.Segmenter。它不仅能够处理单词、句子的自然语言分割,还能在指定 granularity: 'grapheme' 时,严格依据 Unicode 文本分段规则(UAX #29)识别出真正的视觉字符边界。
标准用法与通用函数封装
使用 Intl.Segmenter 将字符串转为无乱码数组的最简做法如下:
/**
* 将字符串转为字符数组(完美支持全部基础 Emoji、复合 Emoji、国旗及变体符号)
* @param {string} str 待转换的原字符串
* @returns {string[]} 视觉字符数组
*/
function stringToGraphemes(str) {
if (!str) return [];
// 实例化字素分词器,设置粒度为 grapheme
const segmenter = new Intl.Segmenter('en', { granularity: 'grapheme' });
const segments = segmenter.segment(str);
// 通过 Array.from 遍历抽取 segment 属性
return Array.from(segments, item => item.segment);
}
// 验证测试
const complexText = "Hi👋 研发👨💻 家庭👨👩👧👦 肤色👍🏽 旗帜🇨🇳";
const result = stringToGraphemes(complexText);
console.log(result);
/*
示例输出:
[
'H', 'i', '👋', ' ',
'研', '发', '👨💻', ' ',
'家', '庭', '👨👩👧👦', ' ',
'肤', '色', '👍🏽', ' ',
'旗', '帜', '🇨🇳'
]
*/
console.log(`实际视觉字符总数: ${result.length}`); // 精确返回视觉数量
Intl.Segmenter 由浏览器与 V8 引擎直接调用底层的 C++ ICU 库完成计算,解析速度极快,无需打包任何庞大的外部分词字典或第三方正则库,且完全兼容复杂的连字、肤色、性别与旗帜符号。
环境兼容性评估
Intl.Segmenter 目前已经获得了主流 JavaScript 运行环境的全面支持:
- Node.js: 从 Node.js 16.0.0 开始原生内置完整支持。
- Chrome / Edge: 从 Chrome 87 版本开始原生支持。
- Safari: 从 Safari 14.1 / iOS 14.5 开始原生支持。
- Firefox: 从 Firefox 125 版本开始正式内置支持。
四、方案三:旧环境兼容与正则表达式 Unicode 属性类
如果你的项目需要兼顾老旧浏览器(如旧版 Firefox 或部分老旧 WebView 环境),或者无法升级 Node.js 版本,可以采用以下两种兼容方案:
1. 正则表达式 Unicode 扩展匹配(ES2018+)
ES2018 为正则表达式引入了 u 标志与 \p{...}(Unicode 属性转义字符类),能够匹配绝大部分图形表情符号:
// 正则表达式 Unicode 扩展匹配(支持基础表情及部分复合表情)
function splitWithRegex(str) {
// \p{Extended_Pictographic} 匹配所有标准 Emoji 符号
// (?:...) 连字符贪婪捕获其后跟随的修饰符或 ZWJ 连接块
const regex = /\p{Extended_Pictographic}(?:\u200D\p{Extended_Pictographic}|\uFE0F|\p{Emoji_Modifier})*|./gu;
return str.match(regex) || [];
}
const res = splitWithRegex("代码👨💻加油🎉");
console.log(res);
// 示例输出: ['代', '码', '👨💻', '加', '油', '🎉']
2. 使用轻量级开源字素库(完全垫片兜底)
在企业级遗留系统中,若要 100% 模拟 Unicode 字素簇规范,最稳健的做法是引入社区长期维护的轻量级库,例如 runes2 或 grapheme-splitter:
// 安装依赖: npm install runes2
import runes from 'runes2';
const list = runes("家庭👨👩👧👦快乐");
console.log(list);
// 示例输出: ['家', '庭', '👨👩👧👦', '快', '乐']
五、生产实践中的高频衍生问题与注意事项
在实际业务开发中,将字符串转为数组往往只是第一步,后续通常伴随着长度截断、反转倒序、输入限制与持久化存储。在这些环节中,以下细节尤为关键:
1. 字符串安全截断(避免“半个表情”现象)
在实现文章摘要、微博限制 140 字或评论区缩略时,如果直接使用 str.slice(0, 10),如果第 10 个字符刚好落在某个 Emoji 的高低位代理对中间,截断后的字符串末尾就会残留一个残缺的孤立码元,导致渲染乱码。
正确做法:先通过字素数组进行切割,再拼接还原字符串:
/**
* 安全截取指定视觉长度的子字符串
*/
function safeTruncate(str, maxLength) {
const chars = stringToGraphemes(str);
if (chars.length <= maxLength) return str;
return chars.slice(0, maxLength).join('') + '...';
}
console.log(safeTruncate("祝大家工作顺利👨💻生活美满👨👩👧👦", 9));
// 输出: "祝大家工作顺利👨💻生..." (表情绝不会被半路切断)
2. 数据库与接口编码(MySQL utf8mb4)
前端即使通过数组处理完整了 Emoji,如果后端 MySQL 数据库的字符集仍配置为旧式的 utf8(在 MySQL 中 utf8 只支持最多 3 字节字符),当插入包含 4 字节的 Emoji(如 😊、👍)时,仍会抛出 java.sql.SQLException: Incorrect string value 错误。
务必确保数据库表及列的编码设置为 utf8mb4,排序规则设置为 utf8mb4_unicode_ci 或 utf8mb4_0900_ai_ci。
3. 性能考量与大文本处理
虽然 Intl.Segmenter 非常高效,但如果处理的是几十万字的长篇大文本,直接将其全量生成数组(Array.from(segments))会瞬间分配大量的微小字符串对象,增加垃圾回收(GC)负担。
对于纯遍历或统计需求,建议直接使用 for...of 迭代 segmenter.segment(str) 返回的可迭代对象,按需处理每个片段,避免一次性生成超大数组。
六、总结与选型清单
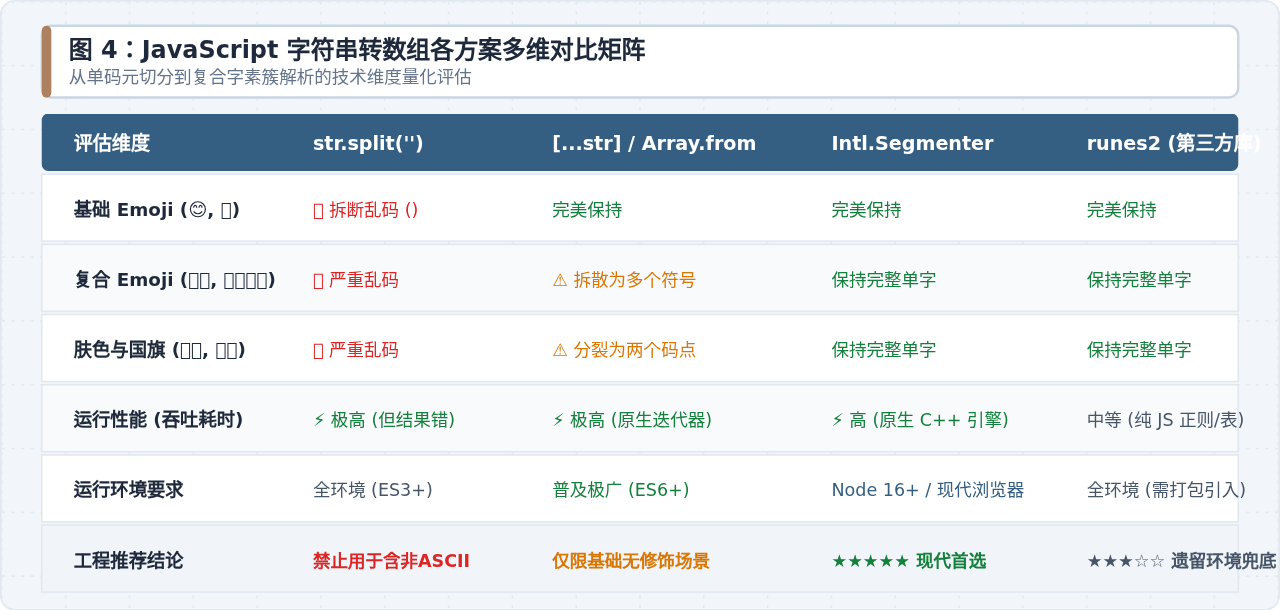
处理 JavaScript 字符串转数组时的 Emoji 防乱码问题,核心依据是粒度等级与目标环境:
- 彻底禁用
str.split(''): 它按 16 位 UTF-16 码元切分,遇到任何非 BMP 字符(绝大部分 Emoji)必遭断裂乱码。 - 基础场景优先
[...str]: 适合中英文混合与常规单体 Emoji(😊、🎉、❤️),语法简洁原生,零额外开销。 - 工业级最佳实践
Intl.Segmenter: 适合处理用户生成内容(UGC)、复杂复合 Emoji(👨💻、👨👩👧👦)、国旗及修饰符,是现代 Web 与 Node.js 的标准首选方案。 - 老旧系统备用
runes2: 在低版本 Node 或老旧内嵌 WebView 中作为兜底兼容包。
js字符串十六进制"ff,ab"怎么转数字数组
2026-11-13 14:45:45
JS将本地时间格式化为YYYY-MM-DD HH:mm:ss的代码实现
2026-11-13 14:05:22
js字符串转数组Array.fromAsync异步场景用法
2026-11-13 10:48:24
js字符串RegExp.escape安全转数组ES2025
2026-11-13 10:30:49
封装JavaScript工具函数:返回数组中某值的所有索引
2026-11-13 10:12:27