js字符串转数组toWellFormed修复乱码ES2024
深入解析在JavaScript中将包含孤立代理对的畸形字符串转为数组时的乱码成因,系统讲解ES2024规范引入的String.prototype.toWellFormed与isWellFormed核心机制,结合Array.from与Intl.Segmenter提供健壮的防乱码实操指南。
encodeURI)或序列化时直接抛出严重异常。ECMAScript 2024(ES2024)正式引入了 String.prototype.toWellFormed() 与 String.prototype.isWellFormed() 原生方法,提供了标准化的格式清洗与规整能力。本文将详细讲解这一乱码产生机理,并提供从检测、清洗到多粒度转数组的安全操作步骤与技术选型。
一、为什么字符串转数组会遭遇乱码?
在日常开发中,将字符串拆分为字符数组是非常普遍的操作,例如计算用户输入长度、文本分词、逐字渲染或做敏感字符过滤。然而,不少开发者习惯直接调用 str.split('') 或者使用展开运算符 [...str],在处理纯 ASCII 字符时一切正常,但在遭遇 Emoji 表情或外部异常数据流时,就会显现出截然不同的乱码陷阱。
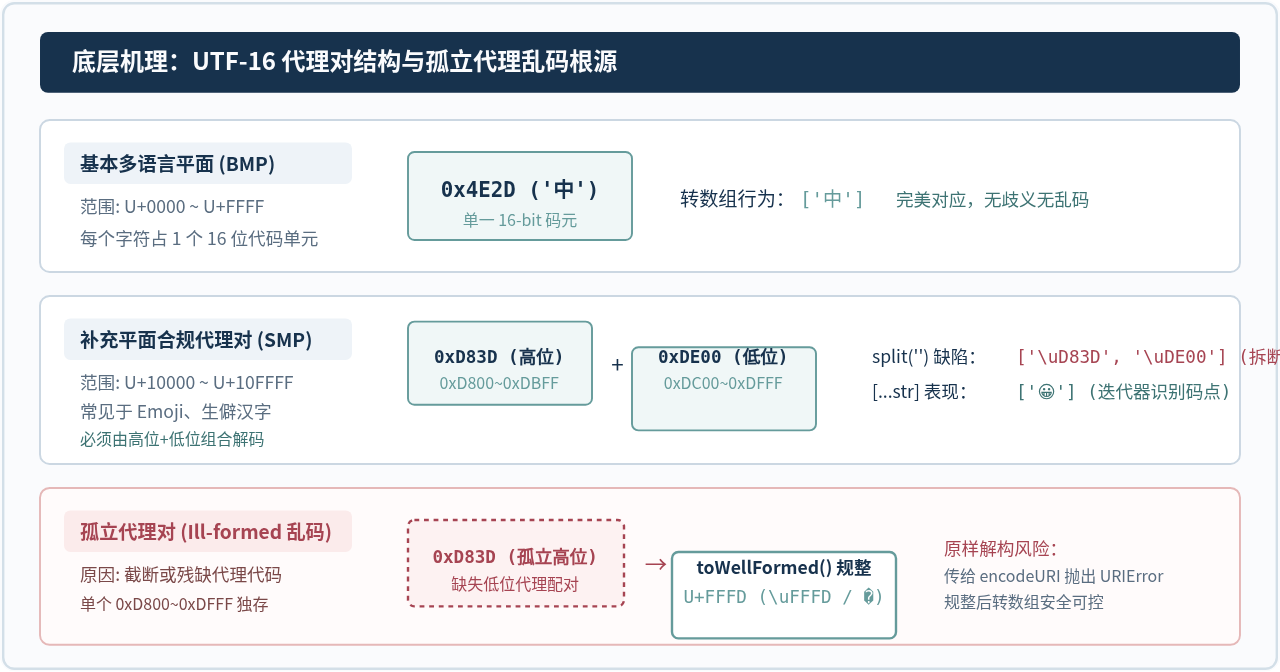
这种现象的核心根源在于:JavaScript 内部对于字符串始终使用 UTF-16 代码单元(Code Units) 序列进行存储与索引。
- 使用
split('')截断 Emoji:普通字符(如英文、基础汉字)处于基本多语言平面(BMP),占用一个 16 位的代码单元;而现代 Emoji(如 😀)处于辅助平面(SMP),需要由两个 16 位的“代理对”协同表达。调用split('')会机械地按 16 位码元切断,导致一个完整的 Emoji 被强行拆碎成两个非法的半截字符(['\uD83D', '\uDE00']),在页面上渲染为问号或空白方框。 - 扩展运算符与孤立代理对:虽然现代 ES6 扩展运算符
[...str]或Array.from(str)能自动合并成对的代理单元,但如果外部字符串因固定长度截断(如后端数据库按截断长度 slice)、文件损坏或网络协议分片传递,导致字符串中只留下了单独的高位代理(High Surrogate:0xD800 ~ 0xDBFF)或单独的低位代理(Low Surrogate:0xDC00 ~ 0xDFFF),这被称为孤立代理对(Lone Surrogate)。此时无论使用何种传统迭代器,拆解出的数组都会包含畸形码元,引发下游隐蔽故障。
二、ES2024 toWellFormed 与 isWellFormed 的运作机理
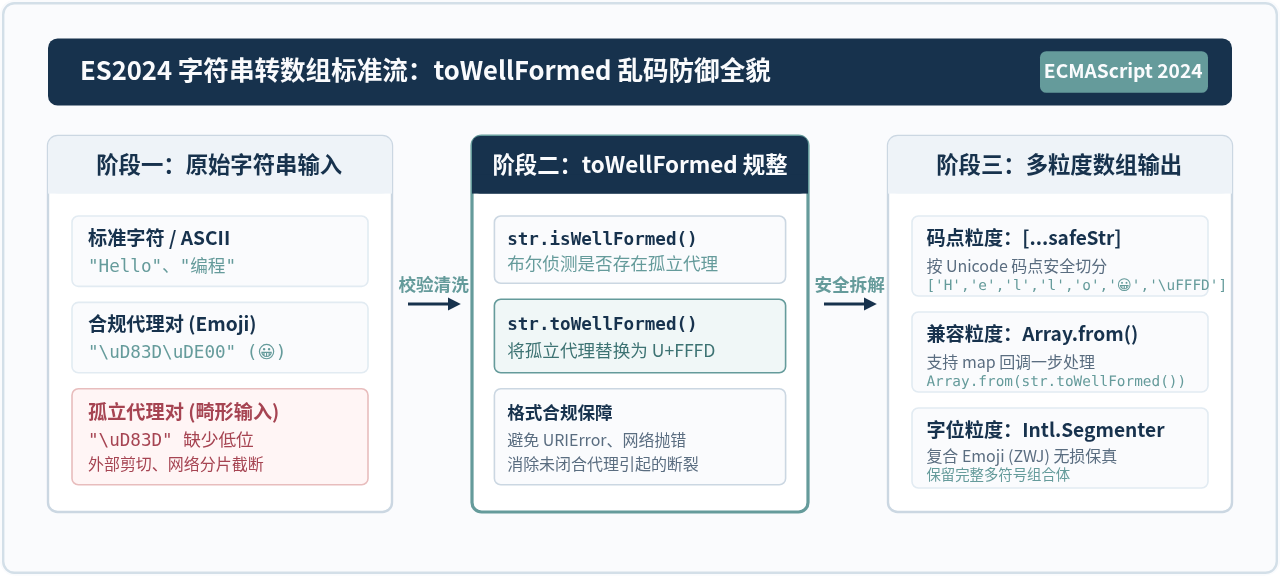
为了在语言规范层彻底解决“非完好格式”(Ill-formed)UTF-16 字符串带来的隐蔽风险,ECMAScript 2024 在 String.prototype 上新增了两个核心 API:
1. String.prototype.isWellFormed()
该方法返回一个布尔值,用于无副作用地快速检查当前字符串是否为“格式完好”(Well-formed)。如果字符串中不包含任何孤立代理对,返回 true;若检测到任何孤立的高位或低位代理,则返回 false。
const normalText = "前端编程😀";
console.log(normalText.isWellFormed()); // true (成对代理正常)

const illFormedText = "异常文本\uD83D测试"; // 只有高位代理,缺少低位
console.log(illFormedText.isWellFormed()); // false (存在孤立代理)
2. String.prototype.toWellFormed()
该方法返回一个新的字符串,将原字符串中所有的孤立代理对替换为 Unicode 标准替换字符 U+FFFD(即形如 � 的替代符)。所有合法成对的代理对和标准 BMP 字符则保持原样不动。
const illFormedText = "异常文本\uD83D测试";
const wellFormedText = illFormedText.toWellFormed();

console.log(wellFormedText); // "异常文本�测试"
console.log(wellFormedText.isWellFormed()); // trueencodeURI() 或 encodeURIComponent(),浏览器会直接抛出未捕获的 URIError: URI malformed 异常,极易造成整个页面或微前端应用白屏。使用 toWellFormed() 洗涤后,该异常被从根源上化解。
三、实操步骤:从安全清洗到数组转换的完整流程
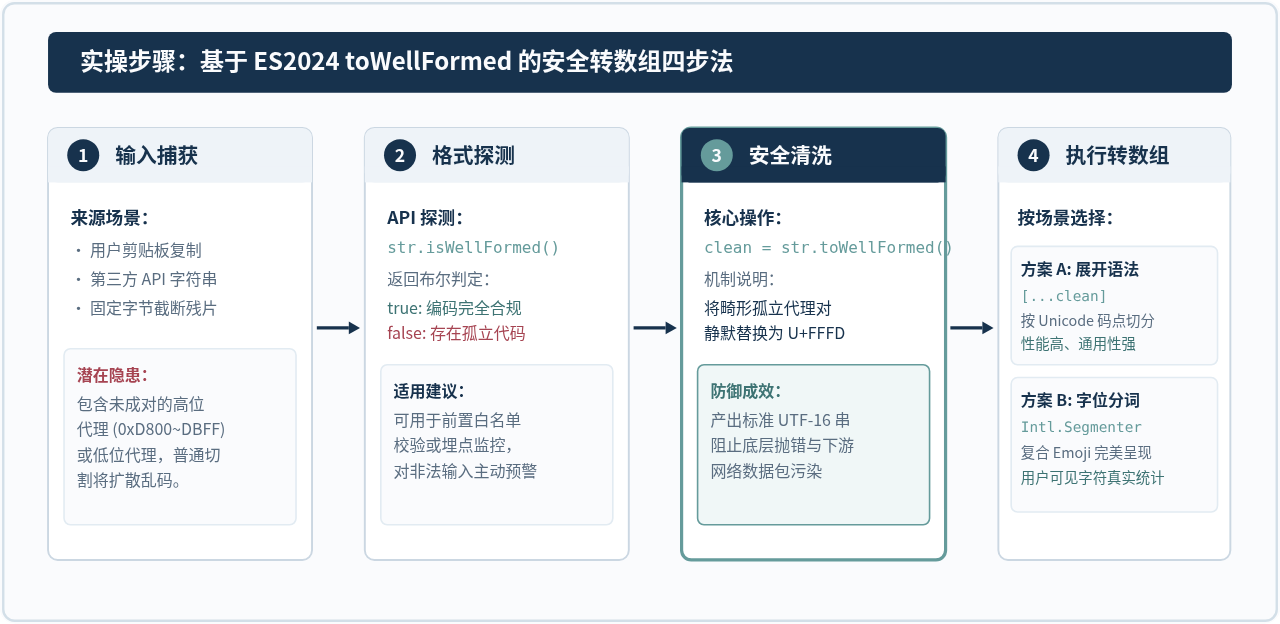
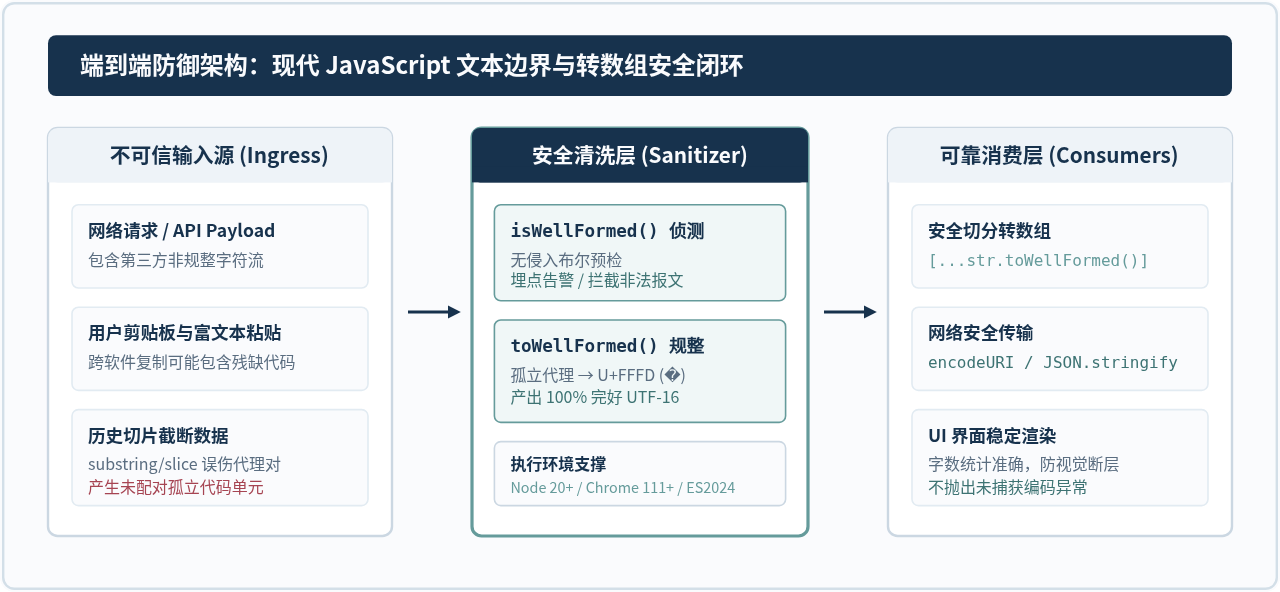
在实际生产环境中,将含有潜在畸形编码风险的字符串转为数组,推荐遵循以下四个标准操作阶段:
步骤一:捕获与前置判定
当从不可信数据源(如 URL 参数、用户外部文件上传、剪贴板粘贴文本或未过滤的 HTTP 响应体)获取字符串时,首先可以结合 isWellFormed() 进行日志监控或快速分支排查。
步骤二:调用 toWellFormed() 消除畸形代码
在进入业务拆解或分割逻辑前,统一将字符串通过 toWellFormed() 规范化。此操作不会破坏原字符,仅把无法解释的非法码元转为标准可显符。
步骤三:结合场景执行转数组
根据业务对于字符精细度的需求,选择最匹配的转数组方案:
- 常规字符与标准 Emoji 场景:使用展开运算符
[...str.toWellFormed()]或Array.from(str.toWellFormed())。能够正确将每一个 Unicode 码点(Code Point)保留为单一元素,同时孤立残片被转换为安全的单一替换符。 - 复杂图文字符(复合 Emoji / ZWJ 连字)场景:对于带有肤色修饰符、性别或连字符号的复合 Emoji(例如 👨👩👧👦、🏳️🌈),Unicode 码点展开依然会将其拆分为多个码点元素。如果需要按用户视觉感知的“完整字符”切分,应配合
Intl.Segmenter。
完整代码示例:
/**
 * 安全地将输入字符串规整并转换为数组
 * @param {string} input - 原始输入字符串
 * @param {'codepoint' | 'grapheme'} mode - 拆分粒度
 * @returns {string[]} 拆分后的安全数组
 */
function safeStringToCharArray(input, mode = 'codepoint') {
  if (typeof input !== 'string') {
    throw new TypeError('输入必须为字符串类型');
  }

  // 1. ES2024 格式规整:自动替换所有孤立代理对为 \uFFFD
  const wellFormedStr = input.toWellFormed();

  // 2. 依据粒度选择拆解策略
  if (mode === 'grapheme' && typeof Intl !== 'undefined' && Intl.Segmenter) {
    // 字位簇模式:保留复合 Emoji、变音符的整体性
    const segmenter = new Intl.Segmenter('zh', { granularity: 'grapheme' });
    return Array.from(segmenter.segment(wellFormedStr), item => item.segment);
  }

  // 默认码点模式:兼顾性能与通用 Emoji
  return [...wellFormedStr];
}

// 验证执行结果示例:
const testCase = "A\uD83D\uDE00B\uD83DC"; // 包含合法 Emoji(😀) 和孤立代理(\uD83D)

const result = safeStringToCharArray(testCase);
console.log(result);
// 示例输出: ['A', '😀', 'B', '�', 'C']
// 结论:合法 Emoji 维持整体,孤立高位代理被安全规约为替换符,未发生破损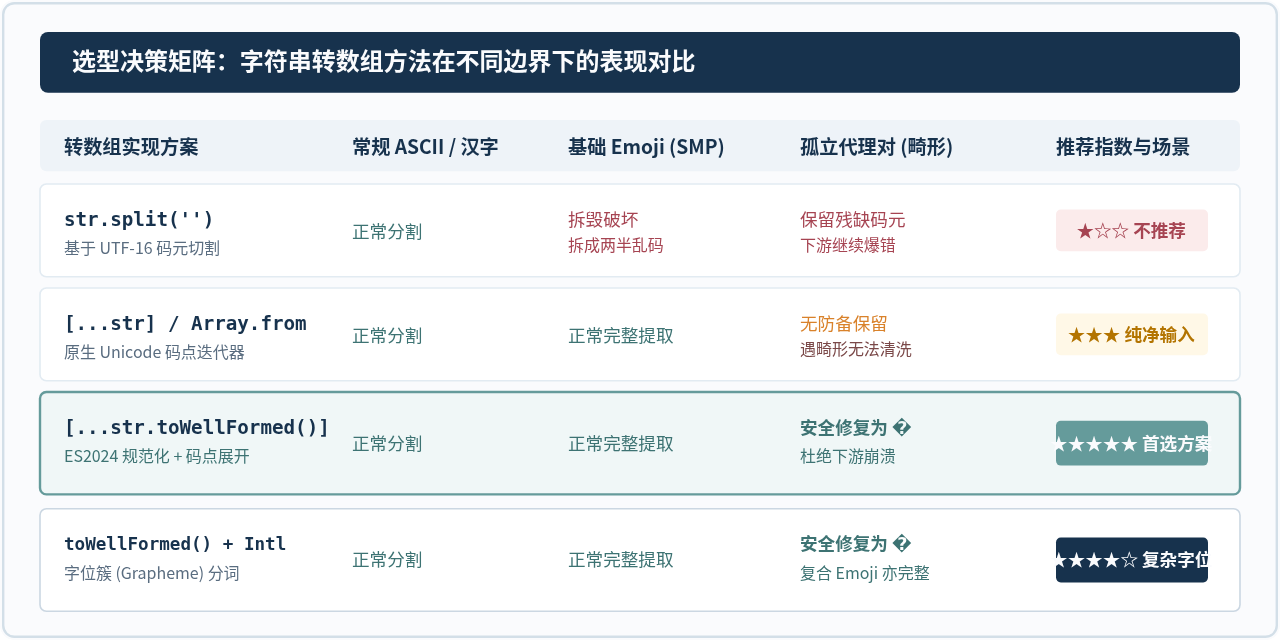
四、转数组常见方案的抗乱码能力对比与选型决策
为了帮助开发者在不同业务场景中做出最稳妥的技术决策,下表与决策矩阵汇总了当前前端主流转数组方案在各类字符边界条件下的表现:
| 实现方案 | ASCII 与常见中文 | 标准 SMP Emoji (如 😀) | 孤立代理对 (如 \uD83D) | 复合 Emoji (如 👨👩👧👦) | 典型适用场景 |
|---|---|---|---|---|---|
str.split('') |
正常切分 | 拆毁为两个非法码元(乱码) | 原样输出畸形单元 | 拆为若干离散码元 | 仅限纯 ASCII 内部简单协议,日常业务坚决禁用 |
[...str] |
正常切分 | 正确保持为一个字符 | 仍输出孤立码元,传递有隐患 | 拆为多个单项码点 | 纯内部已知可信字符串的简单迭代 |
[...str.toWellFormed()] |
正常切分 | 正确保持为一个字符 | 自动净化为标准 � 字符(安全) | 拆为多个单项码点 | 推荐首选:通用高健壮性转数组方案 |
toWellFormed + Intl.Segmenter |
正常切分 | 正确保持为一个字符 | 自动净化为标准 � 字符(安全) | 完美保持为一个完整图形字符 | 富文本字数统计、高保真富交互编辑组件 |
String.prototype.toWellFormed() 与 isWellFormed() 作为 ES2024 标准方法,已在 Chrome 111+、Edge 111+、Firefox 119+、Safari 16.4+ 以及 Node.js 20+ 中全面得到原生支持。如果项目需要兼容更早版本的旧环境(如老旧 WebView),可以通过 core-js 引入标准 Polyfill,或使用如下轻量级补丁逻辑:
if (!String.prototype.toWellFormed) {
  String.prototype.toWellFormed = function () {
    // 借助正则匹配未成对的代理区代码单元
    return this.replace(
      /(?:[\uD800-\uDBFF](?![\uDC00-\uDFFF]))|(?:[^\uD800-\uDBFF]|^)([\uDC00-\uDFFF])/g,
      (match, p1) => p1 ? match.slice(0, -1) + '\uFFFD' : '\uFFFD'
    );
  };
}
五、生产环境文本安全防御策略总结
字符串转数组看似基础,但在多语言国际化、用户动态 UGC 生产、外部数据接口对接等复杂链路中,往往是系统容错能力的薄弱环节。通过引入 ES2024 的规整特性,团队可以建立标准化的防御性编程闭环:
- 入口前置规整:对于所有来自剪贴板、第三方 API、持久化文件或 URL 传参的字符串,在进入业务处理前,优先执行
str.toWellFormed()消除潜在的孤立代理对隐患。 - 杜绝
split(''):全面审查代码库,将所有的str.split('')升级为解构语法或分词器,彻底根除因字符拆分造成的表情乱码与符号破损。 - 按语义选用切分粒度:如果仅是做字母与基本符号的遍历,展开运算符配合规整串是最高效的手段;如果涉及字数限制(如微博/推文式的 140 字计数),必须选用
Intl.Segmenter以确保复合 Emoji 仅被计为一个字符单元。 - 网络与序列化保障:在调用
encodeURI、构建 WebSocket 帧或执行底层二进制编解码前,经过toWellFormed()规整的文本能保证 100% 具备 UTF-16 完好性,彻底避免运行时因编码不匹配引发的应用崩坏。
js字符串"[1,2,3]"怎么转数组JSON.parse
2026-11-13 10:16:16
js字符串怎么按空格转数组split空格
2026-11-13 10:09:58
js字符串怎么按多个分隔符转数组split(/[,.]/)
2026-11-13 09:48:32
js字符串"true,false"怎么转布尔数组
2026-11-13 09:43:39
JavaScript数组常用方法清单:增删改查与遍历API详解
2026-11-12 22:52:44