JS字符串转数组:split()方法详解与正则分隔符用法
全面解析 JavaScript 中 String.prototype.split() 方法的内部运行机制、参数细节及正则表达式分隔符的高级实战技巧,涵盖空白符切分、混合符号匹配、捕获括号特性与常见避坑指南。
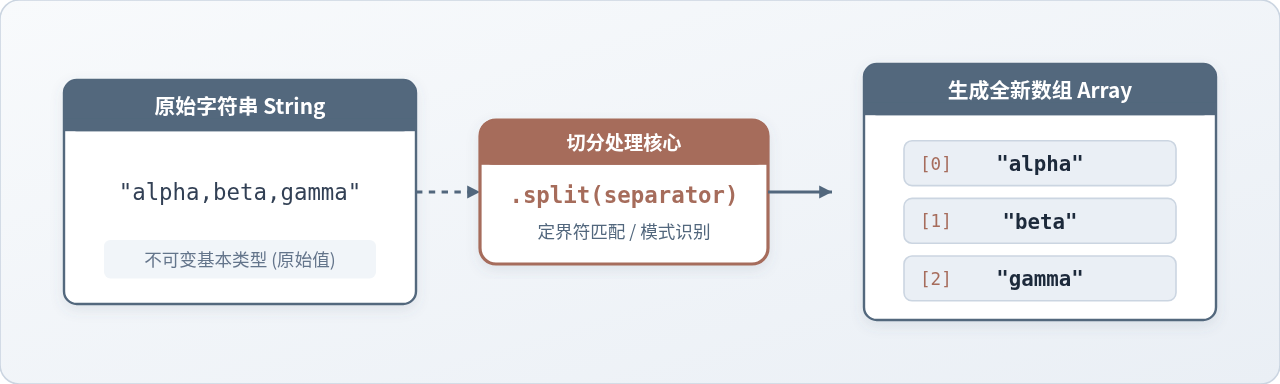
在 JavaScript 数据清洗与文本处理中,将具有特定结构的连续文本拆解为离散的数据集合是最高频的操作之一。原生方法 String.prototype.split() 提供了最标准、最直接的转换途径。它既能够按照固定的字符边界(如逗号、冒号、路径分隔符)进行快速精确切分,也可以接收正则表达式作为定界规则,轻松化解多重空白、混合标点以及复杂上下文等不规则文本难题。本文将系统拆解 split() 的底层执行过程、参数细节,并重点剖析正则分隔符的高阶用法与常见边界陷阱。
一、split() 基础语法与核心切分机制
在 JavaScript 中,字符串属于不可变原始类型(Primitive Value)。任何字符串方法都不会直接修改原文本,split() 也是如此。它的基本语法如下:
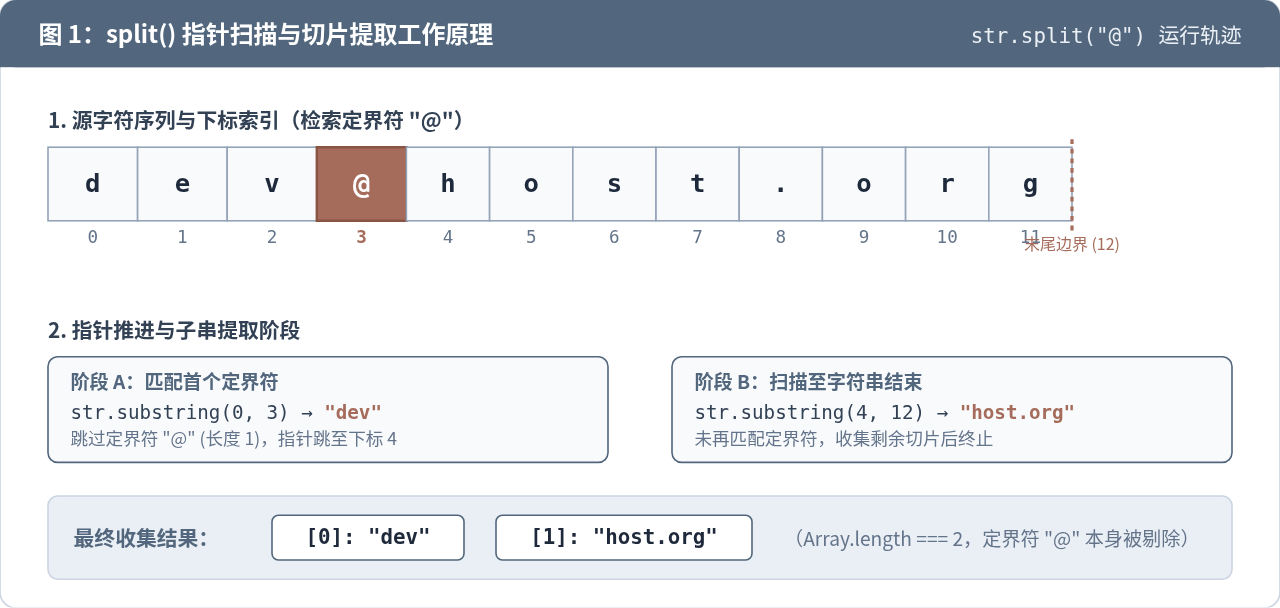
const result = str.split([separator[, limit]]);该方法返回一个全新创建的数组实例。它在内部会建立一个字符扫描游标,自左向右遍历源字符串,比对定界符 separator。一旦探测到定界符匹配成功,引擎就会截取上一次切分点到当前定界符起始点之间的字符切片并压入结果数组,随后跳过定界符自身长度,继续向后扫描,直到字符串结束。
1. 缺省分隔符与空字符串切分
很多开发者在调用 split() 时会忽略参数缺省时的默认行为:
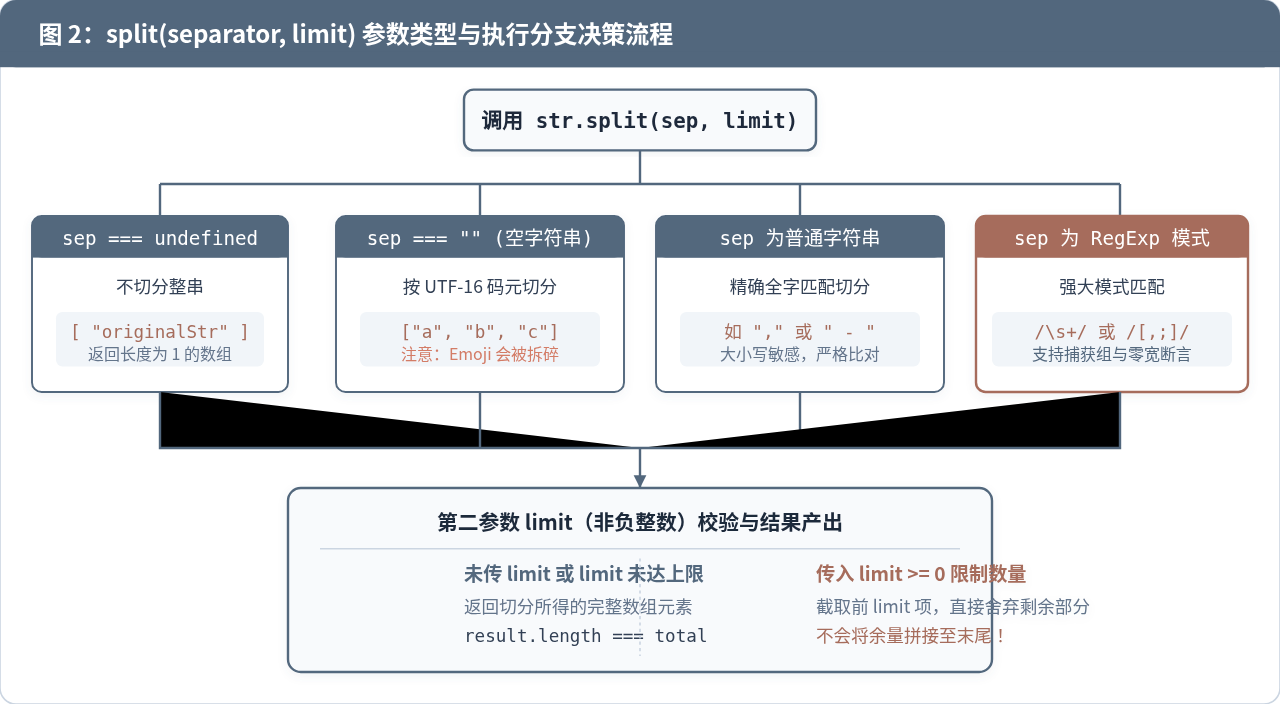
- 不传任何参数(或 separator 为 undefined):引擎不会对字符串进行任何切割,而是直接返回一个只包含原始字符串单一元素的数组,即
[str]。 - 传入空字符串
"":引擎会在每一个 UTF-16 码元(Code Unit)之间进行切割,将每个字符独立拆为单个数组项。例如"abc".split("")将得到["a", "b", "c"]。
注意 Unicode 代理对(Surrogate Pairs)隐患:
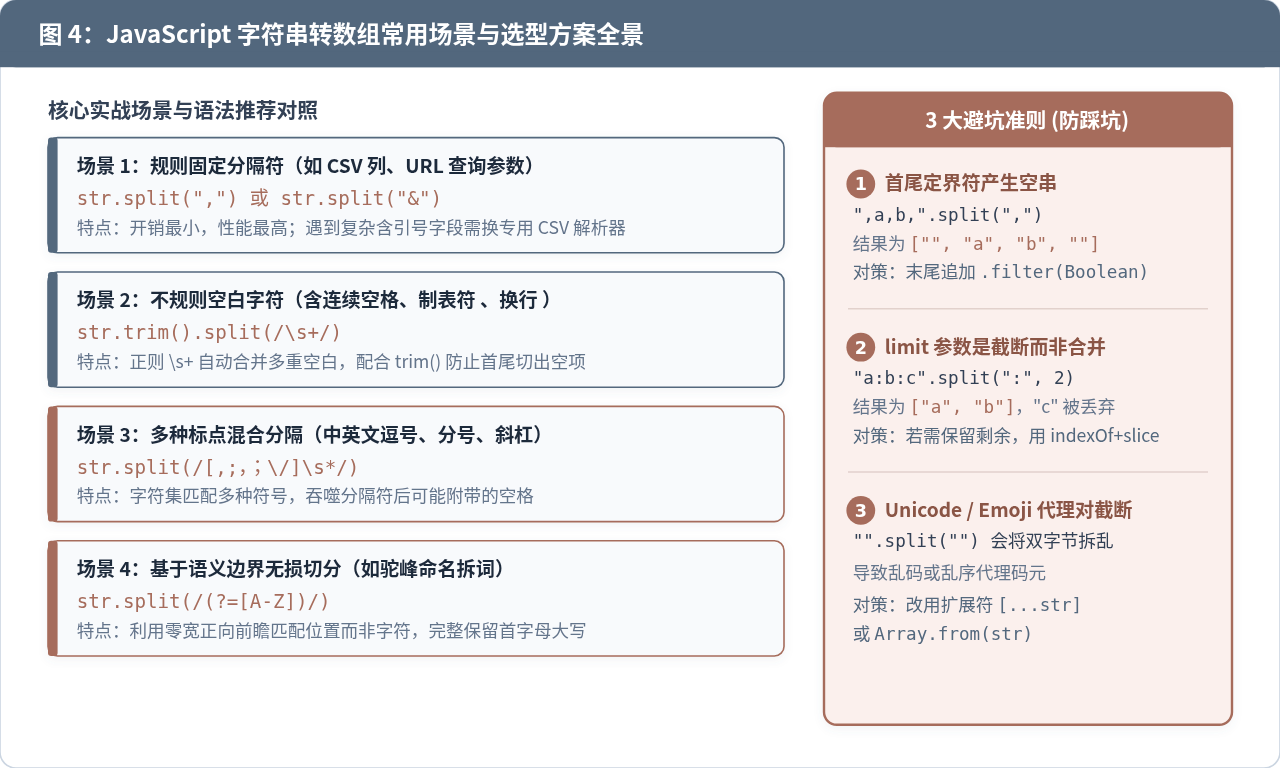
split("") 是基于 UTF-16 码元切分的。对于超出基本多语言平面(BMP)的字符(例如 Emoji 表情 "👨👩👧" 或罕见汉字),一个字符由两个 16 位码元组成。此时使用 str.split("") 会将代理对粗暴切断,导致字符损坏或变成问号乱码。在处理可能包含 Emoji 的文本时,推荐使用 ES6 展开运算符 [...str] 或 Array.from(str),它们具备完整的 Unicode 码点感知能力。
2. limit 参数的真实行为:截断而非合并
limit 是一个可选的非负整数,用于指定返回数组的最大项数。一个极为普遍的误解是认为“limit 会在达到切分次数后,把剩余的所有字符串拼接在最后一项中”。事实并非如此:
const raw = "title:content:extra:details";
const parts = raw.split(":", 2);

// 示例输出:["title", "content"]
console.log(parts);
如示例所示,当返回数组的长度达到 limit 时,split() 会立即停止切分并返回当前已收集的项,后续所有未扫描的文本均被直接丢弃,并不会合并到 parts[1]。如果业务场景需要“仅在第一个分隔符处切开,剩余部分完整保留”,应当使用 indexOf() 定位后配合 slice() 截取,而不是依赖 limit 参数。
二、正则表达式分隔符的进阶应用
当处理用户输入、日志日志或非规范化文本时,分隔符往往不是单一固定的字符。此时将正则表达式作为 separator 传递,能够以极高的代码表现力完成复杂的切分任务。
1. 处理连续且不规则的空白字符
在解析由制表符( )、空格或换行混合构成的表格文本时,如果直接用单个空格 " " 切分,连续的多个空格会导致数组中充斥大量空字符串 ""。利用正则元字符 \s+ 能够将任意连续空白合并为单个定界符:
const logLine = "2026-11-12    ERROR   	  ConnectionTimeout
";

// 配合 trim() 先去除行首尾多余空白,避免产生首尾空元素
const tokens = logLine.trim().split(/\s+/);

// 示例输出:["2026-11-12", "ERROR", "ConnectionTimeout"]
console.log(tokens);
2. 多重标点混合分隔(中英文兼容)
在中文网站或国际化业务中,用户在输入关键词或标签时经常混用中文逗号、英文逗号、分号或斜杠。借助正则字符集 [...],可以实现统一识别:
const tagsInput = "前端,JavaScript,Vue3;React/Node.js";

// 匹配中英文逗号、中英文分号以及斜杠,并允许后面紧随任意空白
const tags = tagsInput.split(/[,;,;\/]\s*/);

// 示例输出:["前端", "JavaScript", "Vue3", "React", "Node.js"]
console.log(tags);
3. 捕获括号 () 的特殊特性:保留定界符
这是 split() 中最容易被忽视却极其强大的一项特性:如果正则表达式中包含了捕获括号 (...),那么每次匹配到的定界符内容都会被自动插入到结果数组中!
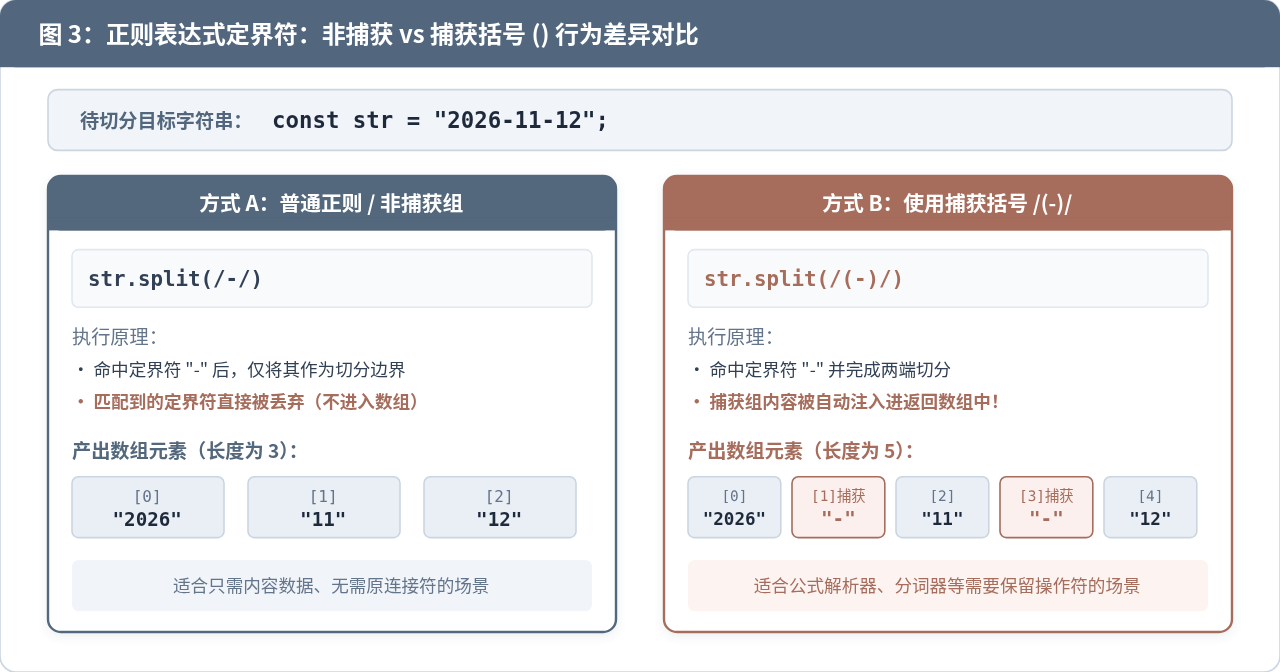
对比以下两段代码的执行结果:
const expression = "100+25*4-10";

// 方式 A:不带捕获括号,运算符被完全丢弃
const numbersOnly = expression.split(/[+*\-]/);
// 示例输出:["100", "25", "4", "10"]

// 方式 B:包含捕获组,运算符被完整保留进数组序列
const fullTokens = expression.split(/([+*\-])/);
// 示例输出:["100", "+", "25", "*", "4", "-", "10"]
在编写数学公式分词器、富文本词法分析器或 Markdown 解析器时,这种特性可以省去手动比对和重建连接符的繁琐工作。反之,如果你在正则表达式中使用了括号却不希望保留定界符,务必将其写为非捕获组语法 (?:...)。
4. 利用零宽断言(Lookaround)实现无损边界切割
传统的定界符匹配会“消耗”(Consume)文本中的字符。如果我们需要按照某种语义规则切分,但字符本身不能被剔除,零宽正向前瞻(Lookahead)与后顾(Lookbehind)是最佳工具。例如将驼峰命名(CamelCase)拆解为独立单词:
const camelCaseStr = "parseUserAccountData";

// 匹配“后面紧随大写字母”的位置,零宽断言不消耗字符
const words = camelCaseStr.split(/(?=[A-Z])/);

// 示例输出:["parse", "User", "Account", "Data"]
console.log(words);
三、常见使用场景与高频避坑指南
在实际工程中,未经清洗的输入文本很容易让 split() 产生意料之外的结果。掌握以下几条防坑经验,能让代码健壮性大幅提升。
1. 首尾分隔符引发的“幽灵空串”
当输入文本的最前端或最末端存在定界符时,split() 会严格在边界处产生一个空字符串 "":
const raw = ",Apple,Banana,Orange,";
const list = raw.split(",");

// 示例输出:["", "Apple", "Banana", "Orange", ""] (长度为 5)
console.log(list);

// 正确清洗姿态:追加 filter(Boolean) 剔除空字符串
const cleanList = raw.split(",").filter(Boolean);
// 示例输出:["Apple", "Banana", "Orange"] (长度为 3)
console.log(cleanList);
2. 正则表达式中 /g 修饰符的冗余性
在 RegExp.prototype.exec() 或 String.prototype.replace() 中,全局修饰符 g 决定了是否进行全量匹配。但在 split() 方法中,规范规定引擎总是自动全局扫描整个字符串。因此在 str.split(/,/g) 中添加 g 是完全多余的,且不会带来任何行为差异。
四、常用技术方案对比与选型参考
为了帮助读者根据实际业务场景快速做出正确选择,下表对各类常见切分方式的特点及适用场景进行了系统横向对比:
| 切分方式 | 典型示例代码 | 定界符保留情况 | 核心适用场景与限制 |
|---|---|---|---|
| 单一固定字符 | str.split(",") |
完全剔除 | CSV 简单列、URL 参数。性能最佳,但无法容忍格式不规则。 |
| 空字符串单字符 | str.split("") |
保留所有字符 | 基础单字处理。无法正确处理 Emoji 及复合代理对字符。 |
| Unicode 展开 | [...str] 或 Array.from(str) |
保留全部码点 | 替代 split(""),安全支持所有 Emoji 与国际化扩展字符。 |
| 正则多重空白 | str.trim().split(/\s+/) |
完全剔除 | 命令行参数分词、日志列提取、用户任意空格排版规范化。 |
| 正则字符集 | str.split(/[,;\/]/) |
完全剔除 | 多标签输入清洗、中英文混杂定界符自动对齐。 |
| 捕获组正则 | str.split(/([+\-*/])/) |
注入数组保留 | 公式计算器、文本模板标记解析、代码轻量 Tokenizer。 |
| 零宽前瞻断言 | str.split(/(?=[A-Z])/) |
无损保留原字 | 驼峰命名拆分、不消耗原字符的语义分块。 |
String.prototype.split() 作为 JavaScript 中基础而高频的核心 API,其功能远不止简单的逗号拆词。通过精确理解字符扫描游标、区分非捕获组与捕获括号的注入特性,并针对首尾空串、代理对以及连续空白等边界情况做好前置清洗,我们便能够在各类复杂的前端与服务端文本处理中写出高效、优雅且健壮的代码。
JS 中 Math.floor、Math.trunc 与 parseInt 取整区别
2026-11-12 16:01:29
JS数组slice和splice有什么区别?切片与删除操作对比
2026-11-12 09:22:37
有Java基础转学JavaScript,需要克服哪些思维转换难点?
2026-11-12 09:17:29
JS数组合并后修改元素影响原数组怎么办
2026-11-11 15:40:36
js函数里面的data参数在面试里常怎么考
2026-11-08 18:07:07