JavaScript数组sort排序陷阱:为什么默认按字符串排序?
深入解析JavaScript中Array.prototype.sort()默认按字符串字典序排序的底层原因、规范定义、执行流程及常见陷阱,提供可靠的数值排序与多场景解决方案。
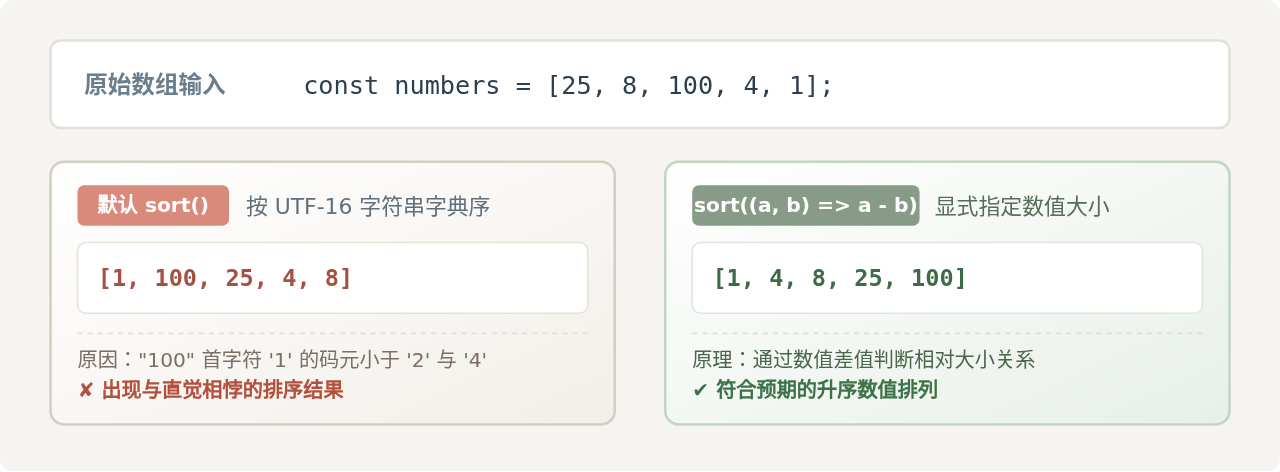
arr.sort() 常会出现 [10, 2, 5] 排序后变成 [10, 2, 5] 的反直觉现象。根本原因在于 ECMAScript 规范规定:当不提供自定义比较函数时,sort() 会在内部将每个非 undefined 元素强制转换为字符串,随后按照字符的 UTF-16 码元(Code Unit)顺序逐位比对。要获得符合预期的升序数值排序,必须显式传入比较函数 arr.sort((a, b) => a - b)。
一、现象剖析:初学者最常遇到的排序反常
在编写 JavaScript 程序时,对一组数字进行由小到大排序是一项常见需求。许多从其他语言转向 JavaScript 的开发者会习惯性地写下如下代码:
// 示例代码:未传入比较函数的默认排序
const scores = [10, 2, 5, 1, 100];
scores.sort();

console.log(scores);在上述结果中,100 并没有排在末尾,反而排在了 2 和 5 的前面;同时 10 也排在 2 的前面。这并不是 JavaScript 引擎的计算 Bug,而是 Array.prototype.sort() 的标准规范行为。
当数组元素较少、数字位长相同时(例如 [3, 1, 4, 2]),默认排序碰巧输出了正确升序 [1, 2, 3, 4]。这种偶然性往往掩盖了潜在陷阱,直到生产环境出现跨位数数值(如个位数与两位数、三位数混合)时,排序错误才彻底暴露。
二、深层原因:为什么规范默认按字符串排序?
理解这个设计,需要回顾 JavaScript 的语言定位与历史规范。
1. 动态类型与异构数组的基线选择
JavaScript 诞生之初被设计为一门运行在浏览器中的弱类型脚本语言。在 JavaScript 中,数组本质上是特殊的对象,并且属于“异构容器”——同一个数组可以同时容纳数字、字符串、布尔值、甚至是普通对象:
const mixedList = [10, "apple", true, { id: 1 }, 2];如果标准将 sort() 的默认行为设计为数值比较,那么当数组中出现非数值类型时,就会遭遇无法统一度量的问题:字符串 "apple" 转换为数值是 NaN,布尔值 true 转为 1,对象转为 NaN。在数学运算中,任何包含 NaN 的比较都会返回 false,导致排序算法失序崩溃。
相对而言,JavaScript 中几乎所有类型都能明确转化为字符串形式(通过内部的 ToString 抽象操作)。字符串通过字符编码的码元比对,拥有非常明确且具备全序关系(Total Order)的判定规则。因此,语言设计者将“默认转换为字符串排序”作为最通用的兜底基线。
2. 向前兼容性的历史约束
早在 1997 年发布的 ECMAScript 1 (ECMA-262) 规范中,就确立了 Array.prototype.sort 无参时转换为字符串字典序的规则。经过数十年发展,数以亿计的现有网页和库依赖这一规范行为。现代 JavaScript 引擎(如 V8、SpiderMonkey、JavaScriptCore)必须严格遵守 Web 的向前兼容承诺,因而这一行为被永远保留了下来。
三、底层运作机制:UTF-16 码元比对细节
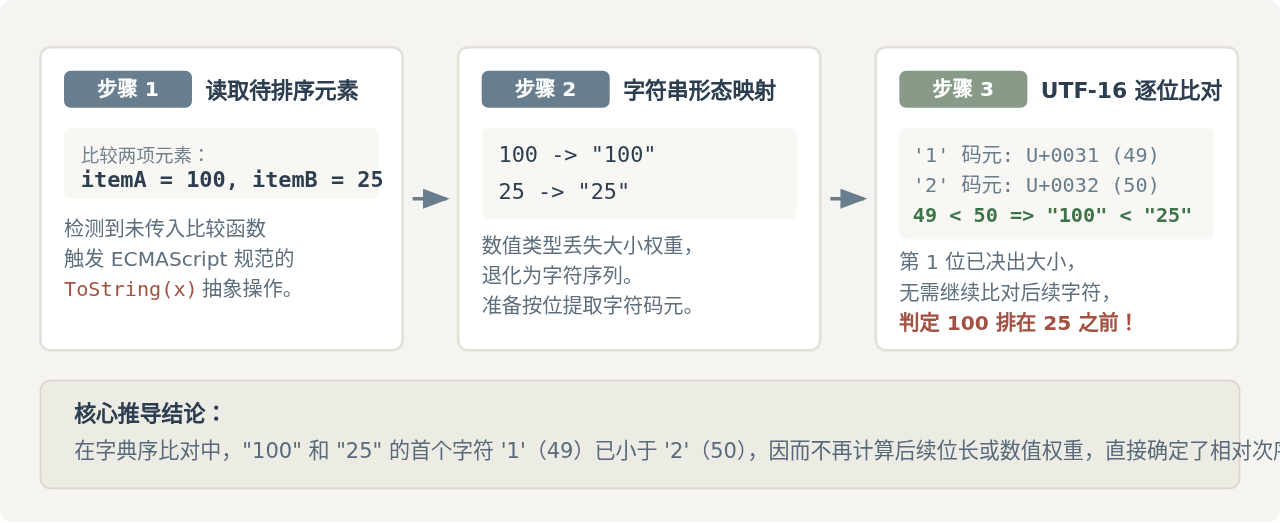
在 ECMAScript 规范中,无比较函数的 sort() 执行的是抽象比较操作:
- 若参数包含
undefined,将其视为最大值直接放到数组末尾,不触发比较逻辑;若为稀疏数组,空位(holes)同样会被推至数组最后。 - 对于两个待比对项
x和y,分别执行xString = ToString(x)和yString = ToString(y)。 - 从第
0个字符开始依次读取 UTF-16 码元数值(可通过str.charCodeAt(i)观察)。 - 在第一个出现码元不相同的索引位置,码元数值较小者排在前面。若两字符串长度不同但前缀完全相同,则较短的字符串排在前面。
我们可以通过代码直接验证字符码元值:
// 验证字符的 UTF-16 码元值
console.log("'1' 的码元:", "1".charCodeAt(0)); // 49
console.log("'2' 的码元:", "2".charCodeAt(0)); // 50
console.log("'5' 的码元:", "5".charCodeAt(0)); // 53

// 字符串比对直接根据首位码元决出胜负
console.log("'100' < '25' 结果:", "100" < "25"); // true'1' 的码元:49
'2' 的码元:50
'5' 的码元:53
'100' < '25' 结果:true
四、关键差异对照:默认排序 vs 自定义数值比较器
为了直观展现默认行为与定制逻辑的差别,我们在一组混合数值的相同输入条件下进行对照分析:
| 比对维度 | 默认行为:arr.sort() |
数值比较器:arr.sort((a, b) => a - b) |
|---|---|---|
| 内部转换机制 | 隐式调用 ToString() 转为字符串 |
保持数值类型直接参与数值运算 |
| 排序判定依据 | 字符索引位的 UTF-16 码元(十六进制/十进制值) | 比较函数返回值的正负符号(大于0、等于0、小于0) |
| 跨位数整数行为 | [1, 10, 100, 2, 20](乱序) |
[1, 2, 10, 20, 100](标准递增) |
| 负数处理行为 | [-10, -2, -5, 0, 5] 会将 -10 放在 -2 前面(因为字符 '-' 相同,接着比 '1' < '2') |
[-10, -5, -2, 0, 5](真正的数学轴递增) |
| 业务适用场景 | 纯英文字符串字母表排序(如 ['alpha', 'beta']) |
价格、年龄、权重、时间戳等纯数值计算与展示 |
五、解决方法与正确使用方式
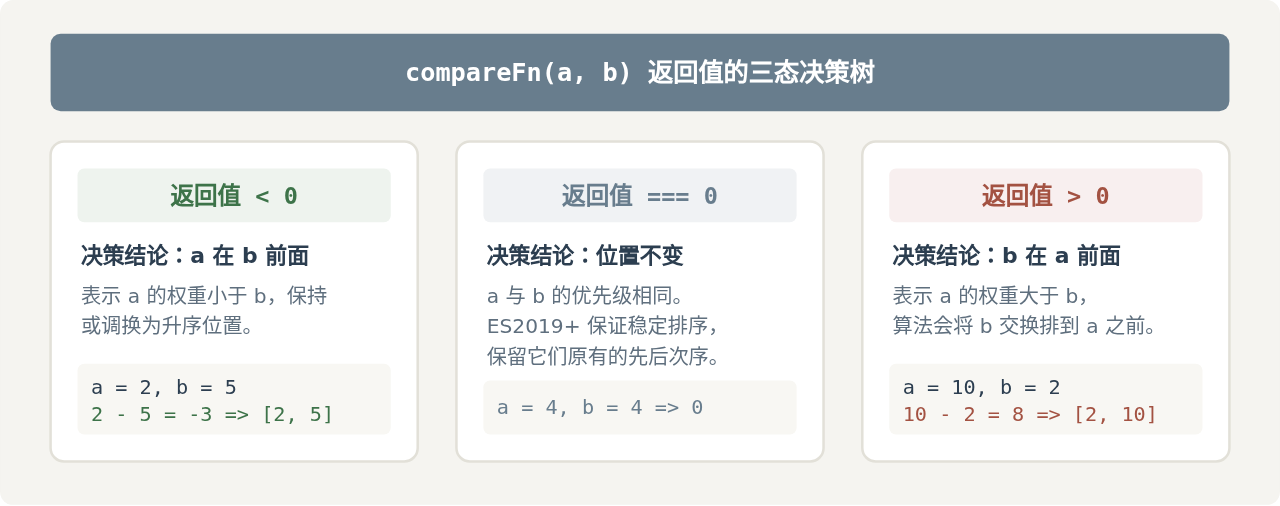
要在 JavaScript 中获得正确的排序结果,核心在于向 sort() 传递符合需求的比较函数(Comparator)。
1. 基础升序与降序操作
const list = [25, 8, 100, 4, 1];

// 升序排列(从低到高)
list.sort((a, b) => a - b);
console.log("升序结果:", list);

// 降序排列(从高到低)
list.sort((a, b) => b - a);
console.log("降序结果:", list);升序结果:[1, 4, 8, 25, 100]
降序结果:[100, 25, 8, 4, 1]
2. 对象数组按属性排序
在处理业务列表时,通常需要根据对象的某一字段进行排序:
const products = [
  { name: "鼠标", price: 120 },
  { name: "键盘", price: 399 },
  { name: "数据线", price: 25 }
];

// 按价格升序排序
products.sort((prev, next) => prev.price - next.price);
console.log("按价格升序:", products);按价格升序:[
{ name: '数据线', price: 25 },
{ name: '鼠标', price: 120 },
{ name: '键盘', price: 399 }
]
六、进阶注意事项与边界陷阱
1. 原地修改(In-Place Mutation)的副作用
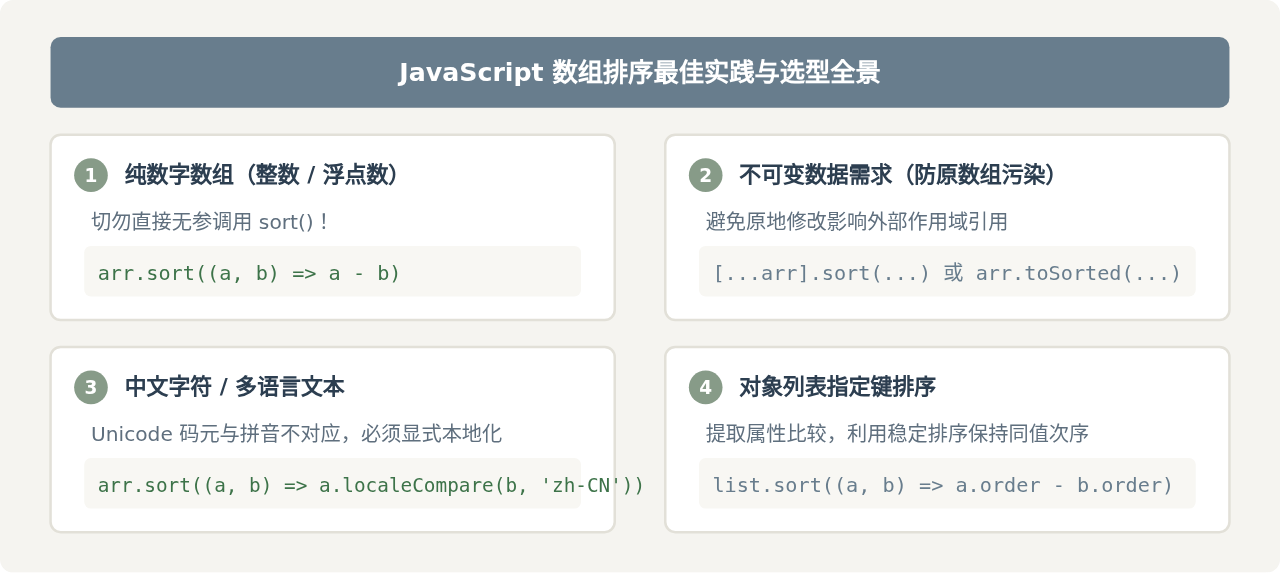
Array.prototype.sort() 会直接修改原数组,并返回原数组的引用。如果不希望破坏原始数据结构,务必先进行复制,或使用现代标准方法:
// 传统保护原数组做法:先展开浅拷贝再排序
const original = [5, 3, 8];
const sortedCopy = [...original].sort((a, b) => a - b);

// ECMAScript 2023 引入的非破坏性排序方法(现代浏览器与 Node.js 20+ 支持)
const modernSorted = original.toSorted((a, b) => a - b);
2. 数值减法 (a - b) 的下溢/溢出与 NaN 风险
虽然简写 a - b 在大多数常规场景非常高效,但在以下特殊情况下可能失效:
- 包含 NaN:若参与排序的数字包含
NaN,由于任何数与NaN相减都得NaN,三态判断全部失效,导致输出顺序不可预测。 - 极端数值溢出:如果数字跨度达到大数极值(如
Infinity或超过安全整数范围),减法可能出现浮点溢出。
在需要防御非法数据时,稳健的三元表达式比纯减法更为安全:
// 防御性数值比较函数(避免减法非数问题)
function safeCompare(a, b) {
  if (Number.isNaN(a)) return 1;
  if (Number.isNaN(b)) return -1;
  return a < b ? -1 : a > b ? 1 : 0;
}
3. 中文字符与多语言本地化排序
如果对字符串数组直接使用 sort(),默认依然是按 Unicode 码元比对,这会导致汉字并不是按照拼音首字母排序(例如汉字“阿”的编码不一定在“张”的前面)。对多语言文本排序时,应当使用 String.prototype.localeCompare:
const cities = ["北京", "上海", "广州", "深圳", "成都"];

// 错误做法:默认字典序(按 UTF-16 编码,非拼音)
cities.sort(); // 无法获得拼音顺序

// 正确做法:指定 zh-CN 语言环境按汉语拼音排序
cities.sort((a, b) => a.localeCompare(b, "zh-CN"));
console.log("按拼音升序:", cities);Array.prototype.sort 规范化为稳定排序(Stable Sort)。这意味着当两个元素的比较函数返回 0 时,引擎保证它们在排序前后的相对顺序绝对不发生改变。在此规范发布前,部分引擎对于超过 10 个元素的数组使用不稳定快排,而现代引擎(如 V8 的 TimSort 实现)均已严格遵循稳定性保障。
七、总结
JavaScript 数组 sort() 之所以默认按字符串排序,既源于弱类型动态语言对异构数组通用性的早期权衡,也是 Web 生态向前兼容的必然结果。在日常开发中,只要牢记“对数值、复杂对象或本地化文本排序时,始终提供显式比较函数”,就能彻底避开字典序导致的排位反常,编写出逻辑稳固的代码。
React19的use()怎么读Promise?和useEffect取数有什么不同?
2026-11-12 14:17:20
为什么企业选择Node.js:全栈开发效率与统一技术栈优势
2026-11-12 12:08:38
JS负数取整陷阱:Math.floor与parseInt结果为何不同
2026-11-12 11:22:02
封装一个精准的JS四舍五入函数
2026-11-11 15:40:24
JS原生实现日期格式化:不依赖库的代码示例
2026-11-11 15:39:37