AI率检测原理:困惑度与突发性怎么识别生成文本
本文深入解析AI文本检测背后的技术机制,重点阐述困惑度(Perplexity)与突发性(Burstiness)的统计原理及其局限性。文章指出,现代检测器多采用组合特征的分类模型,检测分数仅反映文本与训练模式的相似度,而非绝对的作者身份概率。通过分析误报原因及适用边界,建议用户将检测结果视为辅助线索,结合写作过程证据进行综合判断,避免单一指标导致的误判。
AI率检测并非在文本中搜寻某种固定的“AI指纹”,而是评估其与检测器所习得的机器生成模式之间的相似程度。困惑度和突发性是理解早期统计检测方法的两把钥匙,但它们并不具备鉴定作者身份的能力。在解读结果时,更稳妥的做法是将其视为一种依赖于特定模型、语料库及阈值的参考信号,并结合实际的写作过程进行综合判断,而非简单地将一个百分比数值当作最终结论。
困惑度衡量文本对模型来说有多可预测
语言模型的核心机制是基于前文语境为下一个词分配概率。如果一段文本中的词汇大多是模型认为常见且符合逻辑的后续内容,其平均意外程度便较低;反之,若模型难以预测这些词汇,意外程度则较高。困惑度(perplexity)正是将这种平均意外程度转化为更直观数值的一种汇总指标。其常见定义是对每个词的负对数概率取平均值,随后进行指数运算。
需要注意的是,该数值始终相对于特定的打分模型、分词方式以及文本处理流程而言。即便同一段文字,若更换模型、语言或应用领域,结果也可能大相径庭。虽然AI生成的文本有时更容易被某些语言模型预测,但这并不意味着所有模型都能稳定地识别它;同样,人类写作若大量使用常见句式、固定术语或标准化表达,也可能表现出极高的可预测性。因此,困惑度描述的是文本与模型预期之间的匹配关系,并不能直接指明作者是谁。
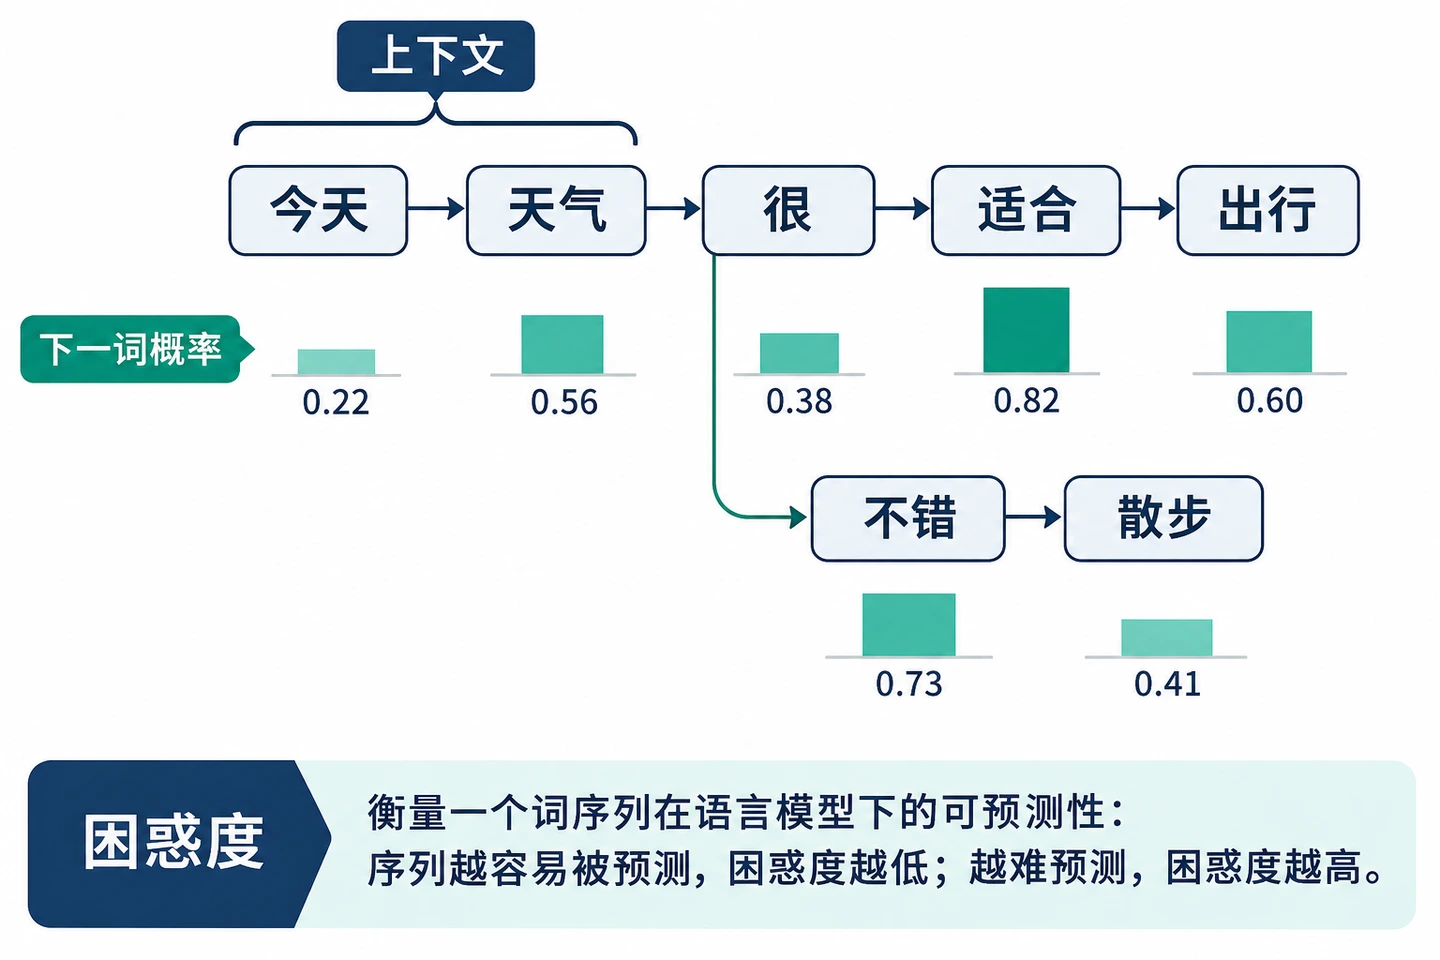
困惑度概括模型对后续词的可预测程度
突发性关注句子之间的节奏变化
“突发性”(burstiness)通常用于描述文本内部变化的显著程度,例如句子长度、用词选择或概率分数在相邻部分之间的起伏波动。如果每句话的结构和长度都高度一致,某些检测方法会将这种平稳的节奏视为机器文本的特征之一;相反,若长短句交替出现、表达方式变化丰富,则表现为更高的波动性。
然而,不同工具对“突发性”的定义未必对应同一套固定公式。有的工具统计句长变化,有的则观察句子级的困惑度或其他特征。因此,不能仅凭“突发性低”就断定文本由AI生成。说明文、产品介绍、法律条款或模板化报告本身就具有节奏整齐的特点;而人类创作的随笔也不一定句句都有巨大变化。
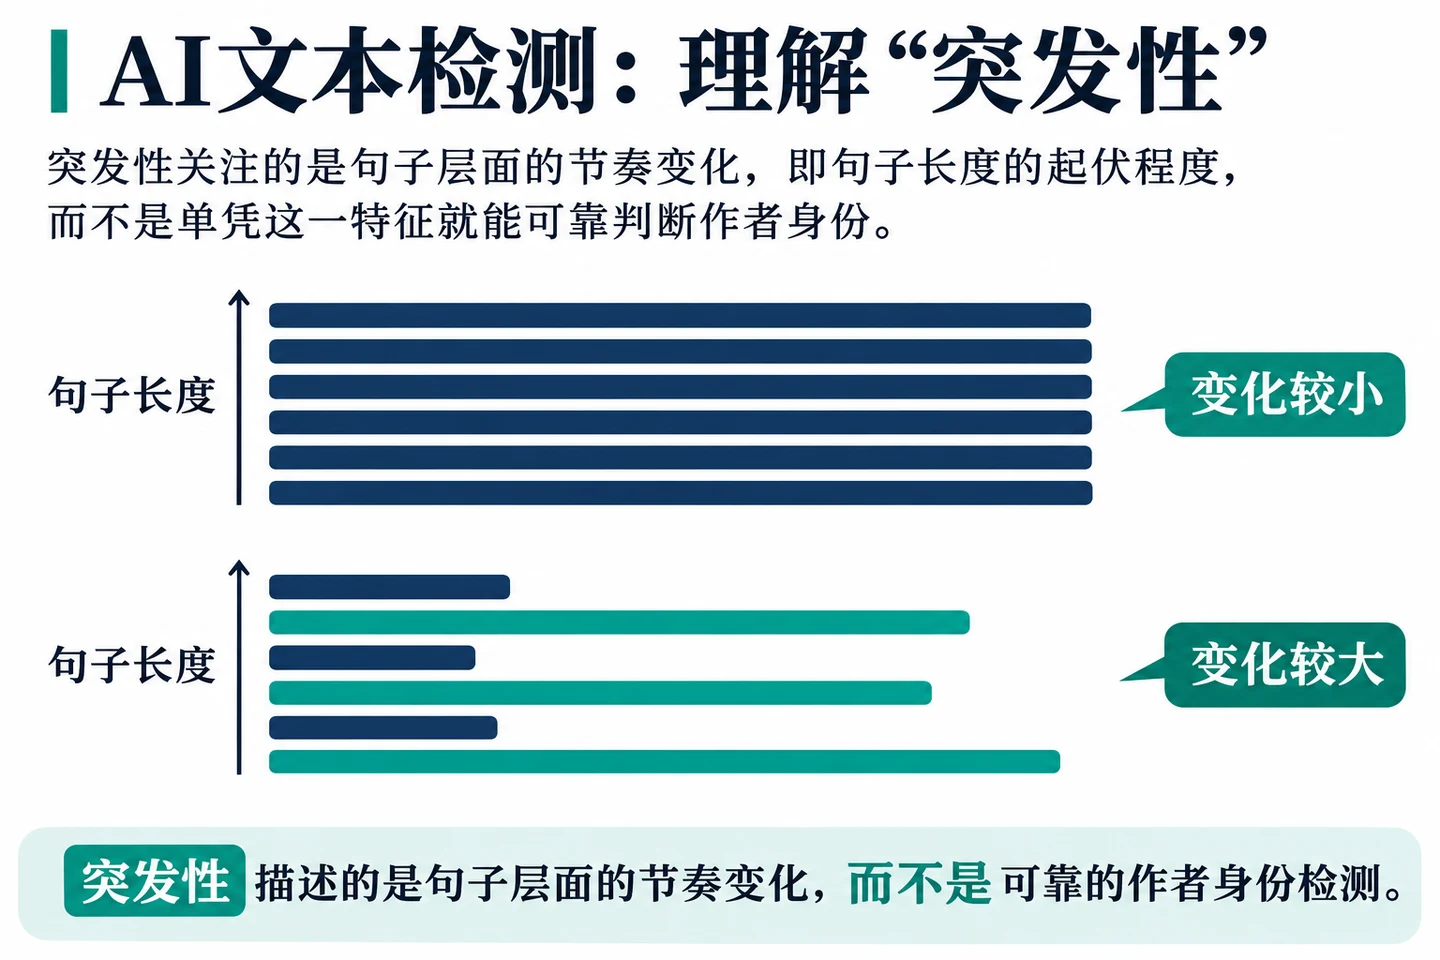
突发性描述文本节奏变化的一种直觉
实际检测往往组合多类特征
现代检测器通常利用带标签的数据训练分类模型,使其从海量人工文本和机器生成文本中学习差异。提取的特征可能涉及词语概率、句法结构及重复模式,也可能由神经网络直接从上下文表示中提取。虽然困惑度和突发性有助于解释部分统计直觉,但它们并不能代表每个产品内部的实际算法。供应商往往还会根据自身的训练语料、模型版本及应用场景,对分类器及阈值进行调整。
因此,“检测器认为像AI”更准确的理解是:输入文本与其当前所学到的一类模式高度相似。它无法仅凭单次输入还原作者身份、写作时间或所使用的具体工具。经过改写、翻译、人工编辑,或者转换为训练数据中较少见的体裁和领域,文本特征都可能发生改变,从而导致检测结果随之波动。
检测分数不等于作者身份概率
许多产品将结果显示为百分数或颜色标识,但这种展示形式本身并不能证明该数值是经过校准的“AI写作概率”。它可能是分类器的原始分数、句子级标记的汇总,或是产品自定义的风险区间;不同工具的数值通常不具备直接横向可比性。即使某个模型在特定测试集上表现优异,一旦更换语言、文本长度、题材或生成模型,其误报率和漏报率也会发生变化。
此外,还需考虑基础比例的影响:当待检文本中真正由AI生成的比例极低时,即便检测器具有一定的识别能力,少量的误报也可能占据所有“阳性结果”的相当大部分。OpenAI曾公开说明其早期文本分类器准确率偏低并停止提供该工具,这表明检测能力不能仅看一个漂亮的分数。研究还记录过检测器对特定非母语英语写作的误判问题。这一发现虽不能简单外推至所有语言和产品,但提醒我们:整齐、简短或词汇范围较窄的写法,可能是作者的语言习惯,而非机器生成的确凿证据。
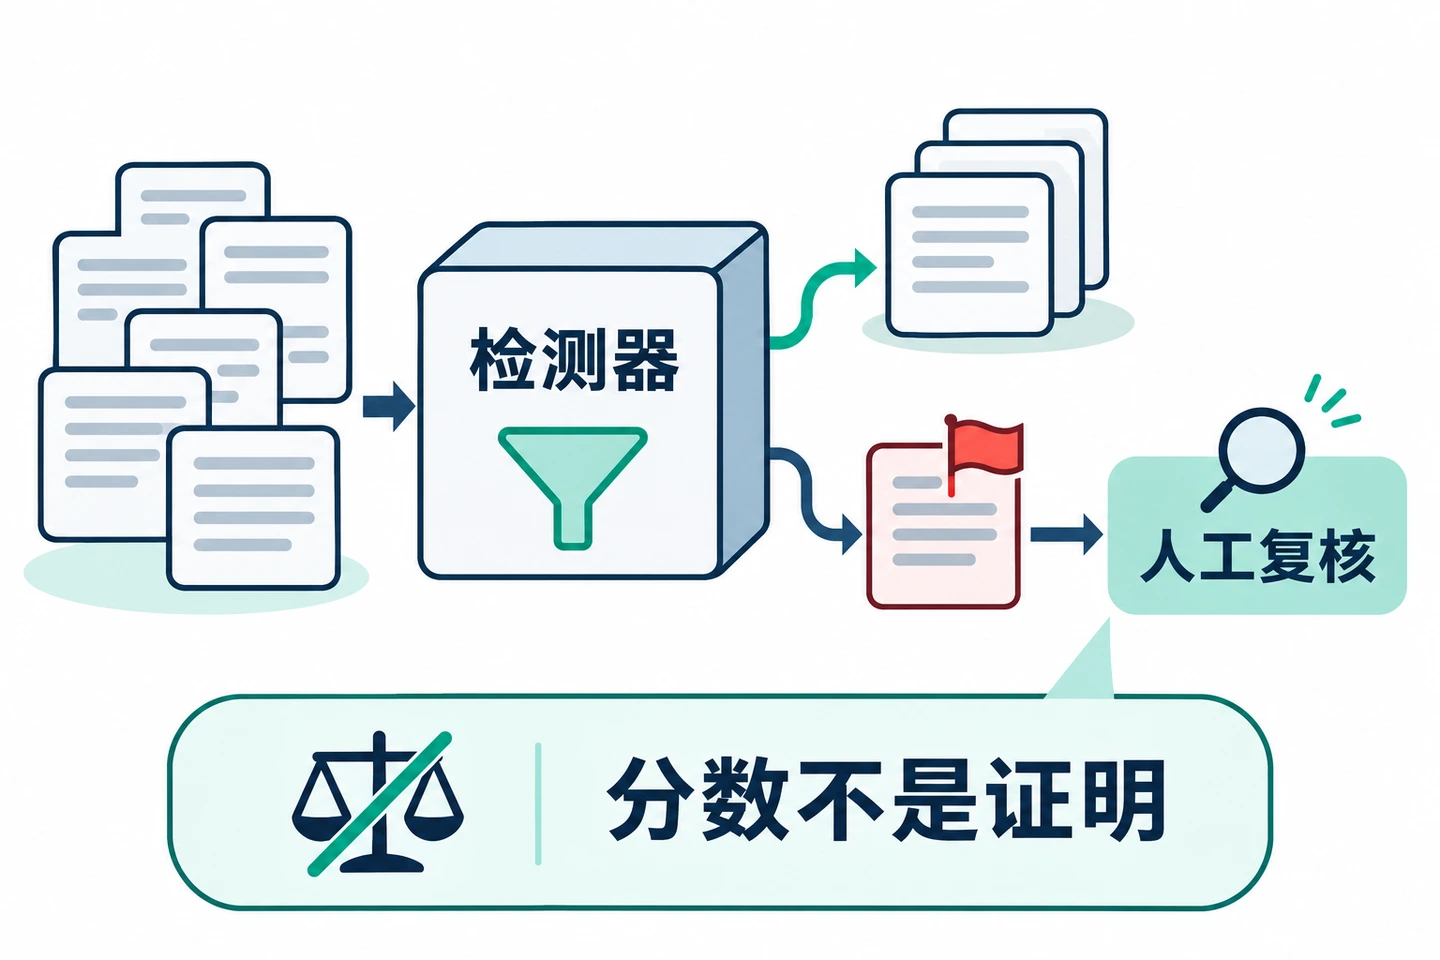
检测结果可作为人工复核线索
哪些场景更容易让结果失真
短文本因可供统计的上下文有限,少量常见词或固定表达就可能左右判断结果;长文本虽然提供更多线索,但其体裁、主题和作者风格仍会影响特征分布。代码、列表、表格、引用以及术语密集的技术说明,也与普通散文存在显著差异。如果检测器主要在某类文章上训练,将其用于检查另一种格式时,结论可能会变得不稳定。
同样,人工写作并非总是表现为“低概率、高变化”,机器文本也不总是“高概率、低变化”。人类作者会套用模板、模仿规范文风并反复修改;模型输出也能通过提示词工程、后期编辑或混合写作呈现出截然不同的语言特征。若将某个检测分数作为唯一依据,很容易将这些正常差异误认为是作者身份的证明。
把检测结果当线索,而不是定论
如果检测结果会影响评价或处理决策,建议先确认该工具对目标语言、文本长度和体裁是否有公开的适用说明,并仔细查看其标出的具体段落及置信度表达。可以将检测结果与草稿版本、修改记录、引用来源以及作者对写作过程的说明放在一起核对;这些材料在说明创作过程方面的能力,通常比单个总分更为具体和可靠。
若需比较不同工具的性能,应使用同一批来源明确的文本,分别计算误报率和漏报率,并详细记录阈值、语言、体裁和样本长度等条件。不要只挑选个别案例,也不要将某个厂商在自有测试集上的数据视为所有场景的保证。对于普通读者而言,理解原理的关键在于分清两点:检测器可以估计模式相似度,但仅凭相似度无法可靠地证明具体作者身份。
Flux.1 Pro、Dev、Schnell 版本有什么区别?AI 绘画模型选型指南
2026-11-08 12:07:58
Gemini Pro与Ultra版本在深度研究能力上有何区别?
2026-11-07 22:43:09
Stable Diffusion提示词基础语法与结构详解
2026-11-07 17:08:15
Stable Diffusion提示词无效或画面崩坏怎么办?常见原因及修正方法
2026-11-07 15:27:33
Gemini深度研究是什么?核心能力与适用场景解析
2026-11-07 14:26:41