JS数组末尾添加元素:push方法与展开运算符的区别
深入解析JavaScript中向数组末尾添加元素的两种核心方案:Array.prototype.push()与展开运算符(...)的本质区别。从可变性、返回值、内存引用模型、执行步骤、性能复杂度及现代框架状态管理等方面提供清晰对照与选型建议。
Array.prototype.push() 方法和使用 ES6 的展开运算符(...)。两者的本质区别在于是否修改原数组与返回值类型:push() 会在原内存块上直接追加元素(原地可变修改),并返回操作后的数组最新长度;而展开运算符(如 [...arr, item])则通过浅拷贝机制创建一个全新的数组实例,原数组保持不变。理解这两者的机制差异,是避免状态更新失效、防止意外副作用以及优化高频计算性能的关键。
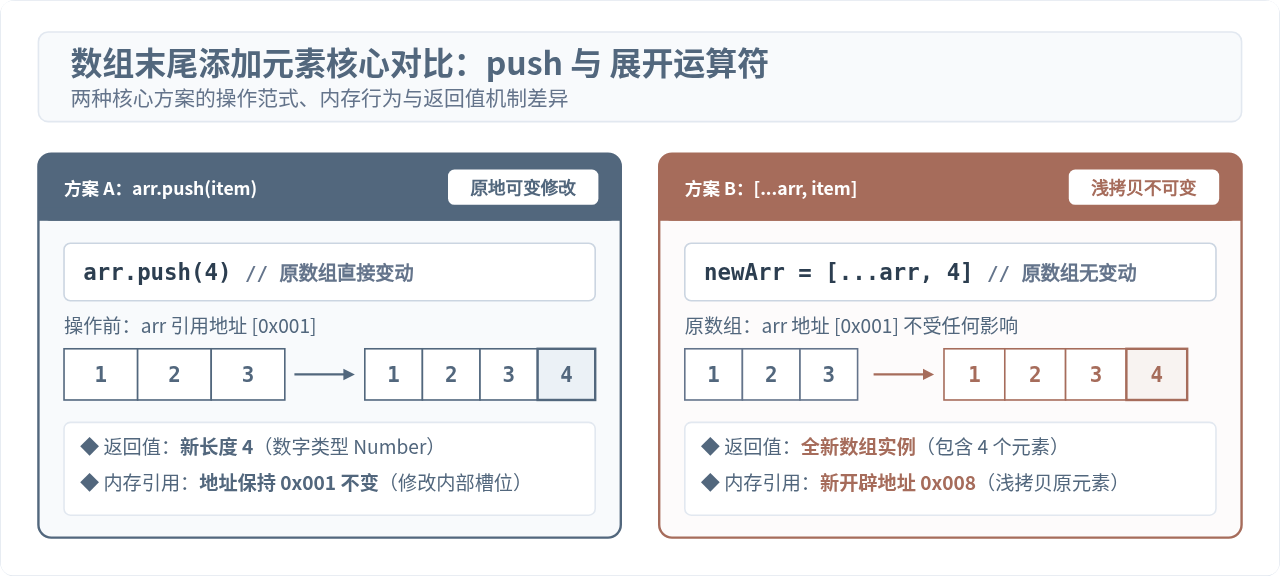
一、基础语法表现与返回值差异
在日常开发中,向数组末尾添加一个或多个新项是最基础的数据操作。尽管 push() 和展开运算符都能达成“在末尾放入数据”的最终视觉效果,但两者的代码书写习惯与执行反馈截然不同。
1. push() 方法:原地修改与长度反馈
push() 是 JavaScript 早期即存在的内置原型方法。当调用该方法时,解释器直接操作调用该方法的原始数组对象,将传入的参数依次追加到数组末尾。
// 准备初始数组
const fruits = ['苹果', '香蕉'];

// 调用 push 方法并接收其返回值
const pushResult = fruits.push('橙子');

console.log('fruits 数组内容:', fruits);
console.log('push 方法返回值:', pushResult);
console.log('返回值类型:', typeof pushResult);
需要特别注意:push() 的返回值是一个整数,代表数组变动后的最新长度,而不是变动后的数组本身。许多初学者常犯的错误是编写类似 const nextList = list.push(item) 的代码,导致 nextList 意外拿到数字 3 而非数组。
2. 展开运算符:不可变模式与新实例生成
从 ECMAScript 2015 (ES6) 开始引入的展开运算符(Spread Operator,形式为 ...),允许在数组字面量构建过程中将可迭代对象的元素“解开”。向末尾追加元素时,通常写作 [...originalArray, newElement]。
// 准备初始数组
const fruits = ['苹果', '香蕉'];

// 使用展开运算符构建新数组
const newFruits = [...fruits, '橙子'];

console.log('原 fruits 数组:', fruits);
console.log('新 newFruits 数组:', newFruits);
console.log('两者引用是否相同:', fruits === newFruits);
可以看到,原始数组 fruits 的内容没有任何变动,依然只有两个元素;而表达式运算的结果直接返回了一个包含 3 个元素的全新数组,且两者的内存引用比对结果为 false。
二、底层内存机制:原地突变与浅拷贝开辟
要透彻理解两者的差异,必须深入 JavaScript 虚拟机的堆栈内存模型。JavaScript 中的数组是引用类型(Object),变量名在执行栈中保存的是指向堆内存中具体存储块的地址指针。
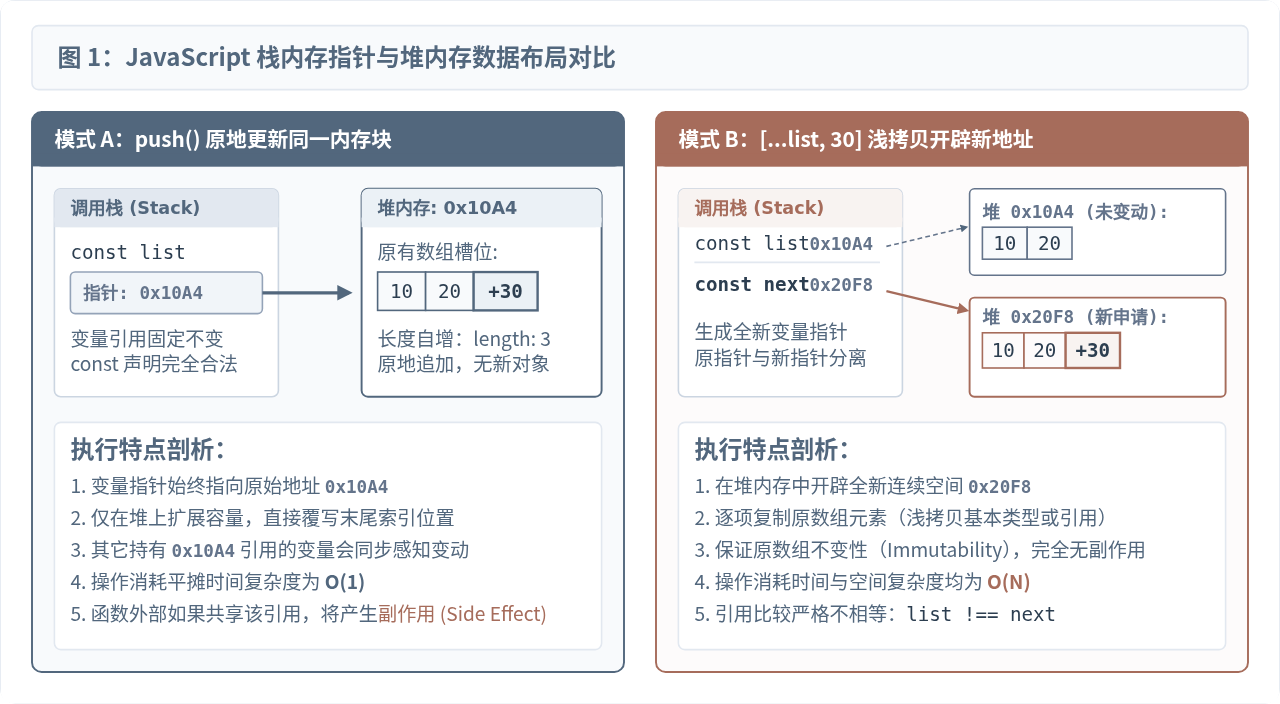
结合图 1 可以清晰看到两种方式在内存分配上的本质差异:
-
push()的内存行为:变量名存储的堆内存指针地址始终未变(图示中为0x10A4)。JavaScript 引擎在已有的连续内存区后方扩展存储槽位,直接将新值写入。正因为堆地址没变,即使用const声明的数组,调用push()也不会触发常量赋值报错。但是,如果有其他变量(例如const alias = list)共享了同一地址,修改也会立刻在该变量上显现。 -
展开运算符的内存行为:解释器在堆内存中申请了一块全新的连续存储空间(图示中为
0x20F8)。引擎首先读取原数组的每一个槽位并复制到新内存中,随后在新内存末尾追加目标项,最后将新内存地址指派给新变量。这属于典型的浅拷贝(Shallow Copy)过程。
[{ id: 1 }]),新旧数组各自的容器地址虽不同,但内部对应的对象仍旧指向同一份堆数据。修改新数组中的对象属性依然会影响原数组对应对象。
三、执行步骤推导与内部生命周期
从底层规范(ECMAScript Specification)的执行步骤来看,两者的运行链路体现了完全不同的处理逻辑。
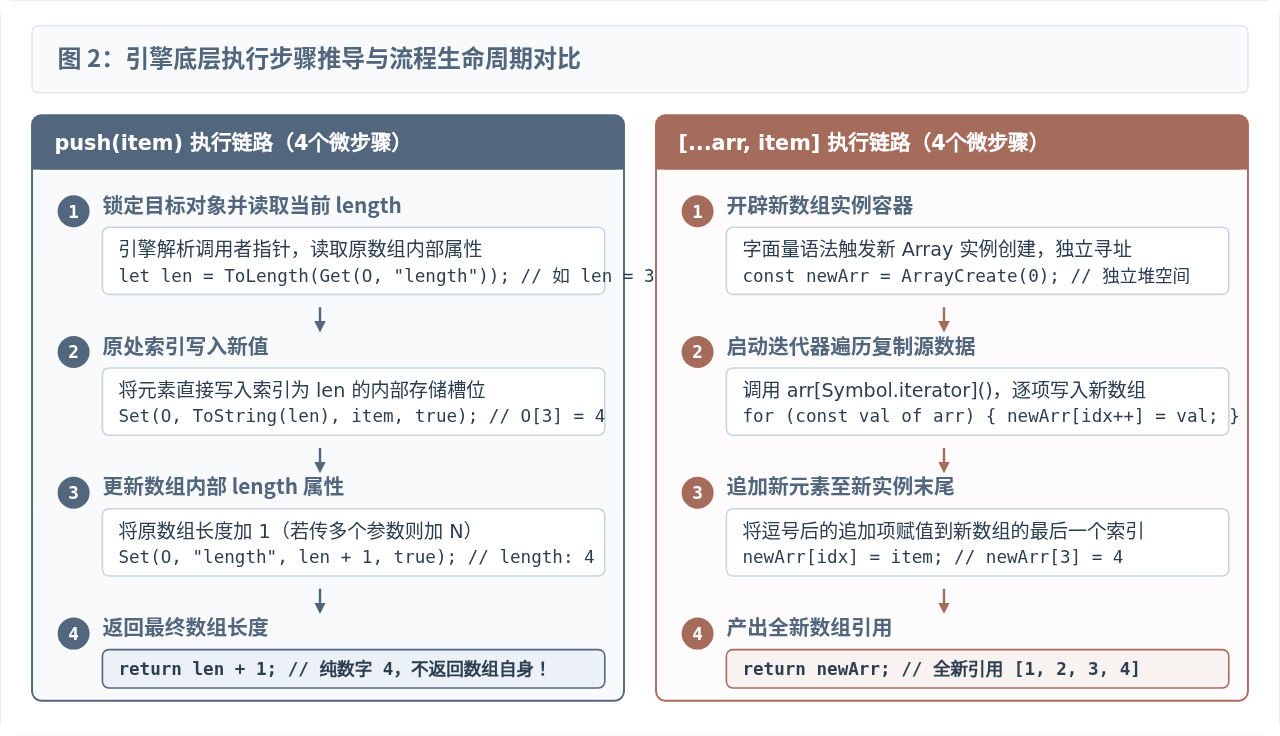
按照图 2 所展示的执行序列,我们可以将两者的内部步骤拆解如下:
-
第一步(源锁定与容器准备):
push()只需要通过内部方法ToLength(Get(O, "length"))读取当前数组的长度值;展开运算符则需先触发数组字面量初始化,在堆中分配全新的数组容器。 -
第二步(数据同步):
push()无需复制原有数据,因为数据本来就驻留在当前容器;展开运算符必须调用原数组的默认迭代器arr[Symbol.iterator](),循环N次将原有元素逐一填入新容器。 -
第三步(新值写入):
push()将新参数写入O[len]处,并自增长度属性;展开运算符将新参数赋值给新容器的newArr[len]处。 -
第四步(产物交付):
push()最终返回纯数字(len + 1);展开运算符返回新数组实例的引用。
四、现代前端框架中的选择:React / Vue 的响应式陷阱
在现代前端工程开发(如 React、Vue 3、Redux 等)中,为什么社区几乎一致提倡使用展开运算符,甚至对 push() 设立 ESLint 限制?核心原因在于不可变数据模型(Immutability)与视图响应机制的联动。
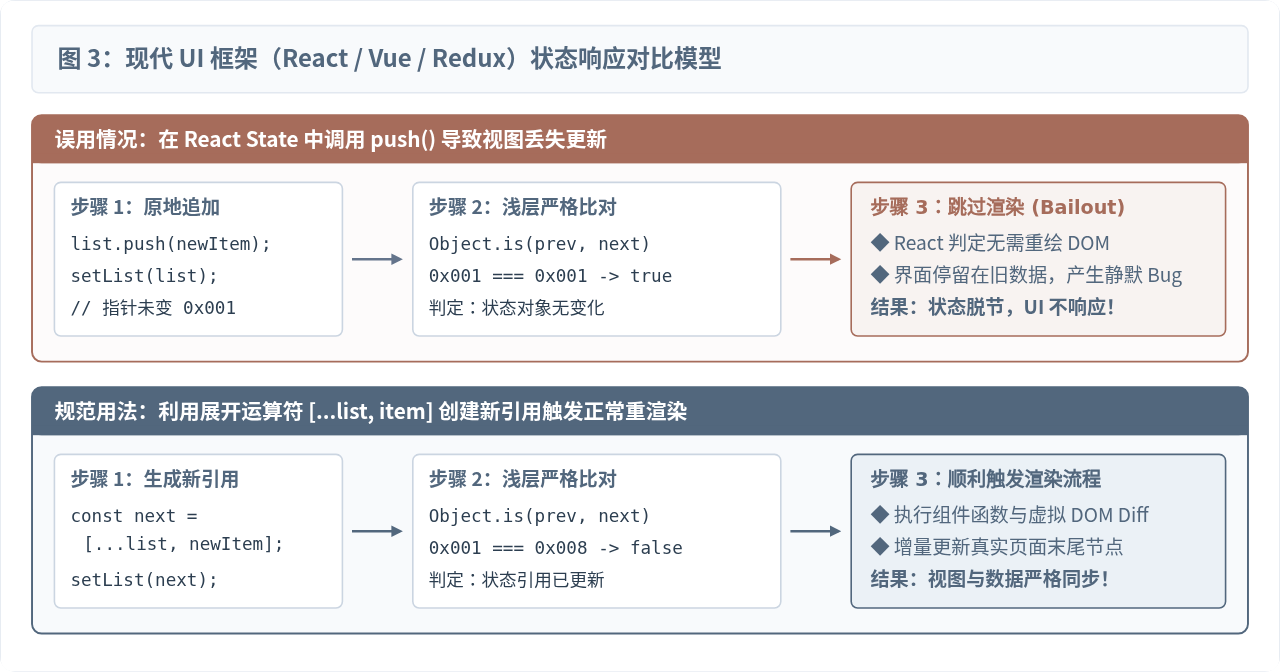
1. React 为什么会因 push() 丢失更新?
React 的 Hooks(如 useState)在决定是否重新渲染组件时,使用的是基于 Object.is() 的浅层严格比较。如果新旧状态的内存引用相同,React 会判定“数据并未改变”,为了节省性能将直接跳过渲染(Bailout)。
import React, { useState } from 'react';

function TodoList() {
  const [todos, setTodos] = useState(['写代码', '读书']);

  const handleAddPush = () => {
    // 错误示范:原地修改原数组
    todos.push('跑步');
    // setTodos 传入的是相同引用 (todos === todos 为 true)
    setTodos(todos);
    // 结果:React 判定引用未变,页面不会重新渲染!
  };

  const handleAddSpread = () => {
    // 正确示范:生成全新引用
    setTodos([...todos, '跑步']);
    // 结果:引用发生变化 (prev !== next),成功触发组件重新渲染并更新 DOM
  };

  return (
    <div>
      <ul>{todos.map((item, idx) => <li key={idx}>{item}</li>)}</ul>
      <button onClick={handleAddPush}>错误添加 (无更新)</button>
      <button onClick={handleAddSpread}>正确添加 (展开运算符)</button>
    </div>
  );
}
正如代码所示,在 React 环境下使用 push() 传入相同的状态指针,会引发严重的界面假死现象;而展开运算符生成的全新引用打破了浅比较相等性,确保了 UI 与数据的完全一致。
2. Vue 3 与 Redux 的考量
在 Vue 3 中,通过 reactive 或 ref 包装的响应式数组重写了 push 等变更方法,调用 push() 依然能触发依赖更新。但在 computed 属性内部或使用 Pinia 纯函数状态处理时,仍推荐保持数据不可变规范。而在 Redux 中,Reducer 必须作为纯函数(Pure Function),严格禁止任何形式的原地突变,因此展开运算符是不可动摇的书写准则。
五、性能消耗与边界陷阱
虽然展开运算符在数据流管理上非常优雅,但这并不意味着它可以无条件取代 push()。在算法题、高吞吐服务端处理或大型数据渲染中,两者的复杂度差异显著。
1. 时间与空间复杂度量级
-
push()的复杂度:由于无需重新开辟完整数组并迁移旧数据,push()的单次追加耗时为平摊 O(1),内存开销为 O(1)。在处理数十万次循环累加时速度极快。 -
展开运算符的复杂度:每一次执行
[...arr, item],虚拟机都需要遍历原数组的全部N个元素并完成复制,其时间复杂度为 O(N),额外空间复杂度为 O(N)。
push() 仅需数毫秒;而若在每次循环中都使用 arr = [...arr, item],累积时间复杂度将达到 O(N²),耗时可达数秒甚至直接导致垃圾回收(GC)频繁卡顿或内存溢出。
2. 批量追加时的调用栈溢出(Call Stack Overflow)
当向现有数组末尾批量合并另一个大数组时,开发者有时会使用展开运算符作为 push() 的参数,例如 arr.push(...largeArray)。
这种写法存在致命陷阱:JavaScript 引擎对函数传参的个数有最大上限(调用栈参数限制)。在多数 V8 引擎环境下,参数个数上限约为 65,536。如果 largeArray 包含 100,000 个元素,执行 arr.push(...largeArray) 将直接抛出 RangeError: Maximum call stack size exceeded。此时,合并操作应当改用 arr.concat(largeArray) 或分块循环 push()。
六、技术选型决策树与综合对比
在实际项目编码中,如何明确判断何时该用 push(),何时该用展开运算符?可以遵循图 4 的决策逻辑:
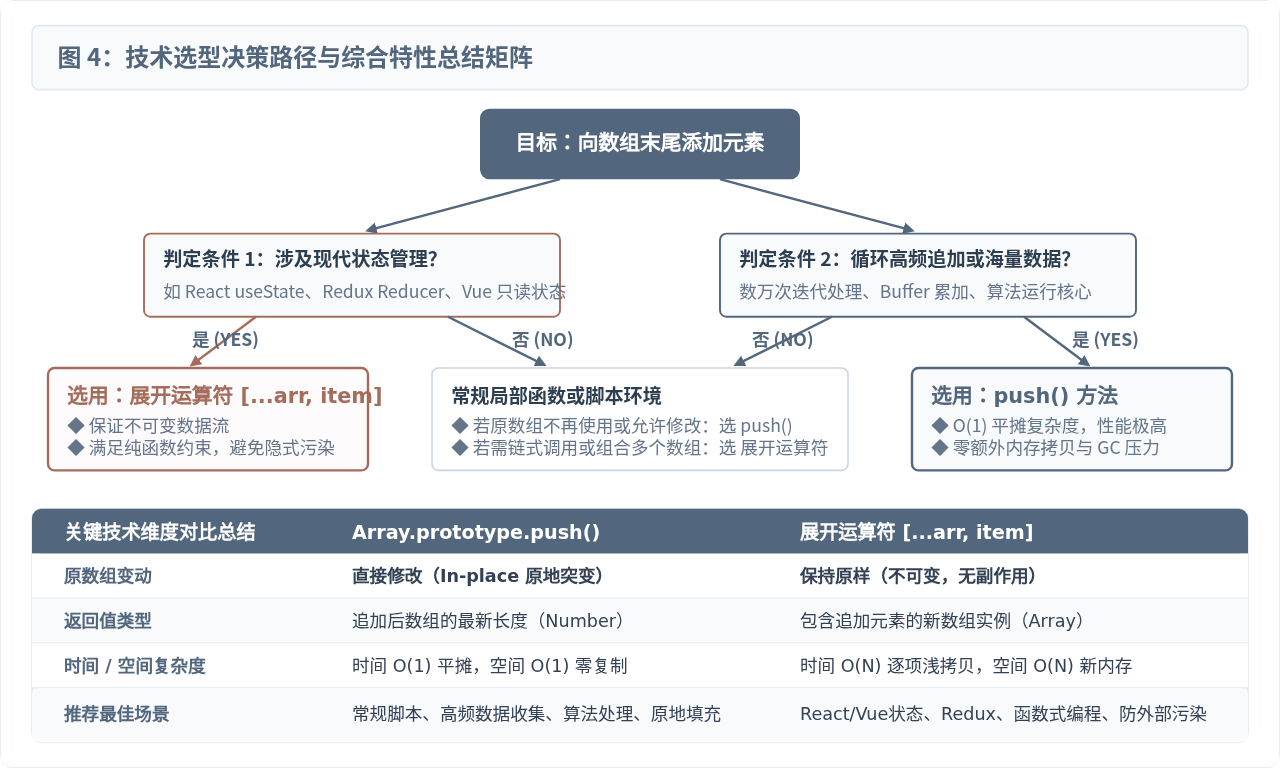
| 对比维度 | Array.prototype.push() | 展开运算符 [...arr, item] |
|---|---|---|
| 原数组影响 | 直接修改(In-place 原地变动,影响所有引用该地址的变量) | 完全不变(生成全新数组副本,原数组零副作用) |
| 方法返回值 | 数字(Number),即追加后的数组新长度 | 数组实例(Array),即包含新元素的新数组 |
| 时间复杂度 | 平摊 O(1),极高执行效率 | O(N),随原数组长度线性增长 |
| 空间与内存开销 | O(1),复用现有堆槽位,零多余垃圾回收 | O(N),需连续分配新内存并浅拷贝旧元素 |
| UI框架兼容性 | 无法触发 React/Redux 等浅比较响应更新,易产生视图假死 | 完美契合不可变数据流规范,精准驱动组件重新渲染 |
| 代码灵活性 | 只能在末尾或通过 unshift 在头部追加 |
可任意穿插,如 ['首项', ...arr, '中间', ...other, '末尾'] |
| 推荐使用场景 | 高频循环内部、局部私有数据处理、底层算法与性能敏感路径 | React/Vue 状态声明、纯函数开发、对外暴露接口防止数据被污染 |
最佳实践建议
- 编写纯函数或状态更新时:坚决使用展开运算符
[...arr, item],保障函数没有副作用,确保系统状态可预测、可追溯。 - 局部封闭的高频运算与数据构建时:在函数内部初始化临时数组并使用
push(),运算完成后再返回该数组。这兼顾了极致的执行性能与对外部调用者的安全封装。 - 注意返回值:切记
push()返回的是长度数字,不要用于链式调用或直接赋值给期望得到数组的变量。
ES6+新特性实例:解构赋值、箭头函数与模板字符串用法
2026-11-06 21:33:48
JS数组push、unshift与concat的区别及性能对比
2026-11-06 15:17:38
JS数字转字符串的三种常用方法:toString、String与拼接
2026-11-06 10:33:30
JS保留两位小数:toFixed、Math.round与自定义函数的对比选择
2026-11-06 10:22:42
使用 JavaScript 定时器实现防抖和节流函数
2026-11-05 23:19:12