兼容旧环境:JS数组去重的传统循环与filter写法
深入解析在不支持ES6 Set的旧运行环境中,如何使用传统的双重循环、ES5 filter与indexOf以及对象哈希表实现高效稳定的JavaScript数组去重,涵盖原理、边界条件与性能对比。
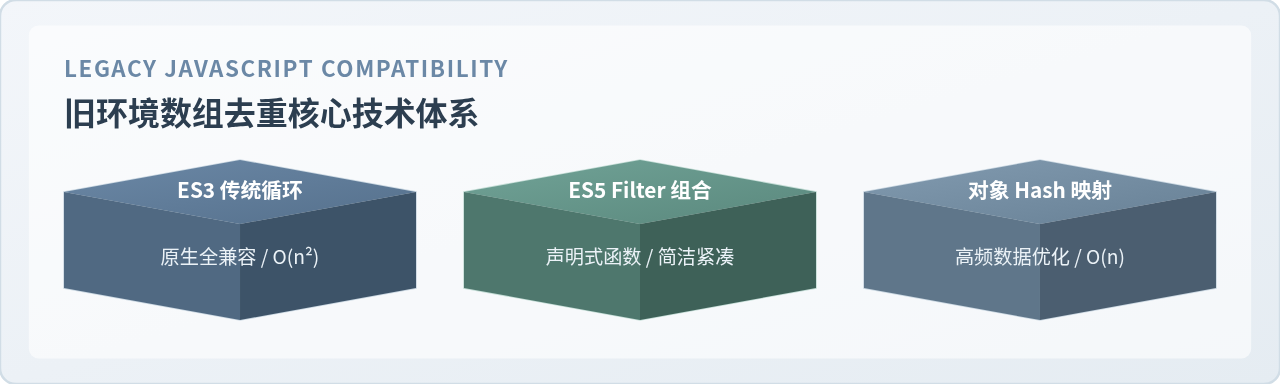
Set 与 Array.from 无法直接运行。解决该问题的经典途径主要为两类:纯基于 ES3 语法的传统双重循环,以及基于 ES5 数组拓展 API 的 filter 与 indexOf 组合写法。本文直接梳理这两种模式的实现细节、底层执行推导、兼容边界与性能选型。
一、ES3 传统循环去重:零依赖的通用解法
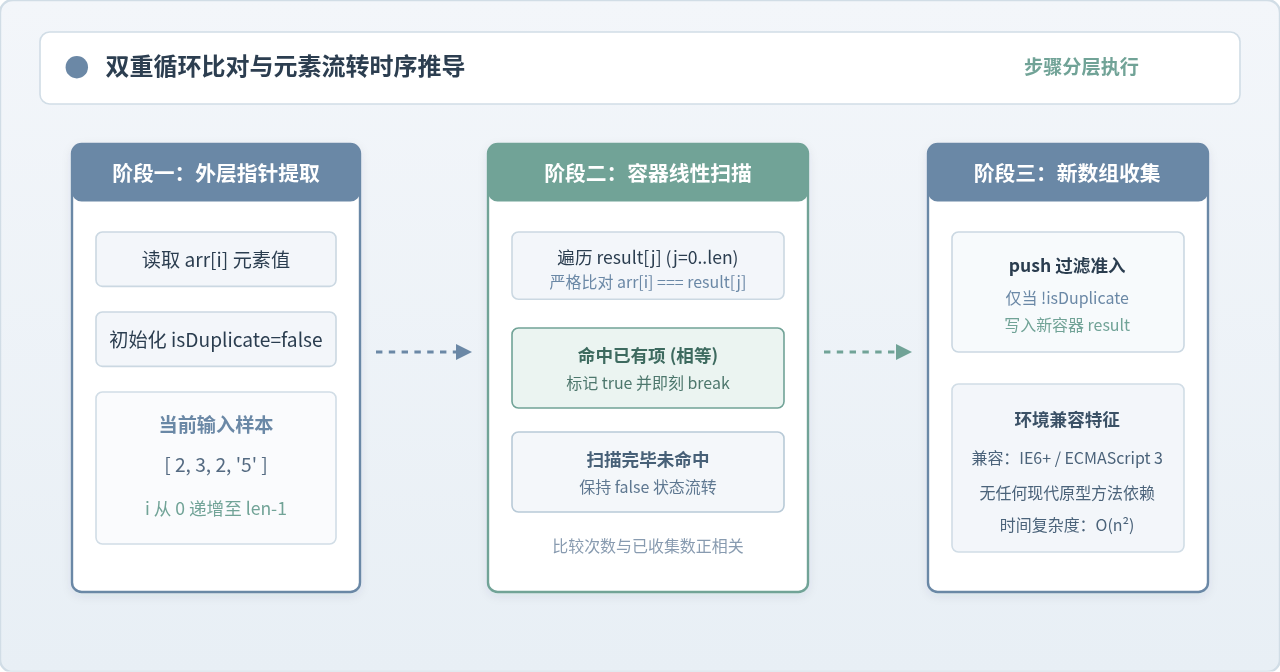
传统循环去重的核心思想是:创建一个空的新数组作为容器,通过外层 for 循环依次取出原数组元素,再通过内层循环在结果容器中检索当前元素是否已经存在;若不存在则放入结果容器中,若存在则跳过。
1. 经典双重循环实现代码
/**
 * 基于 ES3 双重循环的数组去重
 * @param {Array} arr 待去重的原始数组
 * @returns {Array} 去重后的新数组
 */
function uniqueTraditional(arr) {
    if (!arr || !arr.length) {
        return [];
    }
    var result = [];
    var i, j;
    var len = arr.length;
    var isDuplicate;

    for (i = 0; i < len; i++) {
        isDuplicate = false;
        // 在结果容器中检索当前元素是否已写入
        for (j = 0; j < result.length; j++) {
            if (arr[i] === result[j]) {
                isDuplicate = true;
                break;
            }
        }
        // 若遍历完毕未发现重复项,则压入结果数组
        if (!isDuplicate) {
            result.push(arr[i]);
        }
    }
    return result;
}

// 示例调用
var sourceList = [1, '1', 2, 3, 2, 'test', 'test'];
var filteredList = uniqueTraditional(sourceList);
// 结果:[1, '1', 2, 3, 'test']
2. 代码细节与执行逻辑
上述代码中使用 === 严格相等判定,因此能准确区分数字 1 与字符串 '1'。在早期的 ES3 环境(如 IE6~IE8)中,该写法完全不依赖任何原型链新方法,具备 100% 的兼容性。
为了减少每次内层查找时的重复运算,外层预先缓存了 len = arr.length。此外,一旦内层循环命中相同元素,立刻通过 break 提前跳出,避免多余的遍历。
二、ES5 filter 与 indexOf 组合写法:声明式精简方案
随着 ECMAScript 5 (ES5) 标准的推出,现代 JavaScript 引擎增加了 Array.prototype.filter 和 Array.prototype.indexOf。借助这两个函数,开发者可以用一行核心代码完成去重。
1. 核心写法与实现原理
/**
 * 基于 ES5 filter + indexOf 的数组去重
 * @param {Array} arr 原始数组
 * @returns {Array} 去重后的新数组
 */
function uniqueFilter(arr) {
    if (!arr || !arr.length) {
        return [];
    }
    return arr.filter(function (item, index, self) {
        // 当元素第一次出现的索引值等于当前遍历索引时保留
        return self.indexOf(item) === index;
    });
}

// 示例验证
var tags = ['js', 'css', 'html', 'js', 'html'];
var uniqueTags = uniqueFilter(tags);
// 输出:['js', 'css', 'html']
2. 为什么是 self.indexOf(item) === index?
filter 的回调函数接收三个参数:当前遍历的元素 item、当前元素在原数组中的下标 index 以及原数组本身的引用 self。
indexOf(item) 的关键特性是:始终返回该元素在数组中“第一次出现”的索引位置。
- 当首次遍历到某个元素时,该元素的当前索引
index一定与其第一次出现的索引一致,条件成立,元素被保留。 - 当后续再次遇到相同元素时,
index已经递增,但self.indexOf(item)返回的依然是首个元素的较小下标,两者不相等,返回false,重复项被剔除。
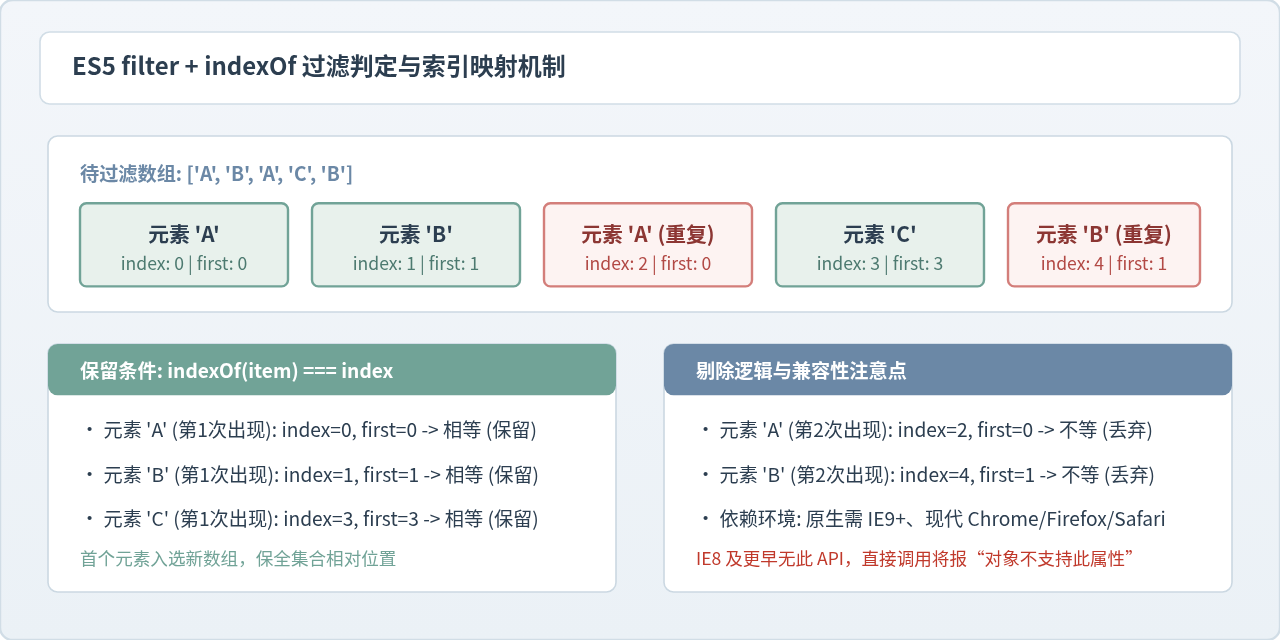
Array.prototype.filter 和 Array.prototype.indexOf 属于 ES5 特性。在 IE8 及以下浏览器中直接运行会抛出 TypeError: Object doesn't support property or method。若项目必须支持 IE8,需要预先引入 ES5-shim polyfill,或者直接回退使用第一节的传统 for 循环写法。
三、性能升级方案:旧环境下的对象哈希(Hash Map)去重
无论双重循环还是 filter + indexOf,底层本质上都是双层遍历,其算法时间复杂度均为 O(n²)。如果待处理数组包含数万条数据,页面在旧版浏览器中会出现明显卡顿。
在没有 ES6 Map 与 Set 的旧环境中,为了达到 O(n) 的线性时间,通常借助 JavaScript 对象的哈希键值对作为查找表。
1. 键名冲突与类型丢失陷阱
JavaScript 对象的普通键名始终为字符串。如果直接将数组元素作为键名(如 hash[arr[i]] = true),数字 1 与字符串 '1' 会变成同一个键名 "1",从而导致类型被错误合并。
此外,如果数组包含对象 {},对象转换为字符串会变成 "[object Object]",多个不同的对象也会被误判为重复。
2. 安全的类型前缀哈希写法
解决方案是在键名前拼接数据类型的字符串前缀,即 typeof item + item。
/**
 * 兼容旧环境的安全对象哈希去重
 * @param {Array} arr 待去重数组
 * @returns {Array} 去重后的新数组
 */
function uniqueObjectHash(arr) {
    if (!arr || !arr.length) {
        return [];
    }
    var result = [];
    var hash = {};
    var len = arr.length;
    var i, item, key;

    for (i = 0; i < len; i++) {
        item = arr[i];
        // 关键:结合类型与序列化值生成唯一标识键
        key = typeof item + '_' + item;

        if (!hash[key]) {
            hash[key] = true;
            result.push(item);
        }
    }
    return result;
}

// 边界验证
var testArr = [1, '1', 2, '2', false, 'false', null, undefined];
var res = uniqueObjectHash(testArr);
// 输出:[1, '1', 2, '2', false, 'false', null, undefined] (均被正确区分)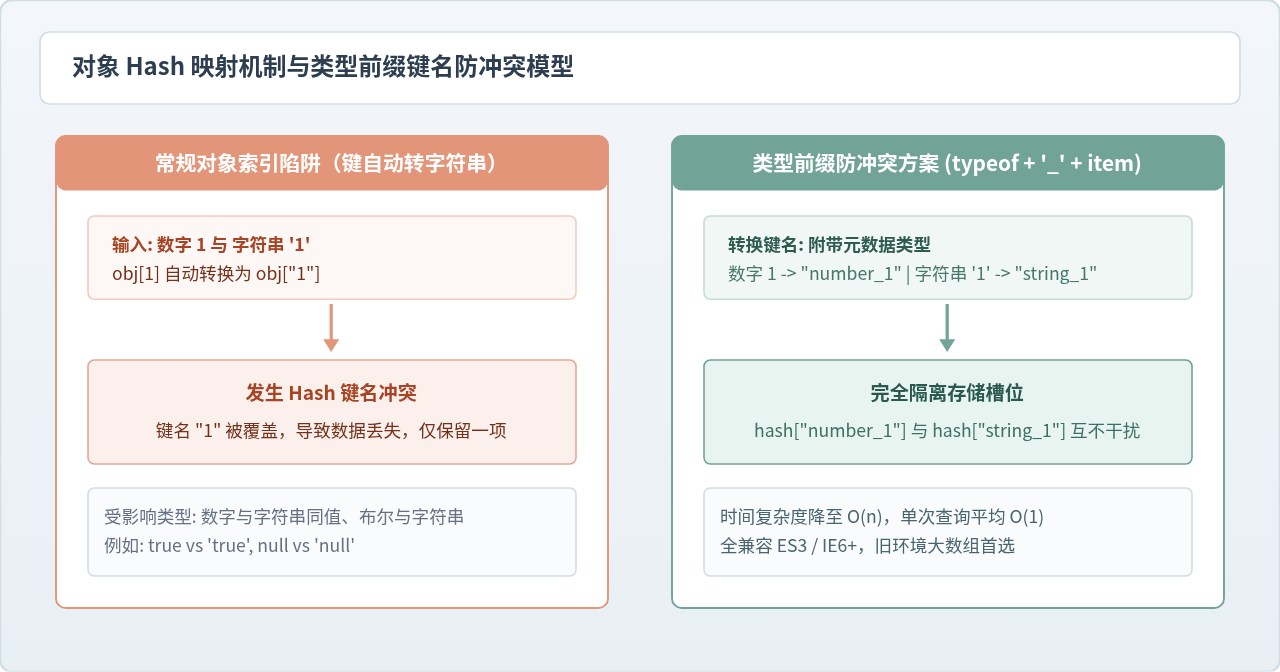
四、方案对比与选型决策
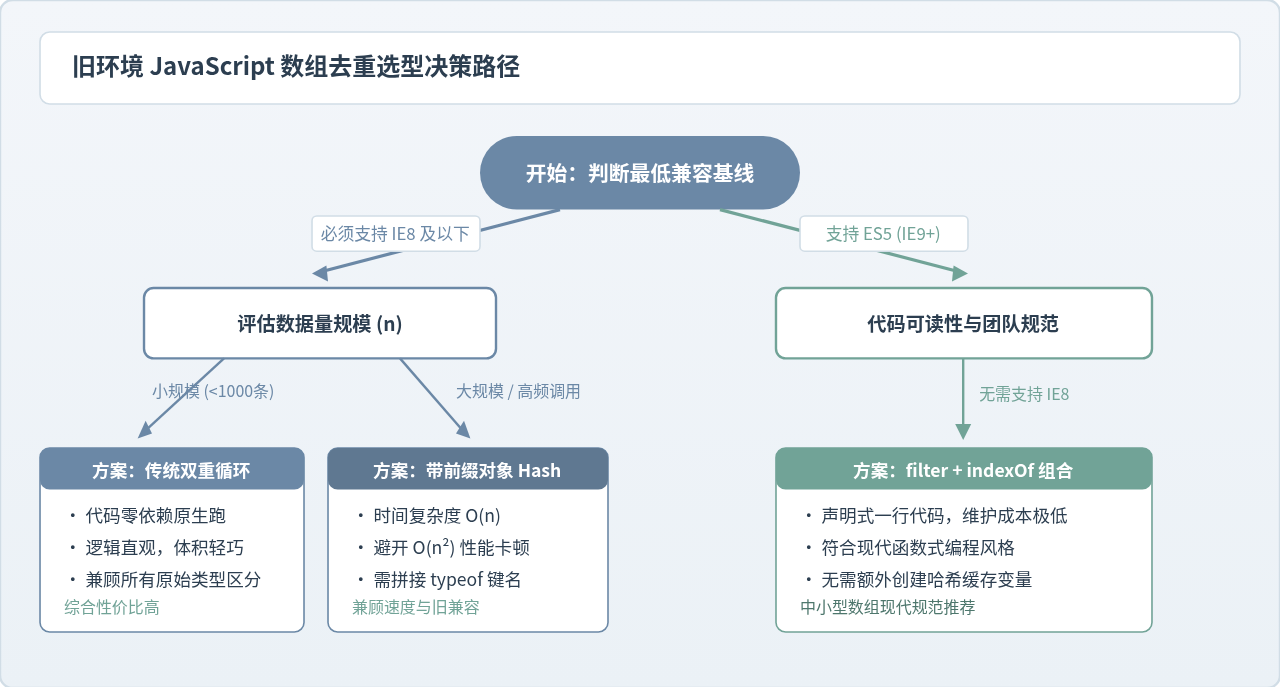
在旧环境项目中,选择何种去重方式应取决于目标运行环境的最低版本要求以及待处理数据量的大小。下表给出了三类旧环境主流方案的综合对比:
| 实现方案 | 规范要求 | 最低浏览器 | 时间复杂度 | 空间复杂度 | 类型隔离度 |
|---|---|---|---|---|---|
| 传统双重循环 | ECMAScript 3 | IE6+ / 无限制 | O(n²) | O(n) | 完整支持 (=== 区分) |
| filter + indexOf | ECMAScript 5 | IE9+ / 现代全量 | O(n²) | O(n) | 完整支持 (=== 区分) |
| 类型前缀对象哈希 | ECMAScript 3 | IE6+ / 无限制 | O(n) | O(n) 额外哈希表 | 较高 (支持基本类型区分) |
五、特殊边界与常见问题
在旧环境去重中,有几类特殊值需要额外注意:
1. NaN 的识别问题
在 JavaScript 中,NaN === NaN 返回 false。无论是传统双重循环还是 indexOf,都遵循该相等判定规则。这意味着:
- 使用传统双重循环时,多个
NaN每次比对都为false,因此所有的NaN都会被当成不重复项重复推入结果中。 - 使用
indexOf时,indexOf(NaN)永远返回-1,导致self.indexOf(item) === index永远不成立,所有的NaN都会被filter彻底过滤丢弃。
如果数据中可能包含 NaN 且需要去重后保留单个,需增加针对 NaN 的辅助判断标记(例如通过 item !== item 判定是否为 NaN)。
2. 对象与数组等引用类型的浅比对
上述所有算法均基于引用比对或浅层转义。如果数组元素为包含相同字段但处于不同内存地址的对象(例如 [{ id: 1 }, { id: 1 }]),=== 比对结果始终为 false,它们会被视作不同元素并保留下来。若要对对象数组去重,需提取具体的主键字段(如 item.id)作为判断基准。
总结
在不具备 ES6 特性的旧运行环境中:
- 如果必须向下兼容至 IE8 及以下版本,或者对体积有苛刻要求,传统双重循环是最具确定性、零依赖的稳健选择。
- 如果运行环境能保障 ES5 支持(IE9+),且数组长度在千级以内,
filter + indexOf组合具有最清晰的代码结构和最强的易读性。 - 如果面临大规模数据处理且受限于旧环境,使用带有
typeof类型前缀的对象哈希映射则是消除性能瓶颈的最佳解法。
JavaScript怎么遍历对象的Symbol键和不可枚举属性
2026-11-05 13:13:39
封装一个健壮的JS字符串判空工具函数
2026-11-05 12:16:14
JavaScript合并数组的三种常用方法:concat、扩展运算符与push
2026-11-05 11:22:29
JavaScript立即执行函数(IIFE)是什么及基本语法
2026-11-05 10:51:19
JS对象数组转字符串为什么推荐用JSON.stringify()
2026-11-05 09:40:31