

怎么将JS字符串按单个字符拆分为数组?
全面解析在JavaScript中将字符串按单个字符拆分为数组的主流方法与底层机制,深入剖析split('')、扩展运算符、Array.from与Intl.Segmenter在处理ASCII、生僻字代理对与复合Emoji时的差异与最佳实践。
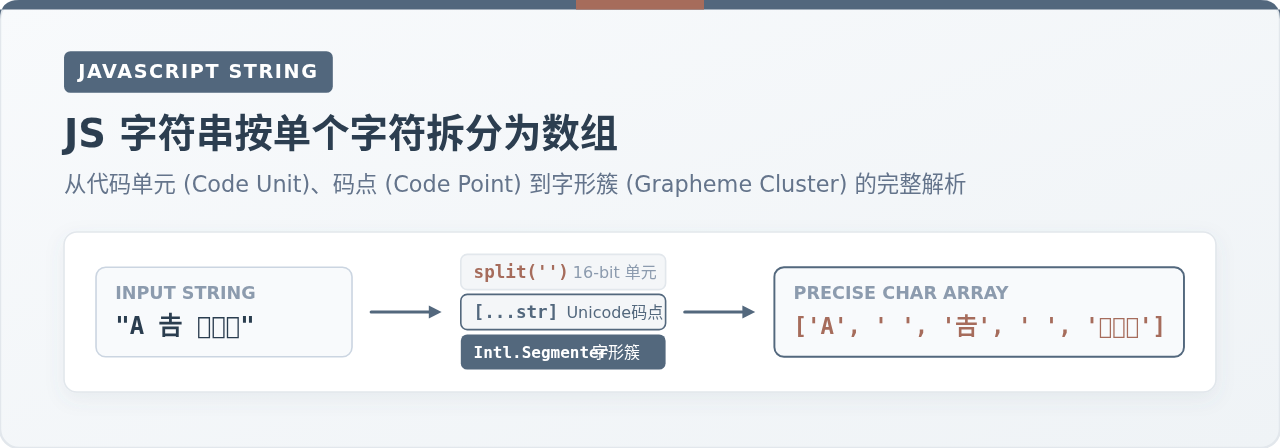
[...str] 或 Array.from(str);如果是纯 ASCII 字符串,也可以选用最轻量的 str.split('');而如果文本涉及复合 Emoji、肤色发型修饰符或组合音标等复杂符号,则应选用现代国际化标准 new Intl.Segmenter()。选用哪种方法,根本上取决于业务文本中“单个字符”到底是指底层的 16 位代码单元、Unicode 码点,还是人眼看到的真实字形。
在日常前端与 Node.js 开发中,“把字符串打散成字符数组”是一个高频操作,例如实现文字逐字打字机动画、敏感词高亮过滤、字符串倒序、统计字数或校验单字符规则。许多初学者最初接触的写法往往是 str.split('')。在处理 "hello" 或 "apple" 这样的纯英文字符串时,它表现得顺理成章;但在处理多语言环境、生僻汉字或移动端用户输入的 Emoji 表情时,这个老牌方法却会悄无声息地截断字符,产生难以排查的乱码与数据破坏。
一、字符拆分背后的三个抽象层次
要彻底掌握字符串拆分,首先要理解 JavaScript 字符串在内存底层的存储机制。由于历史原因,JavaScript 字符串内部是按照 UTF-16 编码序列 组织的。这种设计带来了一个直接结果:屏幕上看到的一个“字”,在底层内存中可能对应着不同数量的存储单位。
在 ECMAScript 规范与现代 Unicode 标准中,我们需要区分三个概念:
- UTF-16 代码单元(Code Unit):JavaScript 内存分配的基本步长,固定为 16 位(2 字节)。字符串的
length属性、索引访问str[0]以及str.charAt(0)统计的都是代码单元的数量。 - Unicode 码点(Code Point):国际 Unicode 字符集为世界上每个字符分配的全局唯一数字编号(形式如
U+0041、U+20BB7)。在U+0000到U+FFFF范围内的字符仅需 1 个代码单元即可存放;而超出该范围的辅助平面字符(如生僻字、绝大部分 Emoji),UTF-16 会使用两个 16 位单元组合表示,称为代理对(Surrogate Pair)。 - 用户感知字形簇(User-Perceived Character / Grapheme Cluster):指读者肉眼辨识出的一个独立书写符号。例如家庭表情
👨👩👧,虽然在视觉上是一个整体,但底层由“父亲 + 零宽连字符 + 母亲 + 零宽连字符 + 女孩”共 5 个 Unicode 码点复合而成,占用了整整 8 个 UTF-16 代码单元。
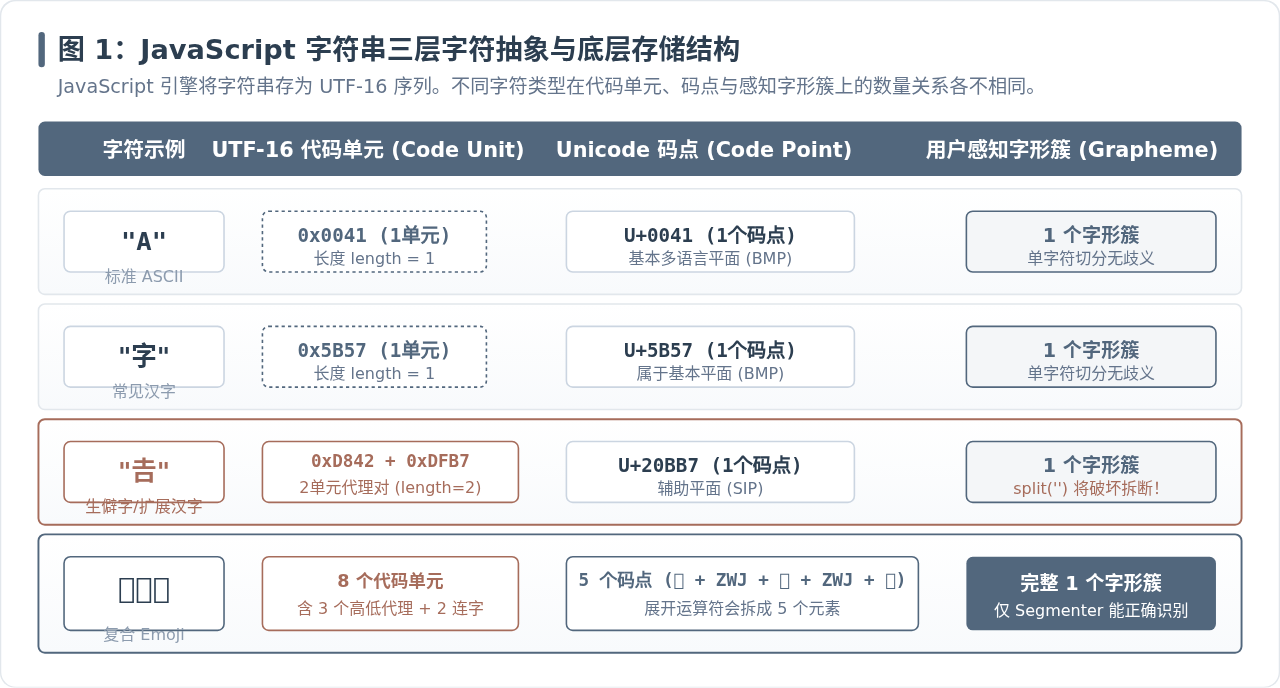
明白了这三个层次,我们就能清晰看懂不同拆分 API 的工作边界与返回结果的本质不同。
二、方案一:经典 str.split('') 与其边界陷阱
str.split('') 是在 ECMAScript 3 时代就已经确立的标准方法,也是在大量旧教程中最容易看到的写法。它的执行原理极其直接:以空字符串为分隔符,按照 UTF-16 代码单元 逐个截取。
1. 基础用法示例
// 基础 ASCII 英文与标点
const word = "vector";
const chars = word.split('');
console.log(chars);// 常见汉字(均属于基本多语言平面 BMP)
const phrase = "代码构建";
const hanChars = phrase.split('');
console.log(hanChars);2. 致命局限:截断代理对
当文本中出现超出 0xFFFF 范围的生僻字(如古籍汉字、人名专用字 "𠮷"),或者基础 Emoji 表情时,split('') 会在代理对的高位与低位之间直接切开,产生两个非法的孤立代理代码单元:
// 生僻字 "𠮷" 底层由 \uD842 和 \uDFB7 两个代理单元组成
const rareChar = "𠮷";
console.log(rareChar.length); // 输出: 2

const broken = rareChar.split('');
console.log(broken);
// 尝试对拆分后的单个元素重新编码或输出
console.log(broken.map(c => encodeURIComponent(c)));编码结果抛出 URIError: URI malformed 或产生不可逆的乱码问号
孤立的高位代理(High Surrogate)或低位代理(Low Surrogate)不是合法的 Unicode 字符。若将这种被 split('') 切割后的碎片存入数据库、传递给后端接口或调用 encodeURI(),会直接引发运行时异常或产生不可逆的黑菱形乱码。因此,除非百分之百确定字符串仅含纯 ASCII,否则不应在现代项目中随意使用 str.split('') 拆分字符。
三、方案二:展开运算符 [...str] 与 Array.from(str)
ECMAScript 2015(ES6)为 JavaScript 带来了内置的字符串迭代协议(String Iterator)。当使用 for...of、展开运算符 ... 或 Array.from() 遍历字符串时,JavaScript 引擎不会机械地步进 16 位,而是会主动检查当前代码单元是否属于高位代理范围(0xD800 ~ 0xDBFF)。如果是,引擎会自动抓取紧随其后的低位代理(0xDC00 ~ 0xDFFF),并将两者组合为一个完整的 Unicode 码点 输出。
1. 展开运算符 [...str] 的简洁写法
// 包含生僻字与基础单码点 Emoji
const greeting = "你好𠮷😀!";
const codePoints = [...greeting];

console.log(codePoints);
console.log(codePoints.length);数组长度:5(完美匹配实际码点数量)
2. Array.from(str, mapFn) 的边拆边转
Array.from() 在底层同样基于迭代器协议,但它额外支持传入一个映射函数作为第二个参数,省去先拆分成数组再调用 .map() 的双重内存分配:
const codeStr = "A𠮷B";
// 拆分的同时直接获取每个码点的十六进制表示
const hexList = Array.from(codeStr, char => {
  return 'U+' + char.codePointAt(0).toString(16).toUpperCase();
});

console.log(hexList);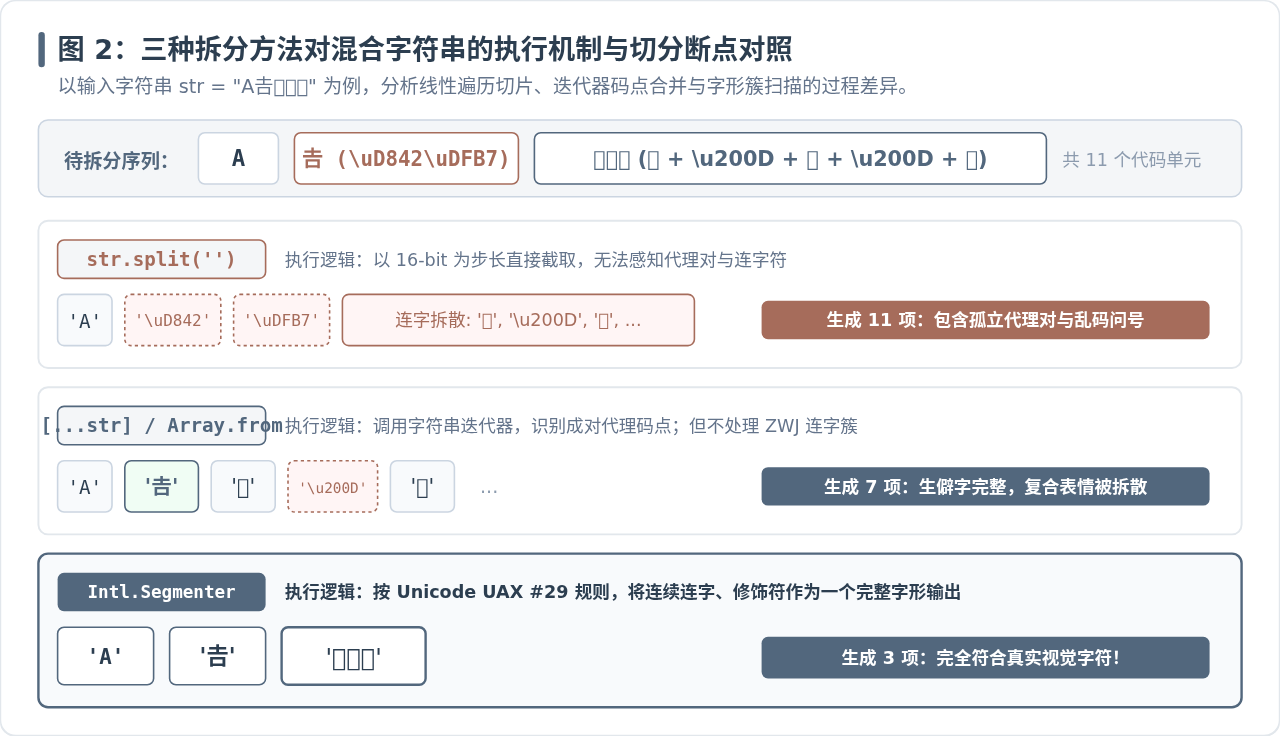
3. 展开运算符的边界局限
展开运算符虽然解决了代理对问题,但它的认知边界止步于单一 Unicode 码点。现代互联网交流中充斥着复杂的复合 Emoji 与组合重音符:
- 零宽连字符(ZWJ,
\u200D)组合:例如职业表情👩💻(女程序员)是由👩+\u200D+💻拼接的;家庭表情👨👩👧是由 3 个人物与 2 个连字符构成的。使用[...str]会将其拆解为多个独立部件。 - 肤色修饰符:例如
👍🏽是由基础大拇指👍(U+1F44D)与中等深色肤色修饰符(U+1F3FD)两个码点组合而成。[...str]拆分后会得到两个元素。 - 组合音符(Combining Diacritical Marks):例如德语或法语字母
é,有些文本并非存储为单码点é(U+00E9),而是由基底字母e(U+0065)加上重音符́(U+0301)组合而成。
// 复合 Emoji 被拆散示例
const family = "👨👩👧";
console.log([...family]);
// 输出: ['👨', '\u200D', '👩', '\u200D', '👧']
// 连字符被拆成孤立的不可见字符,破坏了原始视觉符号四、方案三:现代标准 Intl.Segmenter(按真实字形簇拆分)
为了从根本上解决全球多语言文字与复合 Emoji 的切分难题,ECMAScript 在 ES2022(以及 ECMA-402 国际化规范)中正式引入了 Intl.Segmenter API。它严格遵循 Unicode 联盟发布的 UAX #29(Unicode 文本分块算法),能够从算法层面精准识别人眼所见的扩展字形簇(Extended Grapheme Cluster)。
1. 完整使用代码
利用 Intl.Segmenter 将字符串按单个字形拆分为数组的标准做法如下:
/**
* 将任意复杂的 JavaScript 字符串安全拆分为单字符(字形簇)数组
* @param {string} str 输入字符串
* @param {string} locale 语系代码,默认 'und' (未指定/通用) 或 'zh-CN'
* @returns {string[]} 拆分后的字形数组
*/
function splitIntoGraphemes(str, locale = 'und') {
// 1. 创建指定粒度为 grapheme 的分块器实例
const segmenter = new Intl.Segmenter(locale, { granularity: 'grapheme' });
// 2. 对字符串进行断词扫描
const segments = segmenter.segment(str);
// 3. 提取每个分块的 segment 文本
return Array.from(segments, item => item.segment);
}
// 针对极端复杂的文本进行测试
const complexText = "A 𠮷 👨👩👧 👩💻 👍🏽 e\u0301";
const result = splitIntoGraphemes(complexText);
console.log(result);
console.log(`视觉字符数: ${result.length}`);视觉字符数:11(复合表情、肤色变体、组合重音符均完美保持为单元素,无任何破碎)
2. 运行环境与兼容性
Intl.Segmenter 属于原生 JavaScript 标准 API,无需引入任何第三方 NPM 包。其运行环境支持情况如下:
- Node.js:16.0.0 及以上版本完全原生支持。
- Chrome / Chromium Edge:87 及以上版本(2020年底即已支持)。
- Safari / iOS WebKit:14.1(macOS Big Sur 升级版)及 iOS 14.5 以上。
- Firefox:125 及以上版本全面支持。
在所有主流现代浏览器与服务端运行环境中,Intl.Segmenter 已经是成熟、推荐且最高标准的字符拆分方案。
五、方案四:使用 Unicode 正则表达式匹配
如果需要在较旧的环境中运行,或者无法使用 Intl.Segmenter,可以通过配置了 Unicode 标志的正则表达式来提取单字符。
ES6 引入了 u(Unicode)标志,使得正则表达式中的点号 . 能够正确匹配一个完整的 Unicode 码点,而不是单个代码单元:
function splitByRegex(str) {
  // u 开启码点感知模式,s 允许匹配换行符,g 全局匹配
  return str.match(/./gus) || [];
}

const res = splitByRegex("字𠮷😀");
console.log(res);该正则的效果等同于 [...str]。而如果需要匹配复合 Emoji,过去开发者常编写极长、极其复杂的代理范围正则表达式;在 ES2024 中引入了 v(Unicode Sets)标志,允许结合 \p{RGI_Emoji} 属性来匹配合法的 Emoji 序列,但由于该语法较新且较为繁复,在现代业务中优先建议直接使用 Intl.Segmenter。
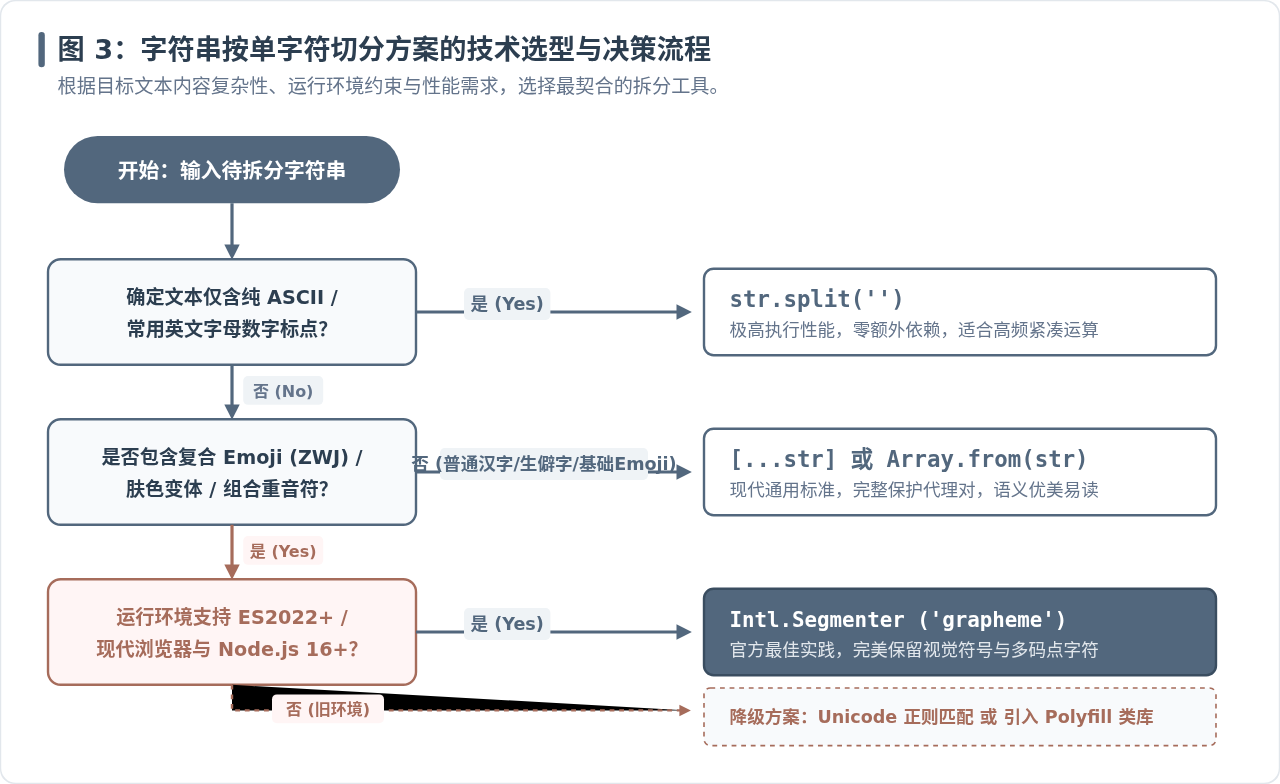
六、四种方案的特性全景对比与工程选型建议
综合以上分析,我们在工程实践中到底该选择哪种方式?下表与图示从不同维度对各方案做出了全面概括:
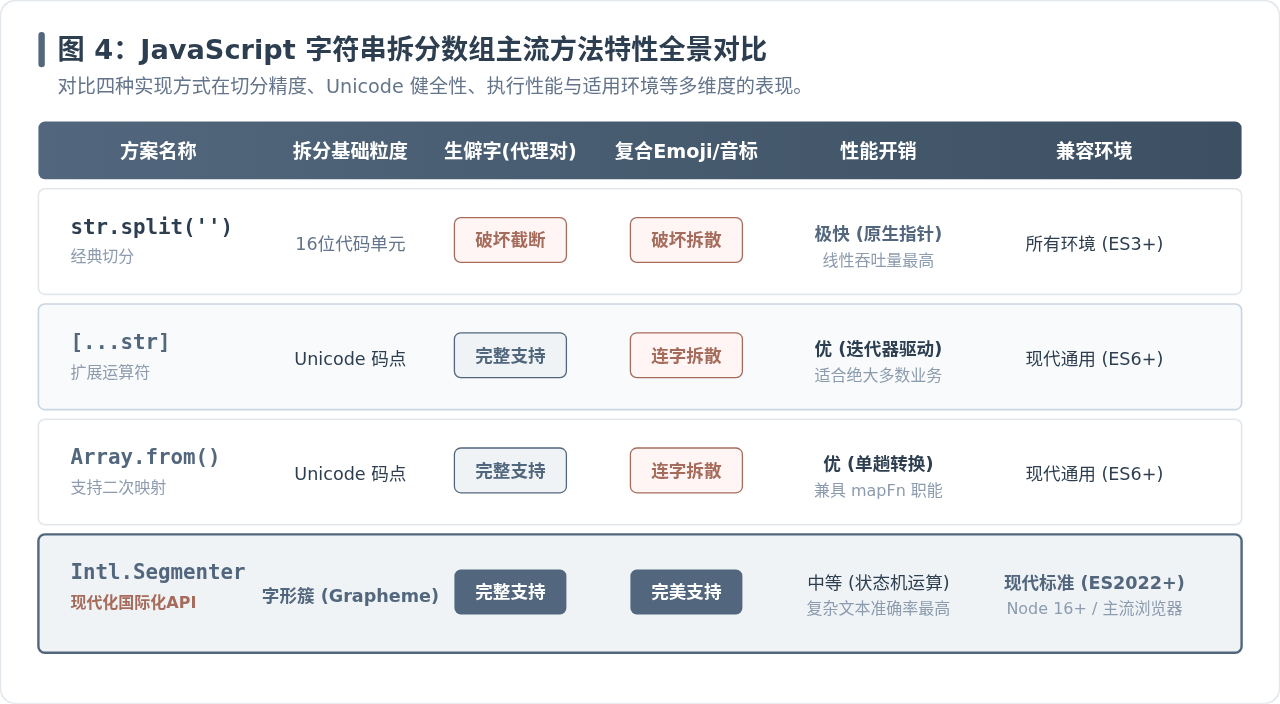
实战场景选型法则
-
纯内部协议与固定编码格式(如 Base64、Hex、UUID、ASCII 报文):
毫不犹豫选择str.split('')。由于数据严格限定在 7 位或 8 位 ASCII 字符集内,没有任何 Unicode 代理对风险,split('')拥有 V8 引擎最极致的底层指针优化,在十万级甚至百万级高频切片计算中性能最高。 -
常见中文网页内容、常规业务表单与用户昵称:
首选展开运算符[...str]或Array.from(str)。语法极为精炼现代,对绝大多数汉字、英文、生僻字(如古籍地名、证件专用字)以及基础点赞表情均能安全处理,兼顾了极高的开发体验与良好的性能。 -
社交动态、评论输入框字数统计、IM 聊天表情渲染、复杂多语言排版:
必须选择Intl.Segmenter。移动端键盘输入包含大量带有连字(ZWJ)、肤色修饰符、性别符号的复合 Emoji,以及泰文、印地文或组合音标等复杂文字。唯有Intl.Segmenter能够忠实还原用户在屏幕上所见的一个个独立字符,彻底杜绝打字机动画撕裂、字数截断半个表情导致乱码等顽固缺陷。
JS动态构建复杂嵌套JSON对象的方法
2026-11-05 15:41:52
JS负数取余为什么是负数?详解余数与模运算区别
2026-11-05 13:34:41
JS 解压出现乱码或报错怎么解决?
2026-11-05 12:32:38
JS 中 startsWith、indexOf 与正则判断字符串前缀的对比
2026-11-04 22:19:43
JS解析Excel后怎么将数据转换为JSON格式
2026-11-04 20:58:28
相关标签:







